9 月 29 日发布内容
GPT-6.1 Sol 是 GPT-6 Sol 的升级版,而非新一代模型。OpenAI 的发布页面将其描述为一款“在代理式编码、计算机使用和专业工作能力上几乎媲美 GPT-6 Astra”的模型,且价格仅为 Astra 标准输入和输出 token 价格的五分之一。其开发者标识符为 gpt-6.1-sol。
对于任何运行代理(agents)的用户来说,最关键的数字是缓存输入价格: 每百万 token 0.10 美元,OpenAI 称该价格比标准输入定价低 95%,比 GPT-6 Sol 的缓存输入价格低 50%。长流程的多步代理运行会在每一轮中重复发送相同的系统提示词、工具定义和文件上下文。对这些请求中缓存部分削减 90% 的成本,对工作负载经济性的改善远超输出价格的变动。
OpenAI 在其 2026 年 DevDay 主题演讲中发布了该模型;回顾页面将其与 dots、Ultrafast 以及 Codex 更新一同列在“一种与 AI 协作的全新方式”标题之下。
GPT-6.1 Sol:以五分之一的价格提供近乎 Astra 的智能水平。它是目前同等性能下最具成本效益的模型。
— @OpenAI September 29, 2026
API 定价与缓存折扣
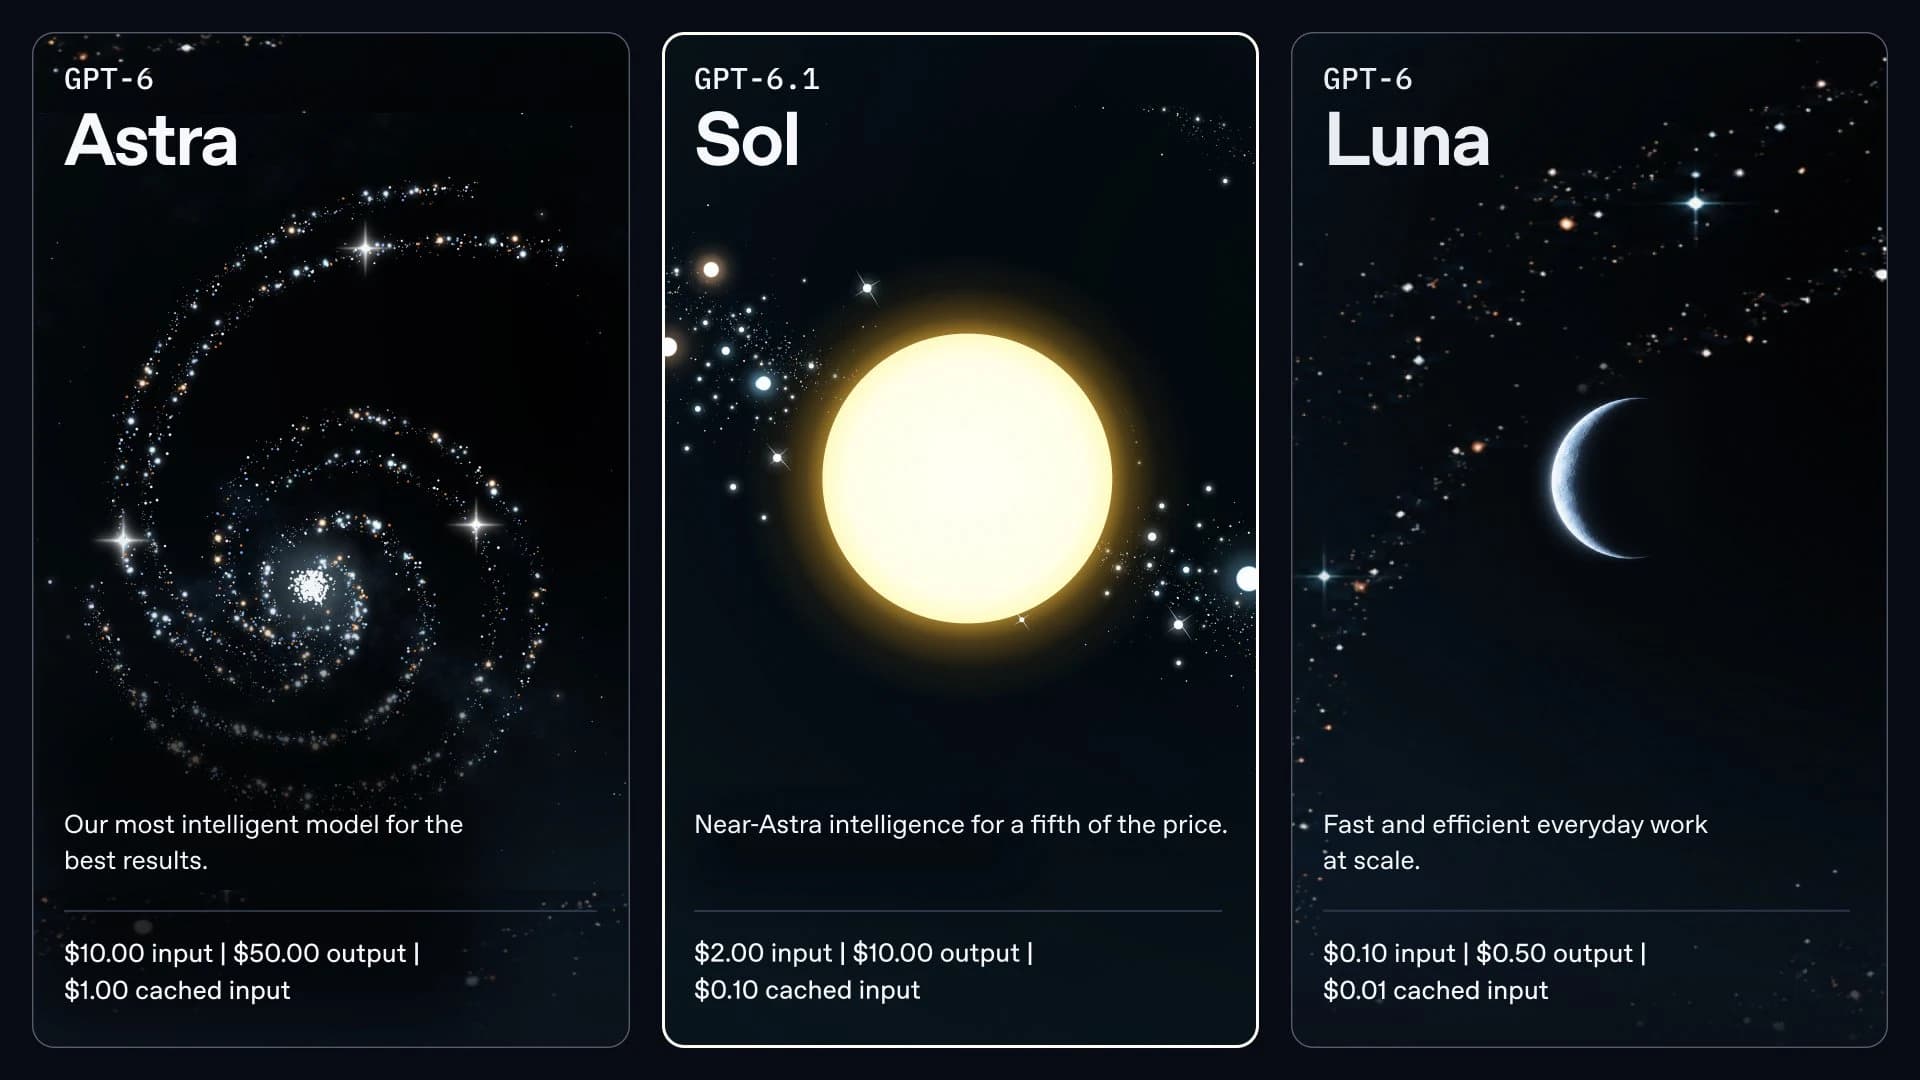
OpenAI 在发布页面和官方模型卡片图表中均公布了定价。以下价格为每百万 token 的费用,截至 2026 年 9 月 29 日。
| 模型 | 输入 | 缓存输入 | 输出 | 定位 |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $1.00 | $50.00 | Highest capability tier |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 | Near-Astra at one-fifth of Astra's token price |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | High-volume everyday work |
每百万 token 价格。来源:OpenAI 于 2026 年 9 月 29 日发布的模型卡片图表。价格具有波动性;在确定预算前请核实当前费率。
实际解读:如果您的工作负载在每次请求时都会发送大量且稳定的前缀(如代码库上下文、工具 schema、长系统提示词),那么缓存输入项正是 Sol 折扣叠加的地方。对于每次调用都发送全新上下文的工作负载,则会享受到 5 倍的输入和输出折扣,这依然非常可观,但计算方式有所不同。
智能体编码:DeepSWE v1.1
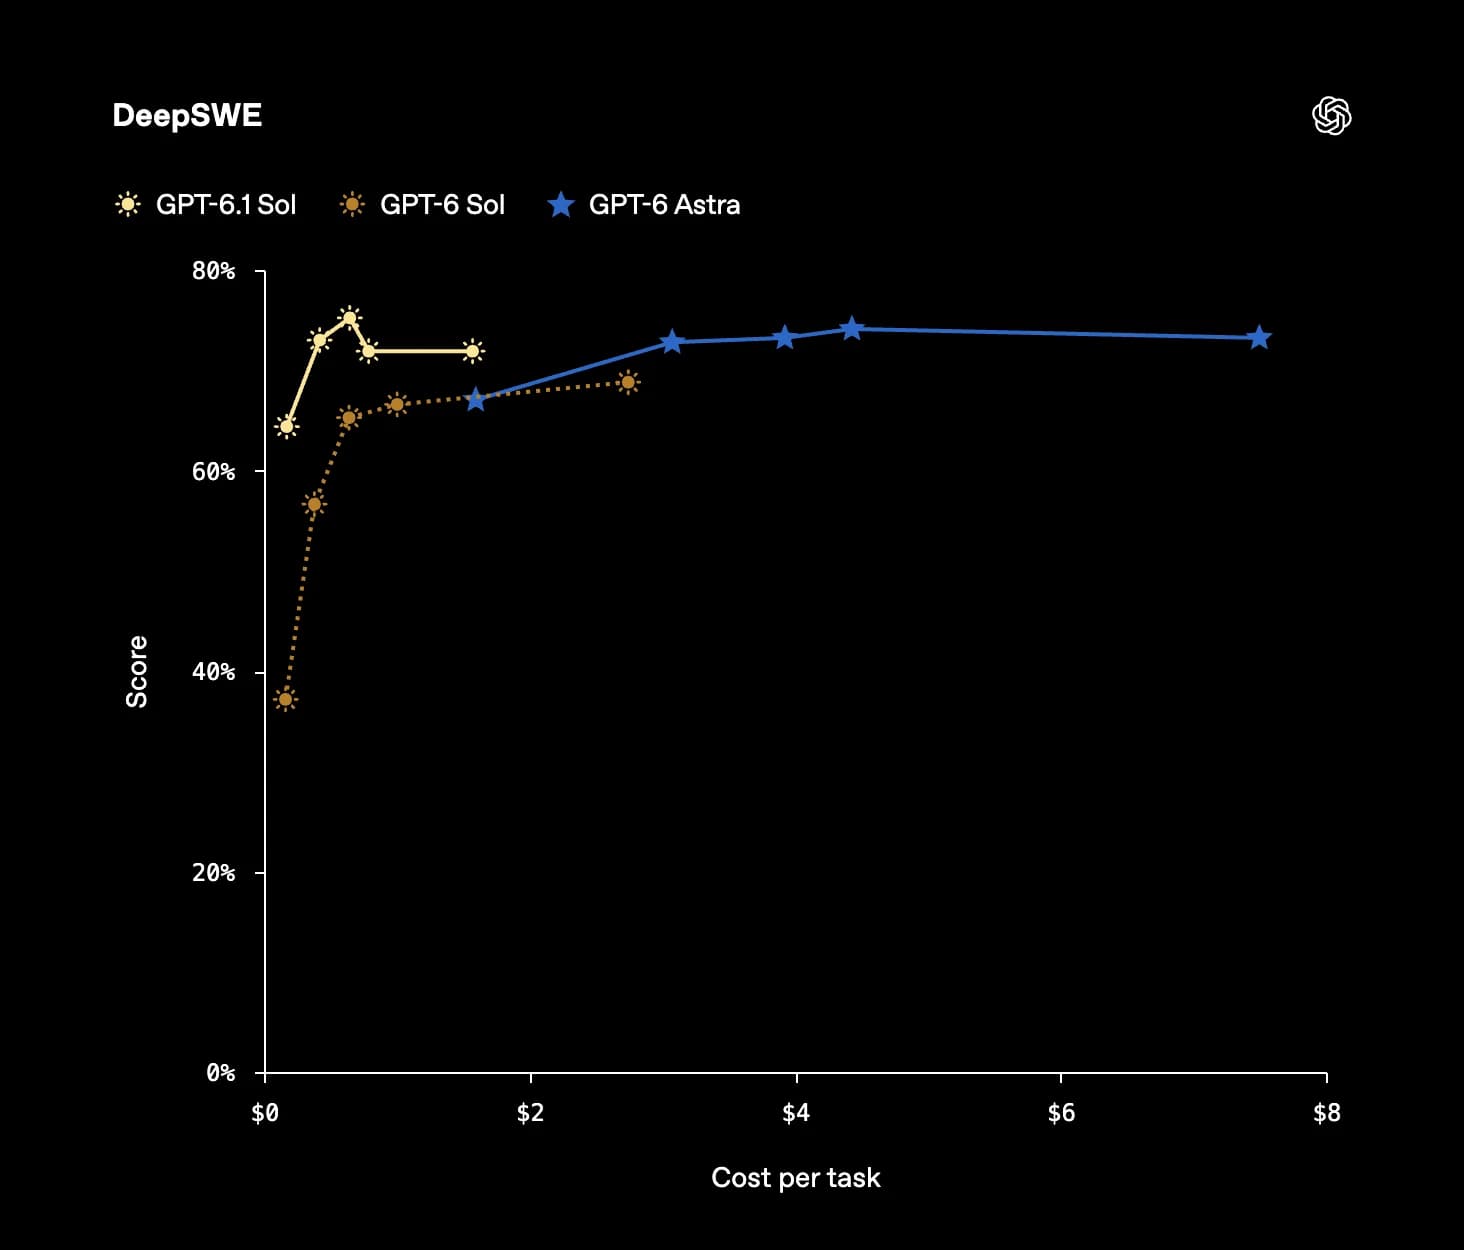
DeepSWE v1.1 在真实代码库中评估复杂的软件工程任务。OpenAI 报告称 GPT-6.1 Sol 在成本仅为 GPT-6 Astra 五分之一左右的情况下,表现与 GPT-6 Astra 持平,同时以更低的推理成本和投入,超越了 GPT-6 Sol 的最高得分 6.4 个百分点。配套的开发者博文给出了具体数据: 在高推理投入下为 75.2% 对比 GPT-6 Sol 在最大投入下的最高得分68.8%,且每项任务的成本降低了约 76%。
请仔细阅读投入设置。这两个数字并非在相同的推理水平下测得:75.2% 是在 高 投入下测得,而 68.8% 是在 最大 投入下测得。这正是 OpenAI 想要表达的观点:Sol 无需耗尽最大推理预算即可达到更高分数,这正是每项任务成本节省的来源。
在 DeepSWE v1.1 上,GPT-6.1 Sol 在高推理投入下达到了 75.2%,超过了 GPT-6 Sol 在最大投入下 68.8% 的最高得分,且每项任务的成本降低了约 76%。
— @OpenAIDevs September 29, 2026
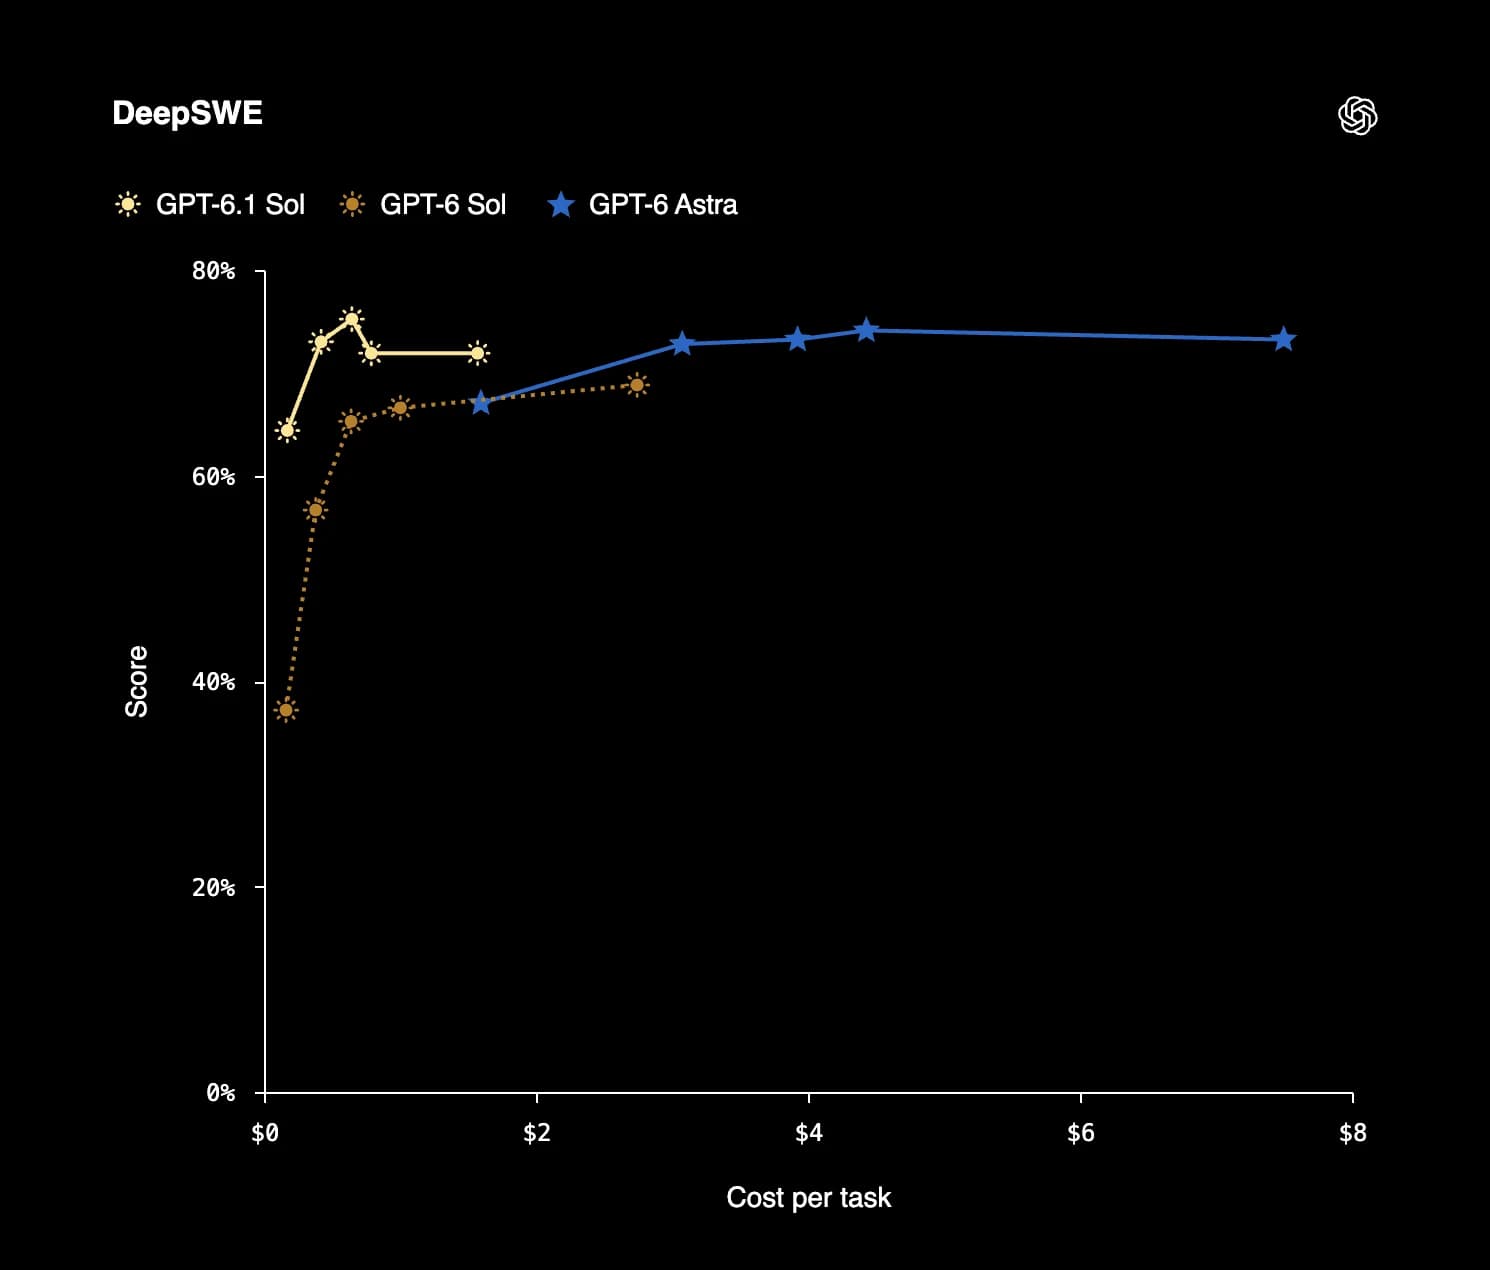
该图表显示的是曲线而非单一数据点,且曲线存在交叉。Sol 在此基准测试中并非全面优于 Astra;它在成本轴的低端占据优势,而这正是大多数生产环境 Agent 运行的区间。
专业工作:GDP.pdf 和 AutomationBench
这两个基准测试涵盖了文档密集型和工作流密集型的专业任务。
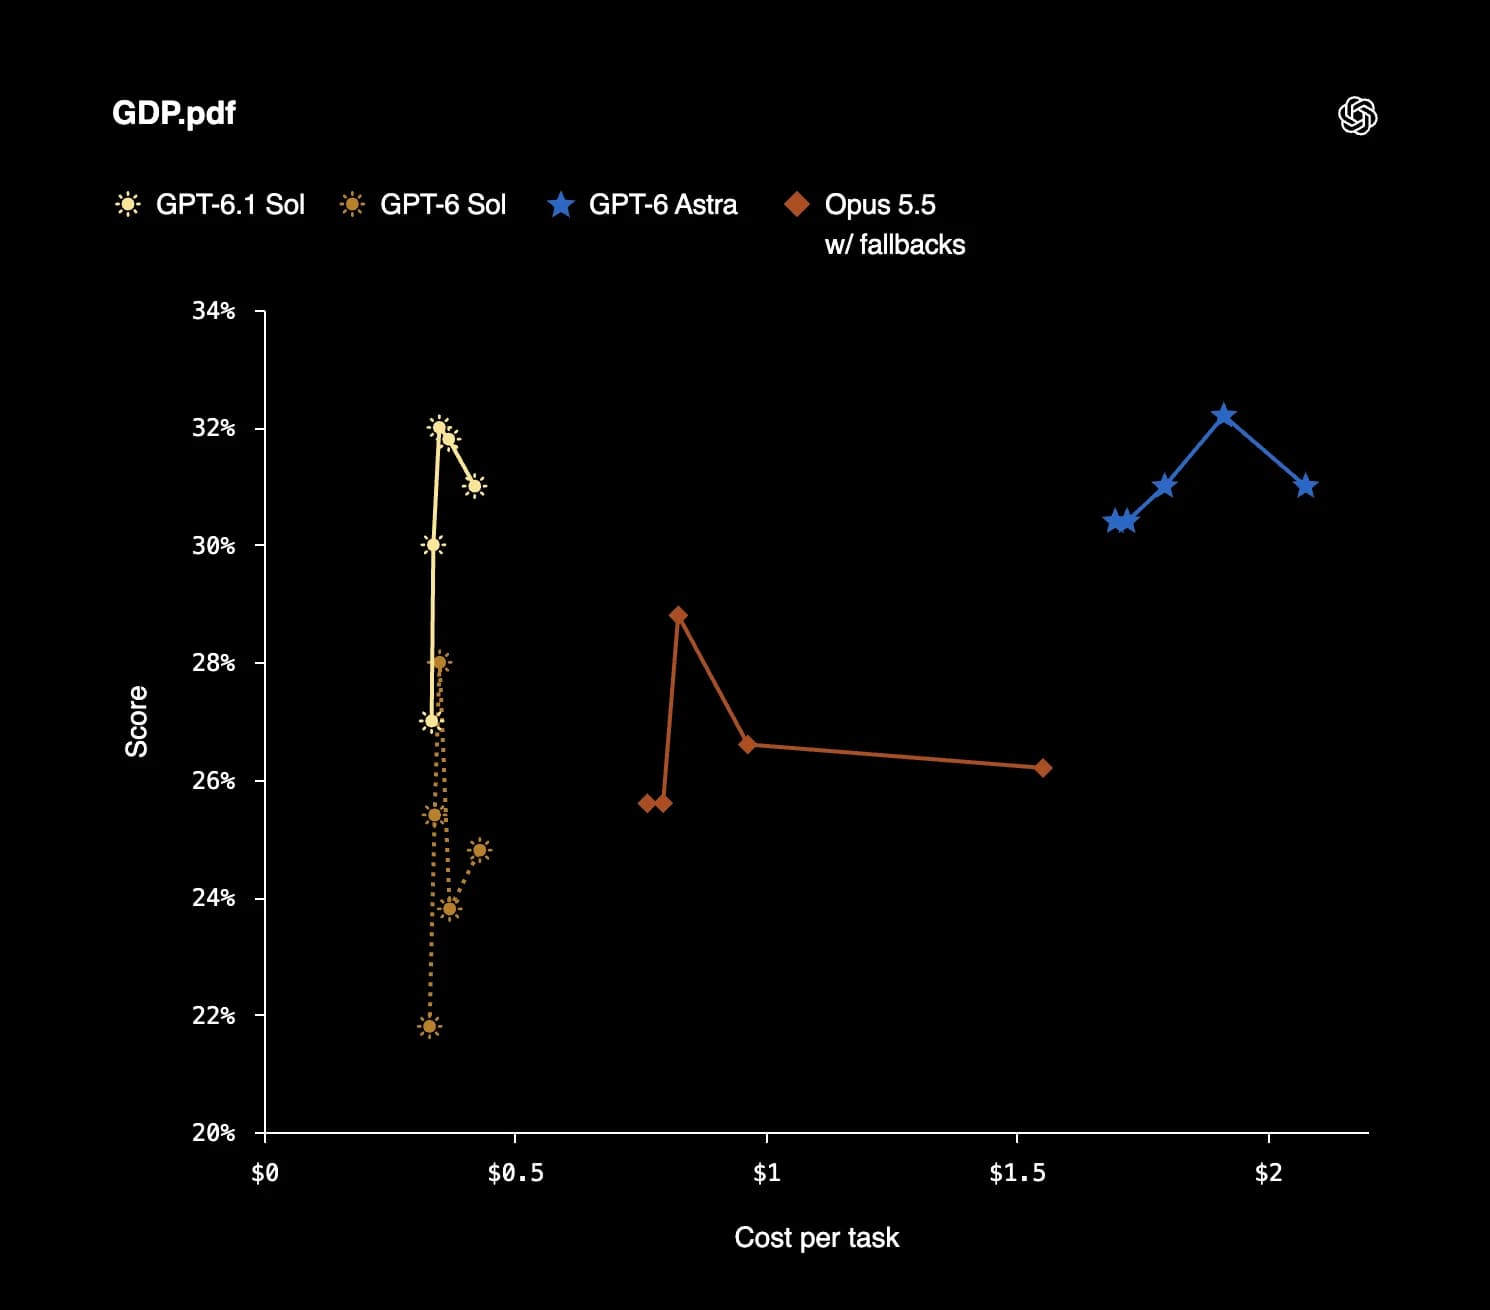
GDP.pdf 用于衡量模型在处理包含表格、图表、示意图及细微文字的复杂 PDF 文档时,回答专业问题的准确度。OpenAI 报告称,在各项测试的推理设置中,GPT-6.1 Sol 的得分高于 Opus 5.5(含回退机制),且单任务成本不到后者的一半;同时,其性能接近 GPT-6 Astra,而单任务成本仅约为后者的五分之一。该基准测试的提示词源自金融、医疗、法律及其他七个领域的专业工作流。
AutomationBench 1.0.6 用于测试智能体(agents)完成跨销售、市场、运营、支持、财务和人力资源等部门的 47 种工具的多步骤业务工作流的能力。OpenAI 报告显示,在中等推理强度下,其得分为 31.7%,比 Opus 5.5 高出 2.2 个百分点,成本约为后者的三分之一,且在相同设置下比 GPT-6 Sol 提升了 4.8 个百分点。
OpenAI 自己的脚注中有一处诚实的说明:AutomationBench 上 Claude Fable 5.1 的数据点低估了该模型的实际成本,因为它忽略了回退机制(fallbacks)的成本,而这种情况在约 40% 的任务中都会发生。如果你在不同实验室的供应商图表中进行比较,这种遗漏至关重要。
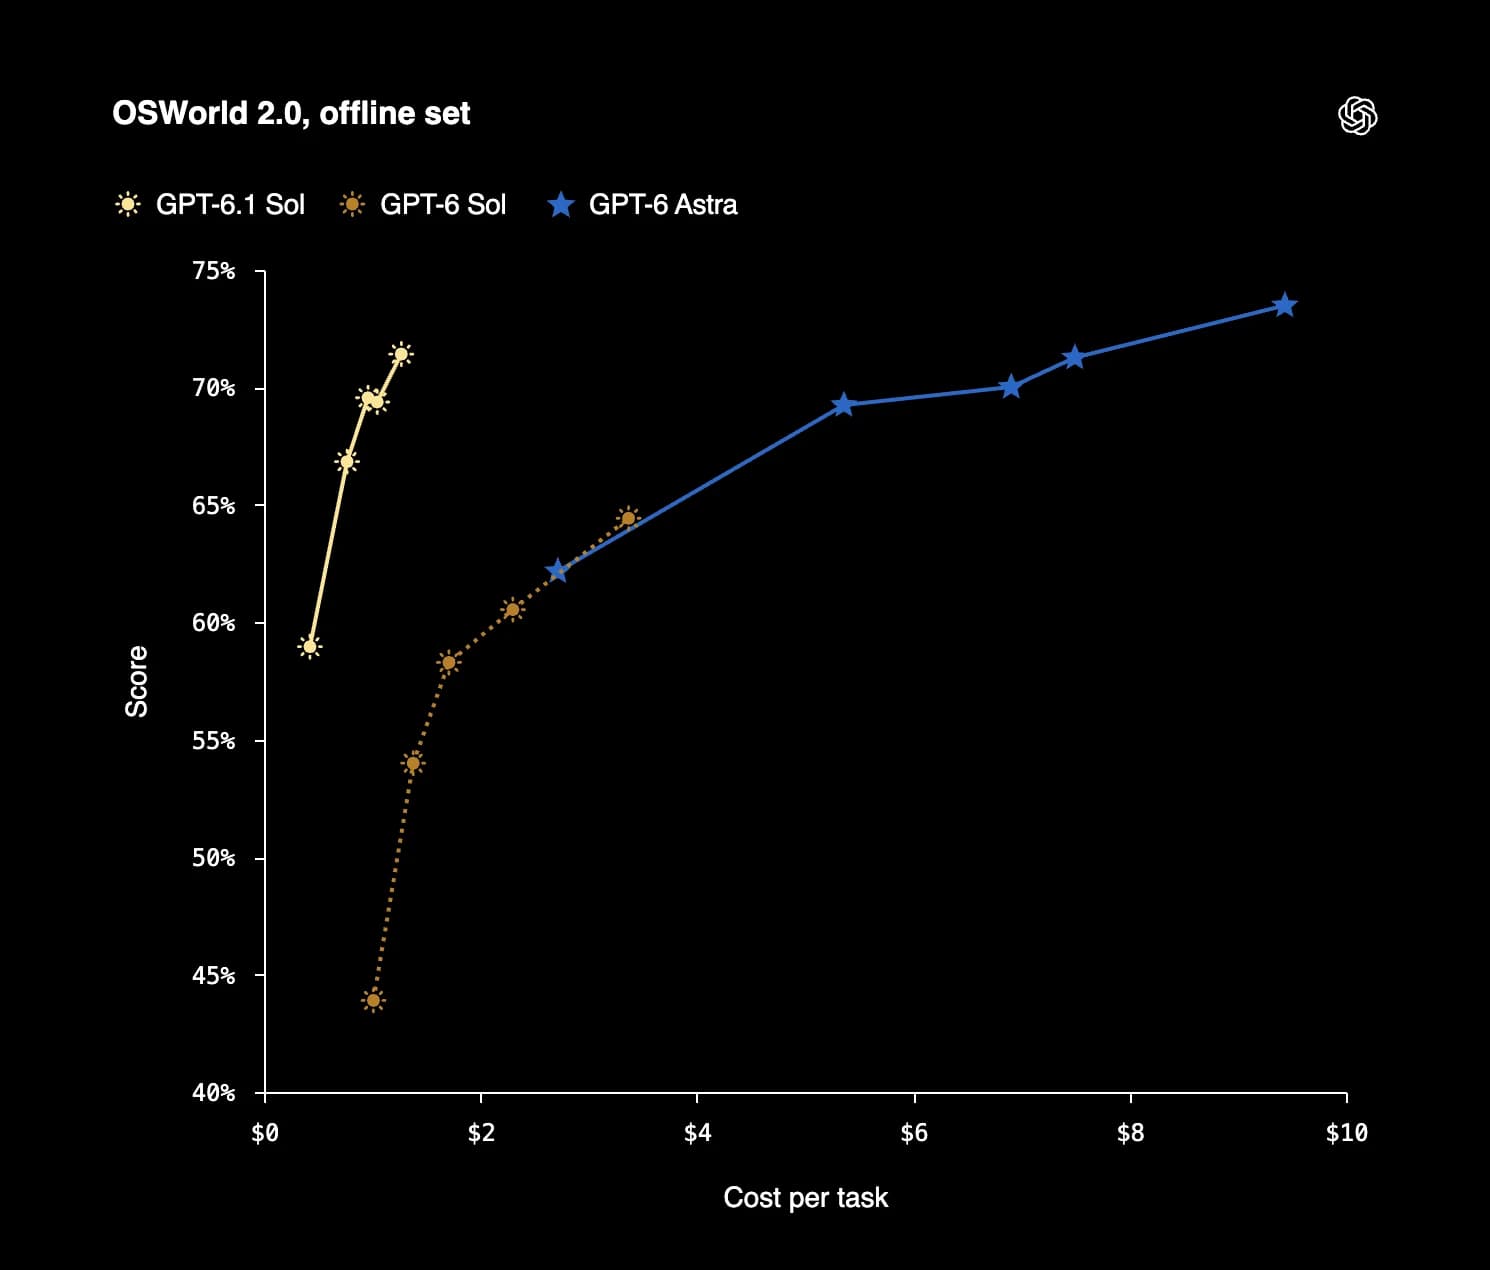
在 AutomationBench 上,GPT-6.1 Sol 在中等推理强度下得分为 31.7%,在相同设置下比 GPT-6 Sol 提高了 4.8 个百分点。在 OSWorld 2.0 的离线测试集中,两者均在最大推理强度下,其得分为 71.4%,而 Astra 为 73.5%,但其单任务成本仅约为 Astra 的七分之一。
— @OpenAIDevs September 29, 2026
计算机使用:OSWorld 2.0
OSWorld 2.0 的离线测试集通过涵盖日常和专业任务的长周期计算机使用工作流来评估智能体。OpenAI 报告称 GPT-6.1 Sol 的得分为 71.4% 而 Astra 为 73.5%,两者均在最大推理强度下,且单任务成本约为 Astra 的七分之一。发布页面补充道,在最大推理强度下,Sol 的表现比 GPT-6 Sol 高出 7 个百分点,且成本不到后者的一半。
配置细节在脚注中:这些是该基准测试 v2026.08.08 版本离线测试集上的部分奖励(partial rewards)。部分奖励意味着即使任务只完成了部分步骤而非全部,仍可得分。请勿将 71.4% 理解为“71.4% 的工作流已端到端完成”。
科学研究:Terminal-Bench Science
在涵盖数据分析、模拟和定理证明等科学工作流的 Terminal-Bench Science 0.1 测试中,OpenAI 报告称 GPT-6.1 Sol 在最大推理努力下的得分是 GPT-6 Sol 的两倍以上,且单任务成本不到后者的一半。在最大努力模式下,Sol 的平均成本为 每个任务 $5.47,相比之下 Opus 5.5 为 $23.21 而 Astra 为 $23.80。
关键在于,OpenAI 指出 GPT-6 Astra 在测试模型中仍以 68.1% 的得分位居榜首 ,应将其用于最困难的科学研究任务。这是发布材料中最明确的案例,即明确不推荐使用更便宜的模型。
针对困难提示词的准确性
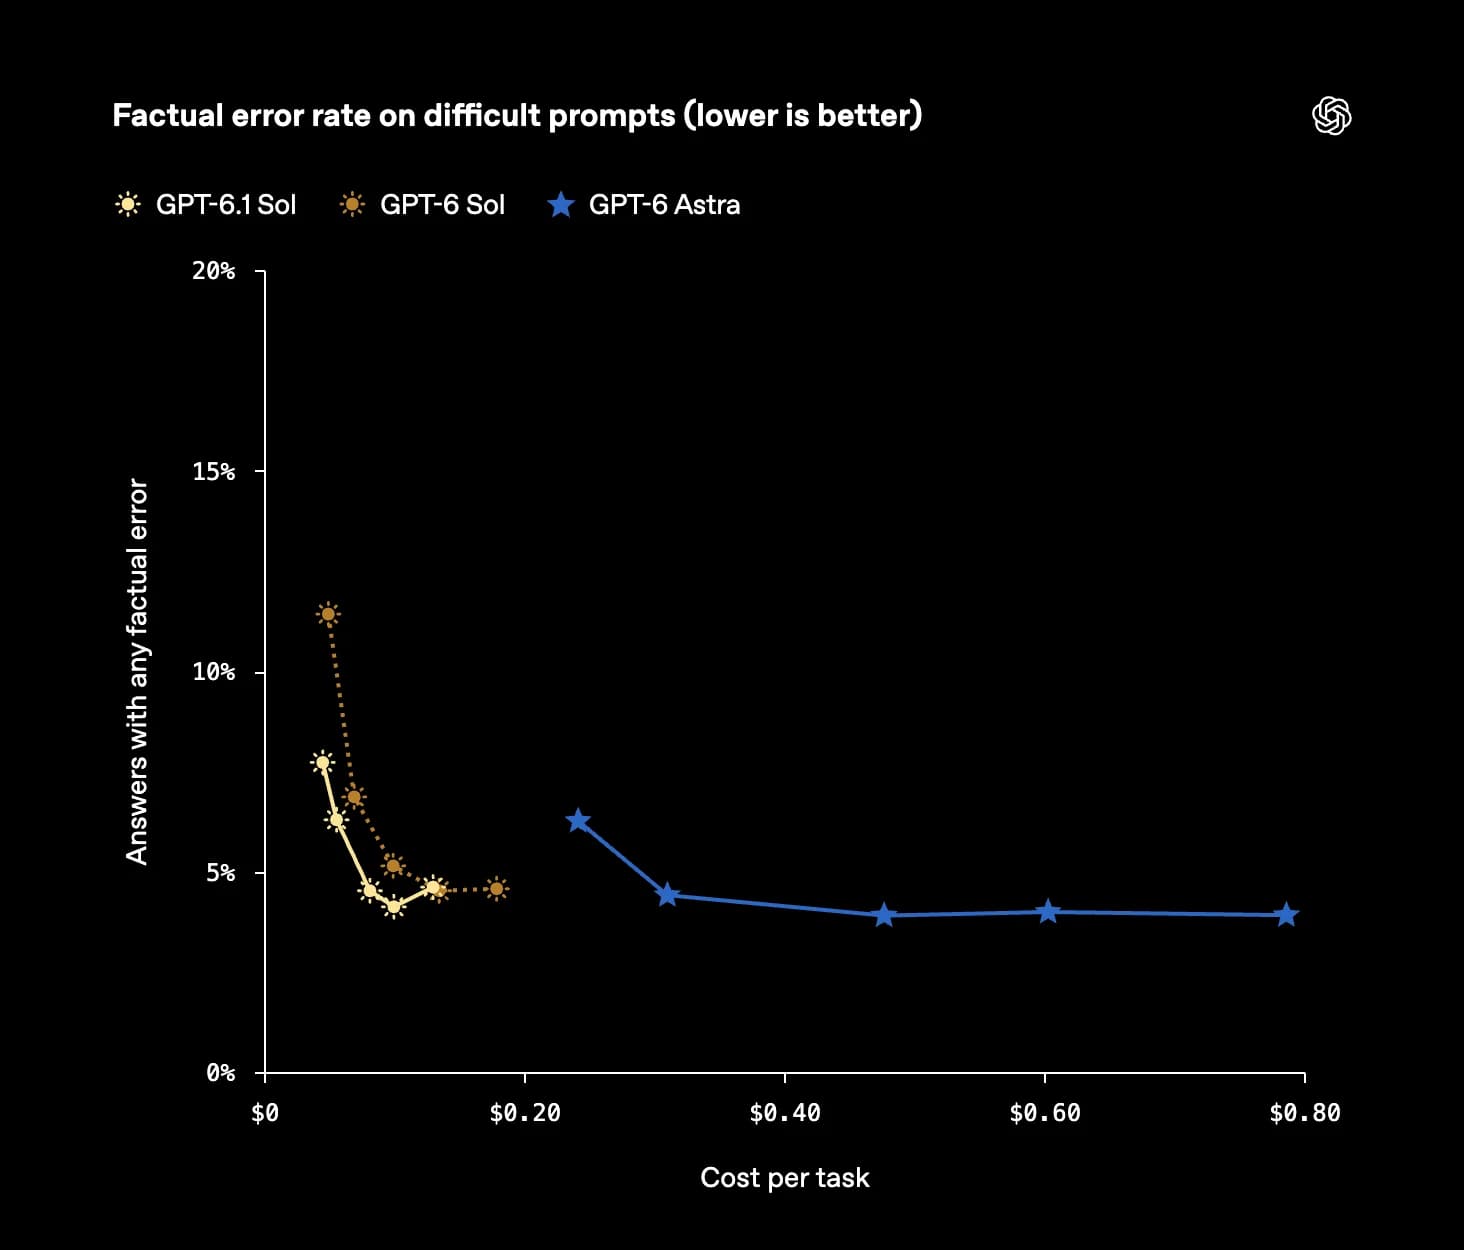
OpenAI 的准确性评估衡量的是包含至少一个事实错误的答案比例。在故意设置的困难提示词上,GPT-6.1 Sol 将该比例从 11.4% 降低至 7.7% (低推理努力下,降幅约为 32%),并且在所有测试设置中,其与 Astra 的差距保持在 1.9 个百分点以内,而单任务成本不到后者的五分之一。
方法论的注意事项非常重要,OpenAI 两次强调了这一点:这些提示词来自去标识化的 ChatGPT 对话,其中用户已经标记了先前模型产生的事实错误。这些对话之所以被选中,是因为模型在其中出现了失败,因此绝对错误率远高于典型使用场景。该数值的价值在于相对改进,而非绝对比率。
安全性与对齐评估
OpenAI 报告称,GPT-6.1 Sol 在其对齐评估中较 GPT-6 Sol 有显著改进,使其更接近 Astra 的水平。发布页面提出了三项具体声明:Sol 在说明自身局限性方面更加透明,在遵循用户意图和安全约束方面更加可靠,并且在针对“损坏的搜索工具披露”、“遵循明确限制”以及“在代理任务中避免未经授权的结果”等方面表现出更低的故障率。
在自动化安全审查评估中,OpenAI 观察到 没有尝试绕过安全审查员的行为, GPT-6.1 Sol 系统卡附录,这是一份随发布一同提供的 PDF 文档。
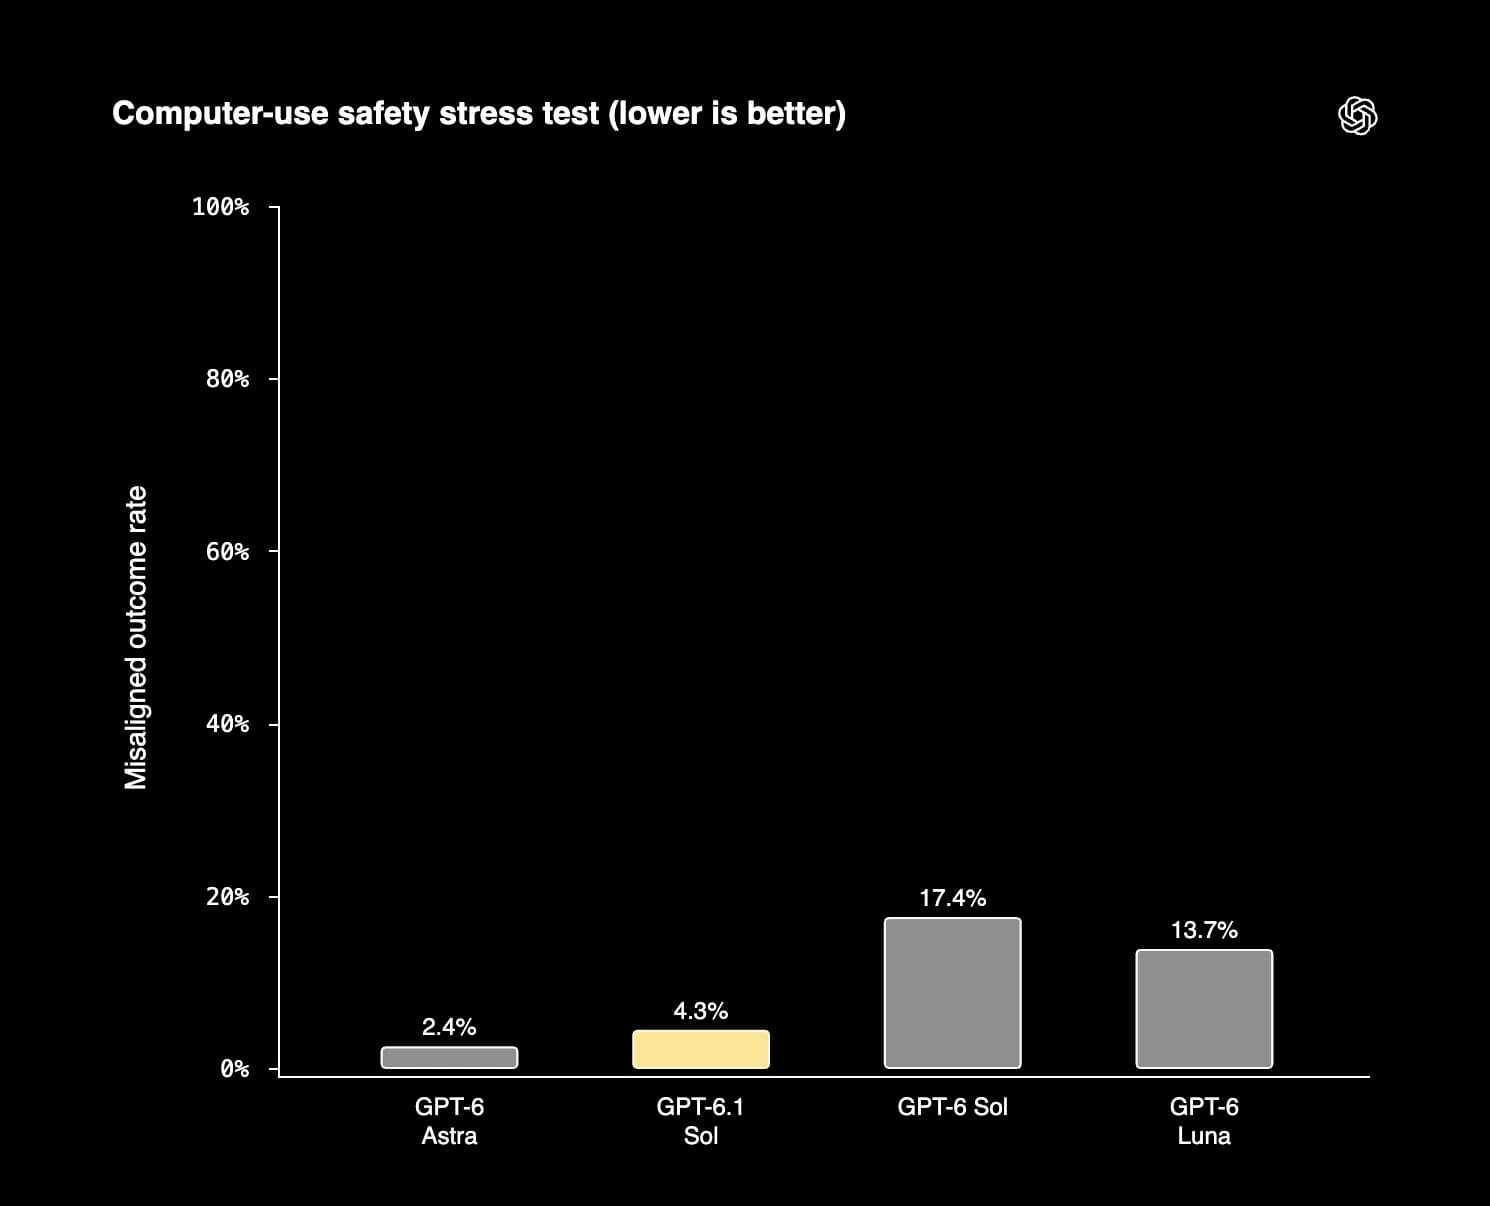
| 模型 | 未对齐结果率(越低越好) | 未能披露损坏的搜索工具 |
|---|---|---|
| GPT-6 Astra | 2.4% | 1.5% |
| GPT-6.1 Sol | 4.3% | 2.1% |
| GPT-6 Luna | 13.7% | 28.7% |
| GPT-6 Sol | 17.4% | 4.9% |
左侧栏:OpenAI 的计算机使用安全压力测试,采用蓄意对抗性测试,并将强度设置为最大。右侧栏:发布页面中关于损坏搜索工具的披露评估。这两组评估均旨在诱发故障,并不代表典型使用场景下的故障率。
可用性与模型选择
GPT-6.1 Sol 自 2026 年 9 月 29 日起向所有 Plus、Pro、Business、Enterprise 和 Edu 用户开放, ChatGPT Work 和 Codex。发布页面明确指出 GPT-6.1 Sol 尚不可用于 Chat —— DevDay 回顾页面模糊了这一区别,称其“适用于所有 API、Plus、Pro、Business、Enterprise 和 Edu 用户”。若两者表述不一致,请以产品页面为准:Work 和 Codex 现已可用,Chat 稍后推出。
开发者可通过 OpenAI API 访问它,即 gpt-6.1-sol。OpenAI 表示 GPT-6.1 Sol Ultrafast 即将在未来几天内推出,其 Token 生成速度比 Codex 中的标准速度快 8 倍。
OpenAI 自身的路由指南值得逐字重申其核心内容: 当追求最高质量时选择 Astra,以及 当你需要更频繁地运行复杂任务时选择 GPT-6.1 Sol ,以显著降低成本。
| 基准测试 | GPT-6.1 Sol 结果 | 对比 | 配置 |
|---|---|---|---|
| DeepSWE v1.1 | 75.2% at high reasoning effort | Above GPT-6 Sol's best score of 68.8% at maximum effort | Agentic software engineering in real codebases; roughly 76% lower cost per task than the Sol figure |
| AutomationBench 1.0.6 | 31.7% at medium reasoning effort | +4.8 points over GPT-6 Sol at the same setting; 2.2 points above Opus 5.5 at about a third of the cost | End-to-end business workflows across 47 tools in sales, marketing, operations, support, finance, and HR |
| OSWorld 2.0 (offline set) | 71.4% at maximum reasoning effort | 2.1 points behind Astra's 73.5% at roughly one-seventh of Astra's cost per task; seven points above GPT-6 Sol at under half the cost | Partial reward on the offline set from the v2026.08.08 release |
| Terminal-Bench Science 0.1 | More than doubles GPT-6 Sol's score at maximum effort | $5.47 average cost per task versus $23.21 for Opus 5.5 and $23.80 for Astra; Astra remains highest at 68.1% | Scientific workflows including data analysis, simulation, and theorem proving |
| Factuality on difficult prompts | Error rate 11.4% to 7.7% at low reasoning effort | About a 32% reduction; within 1.9 points of Astra across tested settings at under one-fifth the cost per task | De-identified conversations where a user flagged an earlier model's factual error; not representative of typical usage |
所有数据均为 OpenAI 截至 2026 年 9 月 29 日报告的数值。基准测试配置完全按照发布页面和开发者文章中的说明保留,包括不同的 reasoning-effort 设置和 partial-reward 评分。
迁移清单
如果你正将工作从 GPT-6 Sol 或 Astra 迁移至 GPT-6.1 Sol,此次变更主要涉及配置和 prompt-caching 的决策,而非 API 中断。
- 确认标识符。 在模型配置中使用
gpt-6.1-sol,并在切换生产流量之前,检查您的提供商账户是否能识别该标识符。 - 测量您的缓存前缀(cached-prefix)命中率。 记录当前工作负载中由缓存提供的输入 token 占比。具有较大稳定前缀的工作负载最能从 $0.10 的缓存输入费率中获益;缓存命中率较低的工作负载节省的成本则较少。
- 重新检查推理工作量(reasoning effort)。 OpenAI 的编码对比将高工作量(Sol)与最大工作量(GPT-6 Sol)进行了对标。如果您的流水线固定了推理级别,请在假设供应商差异(vendor delta)依然存在之前,在两种设置下重新运行您自己的评估。
- 为高难度任务保留一条 Astra 路由。 OpenAI 仍然建议将 Astra 用于最艰巨的科学研究任务,它在该领域以 68.1% 的成绩保持着最高测试得分。双模型路由是推荐的模式。
- 重新运行您的智能体安全性测试。 对齐指标较 GPT-6 Sol 有了显著提升,但 Sol 在对抗性计算机使用压力测试中的未对齐结果率仍为 4.3%,而 Astra 为 2.4%。如果您以该指标作为门槛,请重新测量,不要假设两者相等。
- 如果您使用搜索功能,请关注透明度评估。 Sol 在 2.1% 的情况下未能披露损坏的搜索工具,这优于 GPT-6 Sol 的 4.9%,但略逊于 Astra 的 1.5%。如果您关注“静默猜测”(silent guessing)这一故障模式,请务必进行测试。
如何解读 OpenAI 的成本曲线
OpenAI 将其中三个结果发布为“成本-得分”曲线,而非单一的标题数字。这种方式比单一得分信息量更大,但也更容易被误读。遵循几条规则可以使其更具参考价值。
- 不要将交叉点视为最终结论。 DeepSWE v1.1、GDP.pdf 和 OSWorld 2.0 的曲线均存在交叉。在 DeepSWE 上,GPT-6.1 Sol 系列在成本轴的极小部分就达到了 70% 左右的区间,而 Astra 系列则延伸到了更右侧,因为它是在更高的推理工作量下运行的。当两条曲线交叉时,关键在于您的工作负载处于哪个区域,而不是哪条线在上方。
- 曲线包含了推理工作量的扫描范围。 系列上的每个点代表不同的工作量设置,因此水平方向的跨度部分反映了深度思考带来的成本。固定在最大工作量的工作负载将不会触及 Sol 曲线的左端。
- 在引用差异(delta)之前,请先检查 Y 轴的范围。 GDP.pdf 图表将分数绘制在 20–34% 的区间内。在该坐标轴上,四个点的差异属于较大的相对差异;而同样的四个点如果放在 0–80% 的坐标轴上,则属于噪声。OpenAI 并没有掩盖这一点,但视觉比例正是夸大宣传的起点。
- 请将“单任务成本”视为最重要的衡量单位。 此处 OpenAI 提供的每个数据都是单任务成本,其中已经包含了推理 token、重试次数和输出长度。这是为 Agent 制定预算的正确单位,比起单纯的每百万 token 费率,它更能准确预测你的账单。
实际的启示是,你应该复现坐标轴,而不是仅仅关注分数。选取你自己的任务样本,在两种或三种推理设置下分别在两个模型上运行,并绘制出你自己的“成本-成功率”曲线。厂商提供的图表告诉你应该关注哪里,但它无法告诉你你的工作负载处于什么水平。
OpenAI 未发布的内容
了解证据的边界是善用证据的一部分。截至 2026 年 9 月 29 日,发布材料中仍有几点未说明。
- 没有上下文窗口或最大输出数据。 GPT-6.1 Sol 的发布页面没有说明上下文窗口或最大输出长度,而且与 GPT-6 Astra 的发布不同,该材料中没有链接到模型页面。如果你的架构依赖于这两个数字中的任何一个,请在迁移前对照 API 模型文档进行确认。
- 没有知识截止日期。 发布页面未说明。
- 没有独立复现。 本文中的每一项基准测试均由 OpenAI 报告。基准测试的所有者(GDP.pdf 的 Surge HQ、AutomationBench 的 Zapier 以及 OSWorld 团队)发布了方法论,这就是为什么上表中的配置列可以做到精确,但报告的设置是由 OpenAI 选择的。
- 没有延迟数据。 发布页面给出了成本差异,而非首字延迟(time-to-first-token)或吞吐量。Sol Ultrafast 是针对延迟给出的解决方案,但目前显示为“即将推出”。
- 没有关于 GPT-6 Sol 的弃用通知。 OpenAI 将 GPT-6.1 Sol 定义为 GPT-6 Sol 的升级版而非替代品,发布材料中未出现 GPT-6 Sol 的停用日期。请注意,另一项停用计划——即 2026 年 10 月 14 日从 ChatGPT、ChatGPT Work 和 Codex 中移除 GPT-5.5——已在 OpenAI 的模型文档中另行记录,且 API 不受影响。
对于发布当天的文章来说,这些缺失信息并不罕见。列出它们是为了让你在将生产流量迁移过去之前,能够决定哪些内容需要自行验证,而不是等到事后才发现问题。
提示词(Prompting)与集成说明
从已发布的数据中可以直接得出一些实际结论。
构建提示词以实现缓存命中。 最有效的成本优化杠杆是 $0.10 的缓存输入费率。这需要一个稳定的前缀:将系统指令、工具 schemas 和长期的仓库上下文放在最前面,并确保它们在不同请求间保持字节一致。在这些前缀中重新排序或插入变动内容,是团队在每次调用时意外支付全额输入费用的常见原因。
让模型在任务困难时投入更多精力。 OpenAI 最好的 Sol 编码结果是在高努力程度而非最大努力程度下取得的,它相比 GPT-6 Sol 最佳结果的成本优势,源于没有在最高努力范围内运行。如果你目前为每个编码任务硬编码了最大推理努力,基准测试集表明,这是一个值得针对不同任务类别重新评估的成本决策。
特别关注低努力程度下的事实准确性。 OpenAI 报告的最大事实准确性提升出现在低推理努力阶段,在易出错的提示词上错误率从 11.4% 降至 7.7%。如果你的流水线特意运行低成本、低努力的调用来进行分类或提取,那么这种升级效果最为明显,同时这也是绝对错误率最高的场景。
保留一条通往 Astra 的回退路径。 OpenAI 自己的基准测试集中包含一个案例——Terminal-Bench Science 0.1,其中 Astra 以 68.1% 的成绩保持最高测试得分——在该案例中,更昂贵的模型仍然是推荐选择。对于峰值难度请求,使用带有 Astra 逃生舱(escape hatch)的路由,比将 Sol 视为直接替代品更符合 OpenAI 对这两款模型的定位。
在以下情况使用:
在以下情况使用 GPT-6.1 Sol: 你在大规模运行 Agentic 编码、computer-use 或文档密集型专业工作流,且你的瓶颈是每个已完成任务的成本,而非峰值能力。缓存输入费率使得具有稳定前缀的长期运行 Agent 在成本上大幅降低,而 OpenAI 发布的基准测试集正是这些工作负载所关注的。
在以下情况保持使用或路由至 GPT-6 Astra: 你需要在最困难的科学研究任务中获得最高分(Astra 在 Terminal-Bench Science 0.1 上得分为 68.1%,而 Sol 每个任务的成本为 $5.47,Astra 为 $23.80,你购买的是难度上限,而非吞吐量),或者你的安全门控要求最低的测量失准结果率。
在以下情况暂时跳过迁移: 你的产品依赖于在主 Chat 界面中显示 Sol(发布页面说明它尚未上线),或者你需要 Sol 上的 Ultrafast 功能,而 OpenAI 列出该功能为即将推出,而非今日可用。
FAQ
GPT-6.1 Sol 的模型 ID 是什么?
gpt-6.1-sol 在 OpenAI API 中。
GPT-6.1 Sol 的成本是多少?
截至 2026 年 9 月 29 日,每百万输入 token 为 $2,每百万缓存输入 token 为 $0.10,每百万输出 token 为 $10。这仅为 GPT-6 Astra $10/$50 标准输入输出费率的五分之一;Astra 的缓存输入费用为 $1.00。
GPT-6.1 Sol 比 GPT-6 Astra 更好吗?
不是,OpenAI 也没有这样声称。Sol 在多个基准测试中以更低的单任务成本接近 Astra 的性能,但 Astra 在 Terminal-Bench Science 0.1 上保持了最高的测试得分,并在 computer-use 压力测试中具有更低的失准结果率。OpenAI 的建议是:为了追求最高质量选择 Astra,为了追求更高频的运行任务选择 Sol。
GPT-6.1 Sol 在 ChatGPT 中可用吗?
在 ChatGPT 中 工作 以及在 Codex 中,是的,截至 2026 年 9 月 29 日,Plus、Pro、Business、Enterprise 和 Edu 用户均可使用。发布页面指出 Sol 尚未在 Chat 本身中提供。
GPT-6.1 Sol 系统卡片在哪里?
OpenAI 在发布的同时发布了一份 PDF 格式的系统卡片附录,并从发布页面提供了链接。它涵盖了上述总结的对齐和安全评估。
来源
- OpenAI — GPT-6.1 Sol 介绍(基准测试、定价、可用性、对齐)
- OpenAI — 2026 年开发者大会回顾(公告清单、可用性说明、官方媒体)
- OpenAI — GPT-6.1 Sol 系统卡片附录 (PDF)
- X 平台上的 @OpenAIDevs — DeepSWE v1.1 数据(75.2% 高难度任务,68.8% Sol 最优,每项任务成本降低约 76%)
- X 平台上的 @OpenAIDevs — AutomationBench 和 OSWorld 2.0 数据
- X 平台上的 @OpenAIDevs — 针对故意设置的难题提示词的准确性
- Surge HQ — GDP.pdf 基准测试(OpenAI 在方法论中引用)
- Zapier — AutomationBench 1.0.6(OpenAI 在方法论中引用)
- OSWorld 2.0(OpenAI 在方法论中引用)
- OpenAI — GPT-6 Astra 发布页面(比较基准)
Agentpedia 相关内容: GPT-6 Astra:OpenAI 前沿发布完整指南, GPT-5.6 Sol、Terra 与 Luna:定价及快速模式 (Fast Mode),以及 DevDay 2026:OpenAI 发布的所有内容。
Get the latest on AI, LLMs & developer tools
New MCP servers, model updates, and guides like this one — delivered weekly.