v4.0 里的 Caveman 是什么
Caveman 是 Julius Brussee 的开源项目,2026 年 4 月 4 日起步时只是一个 Claude Code 技能,如今是一个组合包:一个输出风格技能、一个用 npx 安装的 CLI、一个压缩智能体所读内容的本地代理、一个需要 Caveman 账号的可选路由器 Auto,以及一个叫 Blocks 的脚本模块。只有第一个部分是走红的“像原始人一样说话”,而它只缩短模型的回复。README 上更大的数字,输入 token 少 33.2%、用 Auto 便宜 54%,属于其他部分,来自项目自己的基准测试。
证据的简短版本是这样。发布口号是约省 75% 的 token。本文找到的最严谨的独立测试来自 JetBrains:在强制开启技能的真实编码智能体任务上,输出 token 少 8.5%,质量没有可测出的下降。一篇引用了该仓库的研究论文发现,压缩模型的输出会降低大多数 API 模型的实际成本,而压缩你自己的提示词反而抬高成本。Caveman 自己的“诚实数字”页面现在写明,相对于默认冗长回复的输出减少量没有公布,并列出了这个技能会亏的场景。弄清每个数字衡量的是哪个通道之后,这几个说法并不矛盾。
本文基于项目的代码仓库(README、INSTALL.md、SECURITY.md、HONEST-NUMBERS.md 和 v4.0.0 发布说明)、JetBrains 的文章、arXiv 论文和 Elastic 的文章,这些来源在写作时都已打开阅读。本文没有任何内容来自实际运行 Caveman;本地唯一做的计算是对技能文件的 token 计数,详见下文。会变动的数据,如 star 数和版本号,都标注了读取日期:2026 年 10 月 29 日。
75% 的发布口号
2026 年 4 月 4 日,作者发帖给出了 Claude Code 的一行安装命令,并把效果概括为“same fix. 75% less word. brain still big.”。帖子附了第一版 README 的截图,里面写着这个技能“cutting ~75% of tokens while keeping full technical accuracy”。随后这个仓库做到了少有技能仓库能做到的事:登上了 Hacker News 首页。投稿标题是“Caveman: Why use many token when few token do trick”,截至 2026 年 10 月 29 日,Hacker News API 显示 904 分、366 条评论,仓库现在显示约 115,900 个 star。
我看到一个笑话,说让 Claude 像原始人一样说话能少用 75% 的 token,于是我把它做成了 Claude Code 的一行安装。
— @JuliusBrussee 2026 年 4 月 4 日
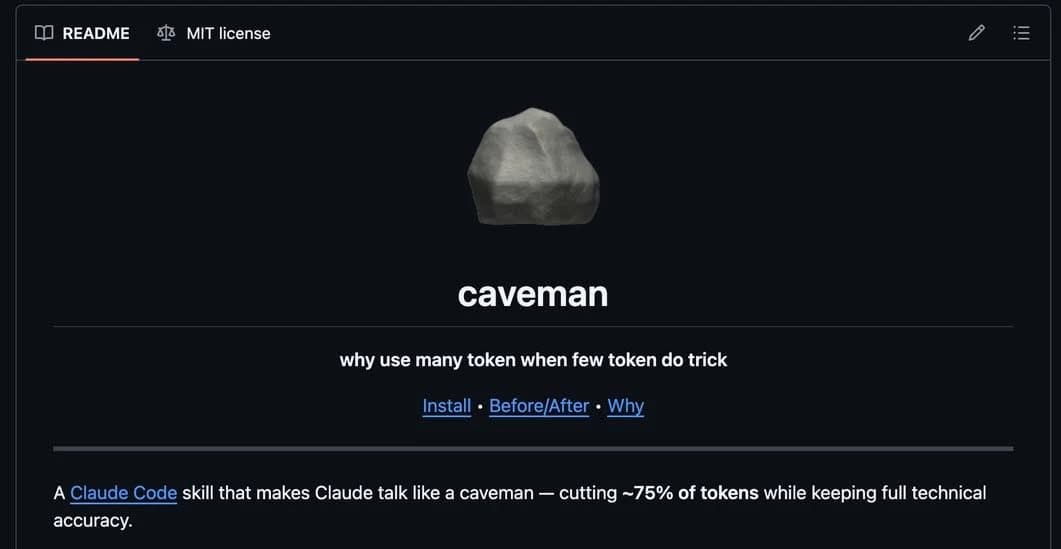
75% 这个数字源自作者看到的一个笑话,不是某次基准测试,项目后来也在自己的文档里收回了它。“诚实数字”页面写道,早期的统计版本“applied a fixed 65% output ratio without a committed reviewed result”,现在的报告会忽略那些估算字段,而且基准测试工具里没有提交经过审阅的、针对默认冗长回复的输出减少原始结果。该页面的表格把这个数字列为“Not published”。这个数字在社交媒体上流传了几个月,按项目自己的说法,背后并没有测量。
这不等于技能没用。意思是 75% 属于营销文案,打算安装的人应该去看那些有实测的行。实测的数字更小,也更有意思。
组成部分:六块石头,三种信任级别
2026 年 10 月 13 日发布的 v4.0.0 在说明里写道:让 npx @caveman-ai/cli 成为唯一的安装方式,在本地代理之上通过 Caveman Cloud 增加 Auto 路由,并把 Caveman Blocks 作为模块发布。README 把这些部分叫作“六块石头”,CLI 用 caveman on 和 caveman off 来切换它们:输出、输入、浪费修复、路由、脚本和浏览。下表按它们触及的对象以及是否需要账号来分组,依据是 SECURITY.md 里的数据流表。
| 组成部分 | 做什么 | 压缩的对象 | 需要账号吗 |
|---|---|---|---|
| 输出(技能本身) | SKILL.md 规则,让模型先给答案、去掉套话,并保持代码、命令和数字准确 | 只压缩模型的回复。不含输入、文件或思考 token | 不需要。本地智能体上下文和本地文件 |
| 输入(代理与引擎) | 本地代理,可压缩工具结果和文件,原文保留在磁盘上,智能体可以取回 | 智能体读到的内容 | 不需要。内容发往你本来就在用的提供商 |
| 浪费修复 | 在会话暂停期间保持 Anthropic 的提示缓存不过期 | 暂停后的缓存未命中 | 不需要,但会向 api.anthropic.com 重发一次请求 |
| 路由(Auto) | 按每次提问,从你配置的提供商里选模型和推理强度 | 每次提问的模型成本 | 需要。要登录 Caveman Cloud |
| 脚本(Blocks) | 可复用脚本,替代智能体反复现写的脚本 | 智能体回读的工具输出 | 不需要。预发布版 v0.1.0-rc.5,仅支持 Python |
| 浏览 | 给智能体用的压缩网页 | 页面快照 | 不需要 |
有两个 caveman 命令会碰到你自己的提示词相关文件。/caveman-compress <file> 会用压缩风格改写 CLAUDE.md 之类的记忆文件,并保留备份。README 称它让五个文件从 6,198 个 token 降到 4,138 个,单个文件降幅在 22.8% 到 49.1% 之间,作者自己的帖子则说成“1000 token CLAUDE.md × 100 sessions = 100,000 tokens on context you already wrote.”。这和语音技能是不同的机制:它改的是你每一轮都要付费的输入,而“诚实数字”页面把它的结果称为五个列出样本上的总输入减少量,并没有通用的质量等价声明。
README 里的一个设计选择与下文的研究相呼应:Caveman 说它从不改写你的提示词。项目为这一决定引用了 Adobe 的论文,该论文发现,去掉提示词里的虚词会在大多数 API 模型上抬高净成本。这个技能减少的是模型怎么说话,不碰你输入的内容。
在 Claude Code、Codex 和 Cursor 上安装
INSTALL.md 提供统一安装器和各智能体的单独命令。这些一行命令锁定在发布标签上,而不是不断变化的 main 分支,文档还说钩子文件会对照同一标签里的 SHA-256 清单校验。它也坦率说明了这项校验的限度:它“catches a broken or partial download, not a tag that was moved.”。如果你想先检查再运行,文件建议先下载脚本、读完再执行,安装器还带 --dry-run 参数,可以预览它将要改动的内容。
| 智能体 | 安装命令(来自 INSTALL.md) | 会自动启动吗 |
|---|---|---|
| Claude Code | claude plugin marketplace add JuliusBrussee/caveman && claude plugin install caveman@caveman | 会,靠钩子和状态栏徽标 |
| Codex CLI | npx -y github:JuliusBrussee/caveman -- --only codex(仅技能、不带钩子:npx skills add JuliusBrussee/caveman -a codex -g) | 会,靠 SessionStart 钩子,需用 /hooks 信任一次;仅技能的安装用 $caveman 调用 |
| Cursor | npx -y github:JuliusBrussee/caveman -- --only cursor | 会,靠会话钩子 |
| 单独安装技能,任何受支持的智能体 | npx skills add JuliusBrussee/caveman -g | 不会。用宿主的技能菜单、/caveman 或在提示词里点名调用 |
有四个细节容易漏掉。第一,在 npm 12 或更新版本上,裸的 npx -y github:... 命令会因为 EALLOWGIT 报错停下,因为 npm 12 默认关闭了 git 包拉取;文档说要加 --allow-git=root,并说锁定到 v4.0.1 的一行命令自己处理了这件事。第二,脚本化的 Claude Code 运行,也就是 claude -p 和 Agent SDK,无论你的配置怎么写都以 Caveman 关闭的状态启动,这样解析 Claude 回复的工具拿到的是纯文本;要开启就用 /caveman 或环境变量 CAVEMAN_DEFAULT_MODE。第三,新会话以哪种模式启动,可以在 ~/.config/caveman/config.json 里用 defaultMode 键设置,也可以按项目在 .caveman.json 文件里设置。第四,子智能体的行为取决于宿主:Claude Code 的子智能体沿用生成它们的那个窗口的模式,而 opencode 的子智能体拿到的是来自 AGENTS.md 的固定规则,“stop caveman”关不掉。
INSTALL.md 把这些路径和钩子行为列为项目文档中的设计。本文没有找到对 Codex 或 Cursor 钩子的独立测试,所以在你自己的会话里确认之前,请把它们的行为当作维护者的描述。只想卸载技能的话,README 给出的命令是 npx skills remove JuliusBrussee/caveman -g。技能格式本身在 Claude Code 技能文档里有说明,其中解释了为什么技能的体积重要,详见下文成本账。
哪些数字出自项目自己
README 开头有四张头条数字卡:输入 token 少 33.2%、用 Auto 便宜 54%、一次测试运行从 397 降到 76 个 token,以及 caveman 风格输出便宜 1.4 到 2.4 倍。只有最后一个来自项目之外。下表按“谁测的、覆盖什么”给本文出现的每个数字分类,让你看清哪些说法适用于你打算安装的那个技能。
| 说法 | 测量方 | 设置与范围 | 它说明什么 |
|---|---|---|---|
| 约省 75% token | 发布帖(2026 年 4 月) | 未公布方法;项目现在把相对默认回复的减少量列为未公布 | 营销口号,没有提交过的测量 |
| /caveman 4,119 对 “Answer concisely.” 4,334 对 无指令 6,983 个输出 token | 项目,README | 10 个开发者问题,claude-opus-5-5,3.1.0 规则,单次运行,只看输出长度 | 一句“简洁回答”的对照就拿走了大部分收益;语音技能按中位数大约再多省 3% |
| 输入 token 少 33.2%(885,793 → 591,673) | 项目,README | 覆盖六种文件类型的完整 Claude Code 会话,3 次运行,2026 年 8 月、旧引擎;HTML 反而差了 9.9%;18 个答案全部正确 | 这是代理和压缩器的结果,不是技能的。有意思,但属自报 |
| 用 Auto 便宜 54%($3.59 对 $7.83) | 项目,README | 85 个编码任务,各试一次,运行完成一半,解决率 43.7% 对 44.3%(±7) | 中期结果。据 README,大部分节省来自简单问题用了更低的推理强度 |
| 便宜 1.4 到 2.4 倍 | Adobe 作者的论文,arXiv | 输出压缩,八个模型、五个数据集、五个压缩级别 | 是真的,但在短答案基准上有一部分是机械性的 |
| 输出 token 少 8.5% | JetBrains | SkillsBench 87 个任务中的 86 个,成对对比,强制开启技能 | 智能体编码的最佳情形。质量不变(p = 0.82) |
| 响应 token 少 63.6% | Elastic | 八个真实 MCP 场景,1,284 → 467 个 token,是为 Elasticsearch 改制的 Caveman 变体 | 厂商自己的变体,不是 Caveman 技能 |
| 计费输出 −44.1%,总成本 +0.06% | 社区,来自 issue #727 | 每组 300 次运行,claude-opus-4-8,2026 年 7 月的技能文件 | 按该处报告,输出变短了,账单没变 |
有两个推算出来的数字有助于读懂输出测试。从 README 的表格看,“Answer concisely.”对照组已经比无指令运行低 37.9%(6,983 降到 4,334 个 token),所以可见的缩短大部分来自“要求简短”这件事本身。以这个对照组为基准,/caveman 在表格总数上低 5.0%,/ultracave 低 37.9%。README 和“诚实数字”页面引用的是中位数,3% 和 35%,并说这次测试是在 3.1.0 规则上跑的,之后没有重跑。以下是本文的推断,不是项目的说法:现代模型本来就会响应“请简洁”,所以技能相对一句话指令的边际价值主要体现在更强的模式里。
33.2% 这个结果值得仔细读,因为它是项目能用表格撑住的最大数字。它测的是完整的 Claude Code 会话,用的是压缩文件内容的代理。README 自己列出了注意事项:会话运行是 2026 年 8 月、用的旧引擎,HTML 还没有压缩器、结果反而变差,每个测试文件都把一条记录藏在 61 到 72 KB 的噪声里。文中还补充说,竞品 Headroom 在同一套测试上 18 道题答对 15 道,token 少 6.7%。这些数字对决定是否试用代理有用,但对语音技能什么也没说明。
JetBrains 测到了什么
JetBrains 在 2026 年 7 月发布了最直接的测试。设置是在 SkillsBench 上做成对 A/B,使用 Harbor 0.17 和无头模式的 Claude Code 2.1.200,模型为低推理强度的 claude-sonnet-5,跑基准 87 个任务中的 86 个,约 240 次计费试验,总花费约 106 美元。一组是原版 Claude Code,另一组装了 Caveman 并加了一条强制激活的指令,文章说这让所有数字都成为技能的最佳情形。
| 结果 | 数字 | JetBrains 的描述 |
|---|---|---|
| 输出 token | 82 个成对任务上 592k → 542k:−8.5% | 这是上限;自动触发的使用节省更少,甚至没有节省 |
| 任务质量 | 8 个任务更好、10 个更差、64 个持平;符号检验 p = 0.82;平均得分 0.326 对 0.311 | 没有可检测到的退化 |
| 成本,完整运行合计 | 技能组 40.60 美元 对 基线 36.39 美元(+11.6%) | 有一个依赖审计任务超过 20 万 token 的计价档位,计费 8.29 美元 对 0.33 美元;这是任务本身的特性 |
| 早期 10 任务运行 | 输出 token 约 −30% | 没能复现;“never trust a k=1 eval” |
JetBrains 用一句话解释了这个差距:智能体的输出以代码、diff、工具调用和精确的错误字符串为主,Caveman 对这些原样保留,只有工具调用之间的叙述会被压缩。他们的建议是,喜欢就用,因为它没有可测出的质量代价,但每天跑智能体任务时最多期待个位数偏高的百分比。该公司在 X 上的帖子也是这样总结的,随附图片是一幅漫画,里面唯一的数据是 100% 和 91.5% 的 token 使用量柱子,以及 8.5% 的标注。
像原始人那样给智能体下提示词?我们的评测显示,在真实任务里这种做法不影响质量,但只能把 token 用量减少约 8.5%,远低于宣传。
— @jetbrains 2026 年 7 月 16 日
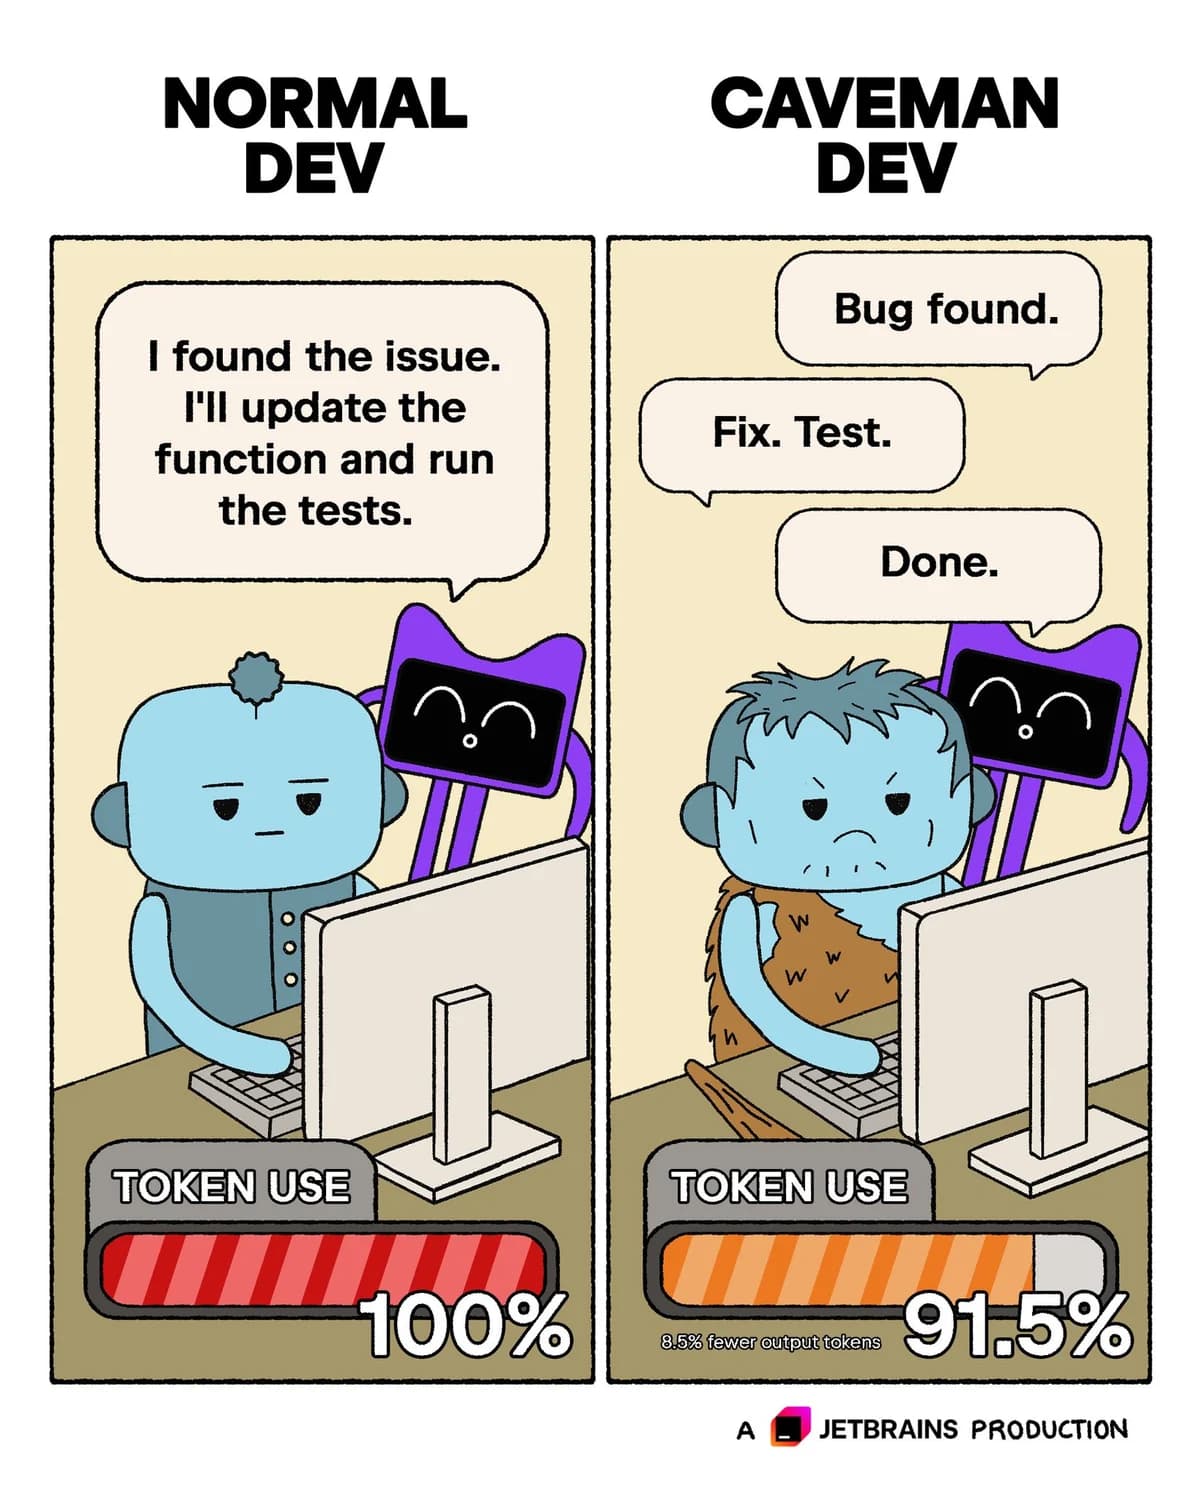
caveman 仓库承认了这个结果。它的“诚实数字”页面把 JetBrains 列在外部 A/B 测试里,README 的“Proof”部分写出了项目从中得到的教训:智能体会话主要是代码和工具调用,语音不去碰它们,所以 Caveman 后来长出了压缩智能体所读内容的组件。8.5% 这个数字针对的是 Claude Code、单一基准、单一模型、低推理强度。它对这个工作负载下的语音技能是有力的证据,对 Cursor 聊天或很长的 Codex 会话则是薄弱的证据。
Adobe 论文说了什么
README 引用了一篇标题围绕“Cavewoman”的论文,arXiv 2606.24083,提交于 2026 年 6 月 23 日,作者是 Morayo Danielle Adeyemi、Ryan A. Rossi 和 Franck Dernoncourt;README 将其标为 Adobe Research。论文在引言里引用了 Caveman 仓库。它在五个数据集上、五个压缩级别下评估八个模型,并对每次生成按准确率、实际单条成本以及与模型无约束参考答案的一致性打分,分别衡量用户的提示词和模型的回复。
主要发现有两半。输出压缩会降低大多数 API 模型的实际成本,每个模型便宜 1.4 到 2.4 倍,最佳情形下可达 3 倍。输入压缩则相反:摘要称它是严格的双输(lose-lose),会抬高净成本,五个基准的均值约为 1.15 倍,最差数据集上可达 1.8 倍,压缩更强时达 2.7 倍,因为模型会回答得更长,同时准确率崩掉。在论文的输入压缩表里,净成本变化是 GPT-4o −2.6%、GPT-5.4 +15.4%、Claude Haiku 4.5 +3.1%、Claude Sonnet 4.6 +5.1%。
论文自己的三条保留意见,对如何理解 1.4 到 2.4 这个数字很重要。作者说,输出节省在参考答案本来就很短的基准上最大,比如是非题和选择题字母,并称这些节省“partly mechanical”;需要多步算术的 GSM8K 节省较小,但在解析率高的单元格里准确率得以保持。GPT-5.4 只在它的五个基准中的两个上更便宜,因为它的计费输出主要被隐藏的推理 token 占据。论文还指出,输出 token 的定价通常是输入 token 的四到八倍,这正是输出端节省可能比输入端节省更重要的原因。它测的是短基准答案上的提示词级约束,不是带工具调用的编码智能体,所以它支持 Caveman 思路的方向,而不是任何智能体级别节省的幅度。
一份 SKILL.md 的成本账
技能不是免费的。README 说语音规则大约占 1,160 个输入 token,“诚实数字”页面则把技能增加的输入成本列为“Not measured yet”。本文用 tiktoken 的 o200k_base 分词器在本地数了 v4.0.1 的 SKILL.md,这个分词器是近似而非 Claude 的分词器,整个文件是 1,158 个 token:frontmatter 约 70 个,正文 1,087 个。这与 README 的估计一致。按 Claude Code 技能文档,描述会加载进上下文,让模型知道有哪些技能;技能被调用时才加载完整正文,加载后的正文会在之后的轮次里一直留在对话中。
下面是一个简单的盈亏平衡模型。如果冷读一次文件花 1,158 个输入 token,而每个输出 token 的价格是输入 token 的 r 倍,那么技能节省约 1,158 / r 个输出 token 时,就能抵回一次未命中缓存的读取。价格比取 Adobe 论文引用的四到八倍,就得到下表。这个模型是简化的:缓存命中的读取更便宜,而始终加载的技能每一轮都会被再次读取,所以真实的平衡取决于缓存情况和之后有多少轮。项目说它没有测过这一点。
| 输出对输入价格比 | 抵回一次未命中缓存的 1,158 token 文件读取所需节省的输出 token |
|---|---|
| 4× | 约 290 |
| 5× | 约 232 |
| 8× | 约 145 |
对照这些门槛,README 里的样例看着没问题:一条 React 回答从 63 个 token 降到 20 个(两个计数都能用 o200k_base 复现),节省 43 个 token。最好情形下回答几个问题就能回本,低端则要多得多。对于长时间的智能体会话,“诚实数字”页面里的一项独立测量给出了比例感:在 662 个 Claude Code 会话中,有位用户发现输出只占全部 token 的 0.3%,Caveman 对账单的净影响在 ±0.2% 以内。另一次外部运行每组 300 次,计费输出下降 44.1%,总成本却变动 +0.06%,每次运行多出约 1,532 个缓存上下文 token。当账单的大头是输入和缓存重读时,输出风格规则就没有多少可作用的空间。
“诚实数字”页面还列出了这个技能直接亏的场景:简短的编码问答,固定的提示词开销可能超过任何输出减少量(issue 145);按请求计费的智能体,比如 GitHub Copilot,答案变短还是同一次请求(issue 506);以及一个 Cursor A/B,用 Caveman 是 430 万个 token,不用是 100 万个,项目说无法复现,并把原因归结为规则重复注入、重试和缓存计账。该页面给出的经验法则很合理:在同一任务上,对比开启和关闭技能时提供商计费的总量,如果总量上升就关掉。想了解其他省 token 的办法,可以看把 9Router 当作省 token 工具和在 Antigravity 里省 token这两篇指南。
信任面:CLI、代理与账号
只装技能是个很小的决定:一个 markdown 文件,对某些宿主再加一个钩子。通过 npx @caveman-ai/cli 安装 v4.0 则是更大的决定,因为 CLI 会设置一个夹在智能体和提供商之间的本地代理,能检测并修改它发现的每个智能体和登录的配置,还能提供云端账号。SECURITY.md 里有一张比大多数项目都清楚的数据流表。下表是它的浓缩版;引用的行为来自 2026 年 10 月 29 日读到的文档,而文档本身也提醒已发布版本可能落后于仓库。
| 环节 | 需要账号吗 | 按 SECURITY.md,你的内容去向哪里 |
|---|---|---|
| 技能和经典输出钩子 | 不需要 | 本地智能体上下文和本地文件。这些组件不会直接调用 Caveman 的服务 |
| 本地代理与引擎 | 不需要 | 请求内容(可能经过转换)加上你的提供商凭据,发往你的智能体选定的提供商。用于恢复的原文留在本地存储,除非智能体之后取回并发送 |
| 浪费修复(缓存保活) | 不需要 | 把代理刚转发的 Anthropic 请求,用相同凭据、max_tokens 设为 0 再发一次,以保持提示缓存不过期;副本在内存里最多保留一小时。用 CAVEMAN_CACHE_WARM=off 关闭 |
| CLI 使用遥测 | 不需要 | 不含内容的使用事件,包括处理和节省的 token 数,默认发给 Caveman,并连同发送方 IP 地址存储(IP 90 天后清除,事件 13 个月后删除)。用 caveman telemetry off 或 DO_NOT_TRACK=1 关闭 |
| 托管的 Caveman 网关 | 需要 | 请求和响应经过 Caveman Cloud 和所选提供商。文档说不要把托管模式当作仅本地 |
| Auto 路由(已登录、路由已开、选了 Auto) | 需要 | 每次新提问,会把你最新的提问、前一次提问以及智能体上一条回复的末尾原样发给 Caveman Cloud,分别最多 128 KiB、16 KiB 和 16 KiB,并附带模型名称和请求计数 |
有两点值得强调。Auto 那一行里的“原样(raw)”指的是你的智能体写进那些轮次里的任何内容,其中可能包括 CLAUDE.md 和记忆提醒、你提到的文件内容以及 shell 输出,所以使用账号支撑的路由器是一个数据共享的决定,而不只是计费的决定。另外,代理在传输中会看到你的提供商凭据,这是设计使然,任何本地代理都如此,也正是安装路径的完整性重要的原因。发布说明补充说,模块索引列在签名的校验清单里,CLI 会拒绝清单里没有列出的索引,这就意图而言是个好迹象。本文没有审计代码或签名设置;这些说明是项目自己的描述,不是核实。
从这张表可以推出一条保守的路径。先只装技能,用 npx skills add JuliusBrussee/caveman -g,不涉及代理,也不涉及账号。如果想要代理,先带 --dry-run 跑安装器,读清楚它要改什么;不想发送使用事件就设置 caveman telemetry off;再用 caveman status 查看开了什么。Auto 和托管网关留给你愿意把提示词文本发给第三方的会话。项目的漏洞政策要求通过 GitHub 私下报告凭据泄露或代理隔离失败这类问题,这是个合理的信号,说明它认为这些是敏感的环节。
用自己的工作负载测一遍
上面的证据是在论证“要去测”,而不是“该装”或“别装”。一次恰当的测试花一天,只用你平时的账单数据。步骤遵循项目自己的指引,并加入了几条取自 JetBrains 方法的补充。
- 选一个可重复的任务。选你每周都做的工作,最好同时包含聊天式回答和工具调用,让测试反映你自己的混合,而不是 README 里的例子。
- 每组至少跑五次。JetBrains 最初的 10 任务运行显示约 30%,完整运行则收敛到 8.5%。单次运行就是噪声。
- 比较提供商计费的总量,而不是输出长度。用提供商的用量或账单页面。项目说这比它自己的估算更权威,它的
/caveman-stats命令正是出于这个原因把节省量报告为未知。 - 把技能自身的成本算进去。加上文件约 1,158 个 token,并注意你的智能体是否每一轮都重新注入它。“诚实数字”页面里的 Cursor 报告就是警示例子。
- 单独检查质量。像 JetBrains 那样统计正确结果。token 数不能证明简短的回答保留了每个注意事项;项目说它目前还没有经过审阅的保真度快照。
- 把语音和代理分开测。用
caveman on和caveman off一次切换一个部分,这样你就知道是哪一个改变了账单。
| 你的工作负载 | 证据提示了什么 | 建议做法 |
|---|---|---|
| 终端聊天里的长篇回答 | 可去掉的行文更多,项目自己的例子正是来自这里 | 试试这个技能;自己做 A/B 测量 |
| 自主编码智能体,主要是工具调用和 diff | JetBrains 的上限是输出 token 8.5%;成本节省被单次试验的方差淹没 | 可选。最多期待个位数 |
| 按请求计费的智能体,比如 GitHub Copilot | 据项目所述,答案变短仍是同一次请求 | 跳过语音技能 |
| 每轮都重读的大 CLAUDE.md 或记忆文件 | caveman-compress 报告每个文件 22.8% 到 49.1%;自测 | 在副本上试,手动比对结果 |
| 大量使用子智能体的工作流 | 模式继承因宿主而异;opencode 的规则是固定文本 | 在你用的宿主上测;项目称 Hermes Agent 未经验证 |
| 团队政策禁止第三方数据流 | Auto 和托管网关会把原始轮次发给 Caveman Cloud | 只用技能,或用关闭遥测的本地代理 |
如果你是在比较模型而不是工具,比任何风格规则更大的杠杆往往是模型和推理强度本身;我们的 Claude Opus 5.5 与 Sonnet 5.5 编码对比讲的就是这个取舍。如果你担心的是额度用完而不是花钱,可以看 Codex 用量重置指南;至于持久上下文怎样改变 token 用量,Claude-Mem 指南和 Claude Code 最佳实践指南是最接近的几篇。
实用结论
Caveman 是个有趣、低风险的缩短回复的办法,在智能体工作上有一个老实的上限;同时它也是一个更大的工具,而它的大数字仍然是项目自己的说法。语音技能文档齐全,能让代码和数字保持准确,在 JetBrains 的测试里没有质量损失。它对编码智能体的实际效果,输出 token 上是个位数,而项目自己的页面也说它在简短的编码问答和按请求计费上会亏。75% 的发布口号背后没有测量。论文里的 1.4 到 2.4 倍是真的,但对短答案基准更有利。
v4.0 新增的部分是另一个决定。代理的 33.2% 和 Auto 的 54% 都有前景、数字具体,但都是自报,并带有 README 自己印出来的注意事项。先单独试技能,用提供商的总量自己跑 A/B,读完数据流表并确认信任面适合你的环境之后,再加代理。如果你的 A/B 显示账单变高,项目自己的建议是关掉它。
局限
- 本文没有运行 Caveman。本地唯一的计算是对 v4.0.1 技能文件的 tiktoken
o200k_base计数;这个分词器只是近似,不是 Claude 或 Codex 计费所用的分词器。 - 这里出现的每个 Caveman 基准数字(输出测试、33.2%、54%、397 到 76、从 6,198 到 4,138)都是项目自己的,没有复现。Auto 的结果被项目标为中期结果,运行只完成一半,差距小于它声明的误差。
- JetBrains 的结果是单一模型、低推理强度、单一基准、强制激活。Adobe 作者的论文测的是基准问题上的提示词级约束,作者所属机构取自 README,没有对照论文首页核实。
- 来自 LemonCrow 和 edubraqd 的外部 A/B 结果以及 Cursor 报告,来自“诚实数字”页面总结的 issue。它们是在该页面上读到的,没有读 issue 原帖,而且用的是更早版本的技能。
- Codex 和 Cursor 的激活方式取自 INSTALL.md。没有找到对这些钩子的独立测试。
- SECURITY.md 描述的是仓库的行为,并说已发布版本可能落后。二进制文件、Cloud 服务和签名设置都没有审计。
- star 数、fork 数、发布标签和 Hacker News 得分均截至 2026 年 10 月 29 日,会变化。README 里的社交证明说法,比如 GitHub Trending 第一名,没有独立验证。README 链接的一个 YouTube 视频没有观看,也没有引用。
常见问题
Caveman 技能是什么?
它是 Julius Brussee 的开源技能,让 AI 编码智能体用简短、先给答案的文字作答,同时保持代码、命令、路径和数字准确。自 2026 年 10 月 13 日的 v4.0.0 起,项目还附带 CLI、本地代理、一个叫 Auto 的可选账号路由器和一个脚本模块。
Caveman 真的能省 75% 的 token 吗?
没有任何测量支持这个数字。它是发布当天的说法,项目的“诚实数字”页面说,早期统计套用了固定的 65% 输出比例,没有经过审阅的结果,相对默认回复的输出减少量并未公布。JetBrains 在强制开启技能的真实智能体任务上测得输出 token 少 8.5%。
怎样在 Claude Code、Codex 和 Cursor 上安装 Caveman?
Claude Code:先运行 claude plugin marketplace add JuliusBrussee/caveman,再运行 claude plugin install caveman@caveman。Codex 用 npx -y github:JuliusBrussee/caveman -- --only codex,Cursor 则在同一条命令里用 --only cursor。单独安装技能用 npx skills add JuliusBrussee/caveman -g。请先用 --dry-run 预览。
README 里的数字哪些来自项目之外?
便宜 1.4 到 2.4 倍这个数字来自一篇引用了该仓库的 arXiv 论文,8.5% 来自 JetBrains,README 也列出了它。输入少 33.2%、Auto 省 54% 以及 397 到 76 个 token 是项目自己的基准,63.6% 则来自 Elastic 为 Elasticsearch 做的 Caveman 变体。
Caveman 是削减输入 token,还是只削减输出 token?
语音技能只缩短输出;“诚实数字”页面把它的输入减少量列为 0%,并说它不压缩上下文、文件或思考 token。代理、caveman-compress 和浏览组件针对的是输入,它们的数字都是自报。
Caveman 会让我的账单变高吗?
在某些设置里会。项目列出了简短的编码问答、按请求计费(如 GitHub Copilot),以及一次 Cursor 运行,用了它是 430 万个 token,不用是 100 万个。请在同一任务上比较开关技能时提供商计费的总量,总量上升就关掉。
Caveman 的 CLI 会向 Caveman 的服务器发送什么?
按 SECURITY.md,技能和经典钩子不会调用 Caveman 的服务。CLI 默认发送不含内容的使用遥测,包括 token 数,并带上发送方 IP 地址,你可以用 caveman telemetry off 或 DO_NOT_TRACK=1 退出。Auto 之类账号支撑的功能会把最近的提问和回复原样发给 Caveman Cloud。
Adobe 的论文证明了 Caveman 有效吗?
它支持方向,不支持幅度。论文发现输出压缩让大多数 API 模型的成本降低 1.4 到 2.4 倍,输入压缩则抬高成本,但它用的是短基准答案,称输出节省有一部分是机械性的,也没有测试带工具调用的编码智能体。
来源
来源核对于 2026 年 10 月 29 日。
- GitHub 上的 JuliusBrussee/caveman(README、仓库元数据)和 INSTALL.md
- Honest Numbers(诚实数字)和 Security and privacy(安全与隐私)
- Caveman v4.0.0 发布说明和 v4.0.1 的 SKILL.md
- JetBrains AI 博客:Speaking to AI Agents Like Cavemen Saves 65% of Tokens. We Test.和 JetBrains 在 X 上的帖子
- arXiv 2606.24083,Cavewoman: a two-channel evaluation of caveman-style compression
- Elasticsearch Labs:elastic-caveman
- Julius Brussee 在 X 上的发布帖和 Hacker News 投稿
- Claude Code 文档:Skills
相关阅读:9Router 省 token 指南、Antigravity:省 token、省额度、Claude Code 最佳实践、Claude-Mem 持久记忆、Claude Opus 5.5 与 Sonnet 5.5 编码对比、Codex 用量重置。