简短回答
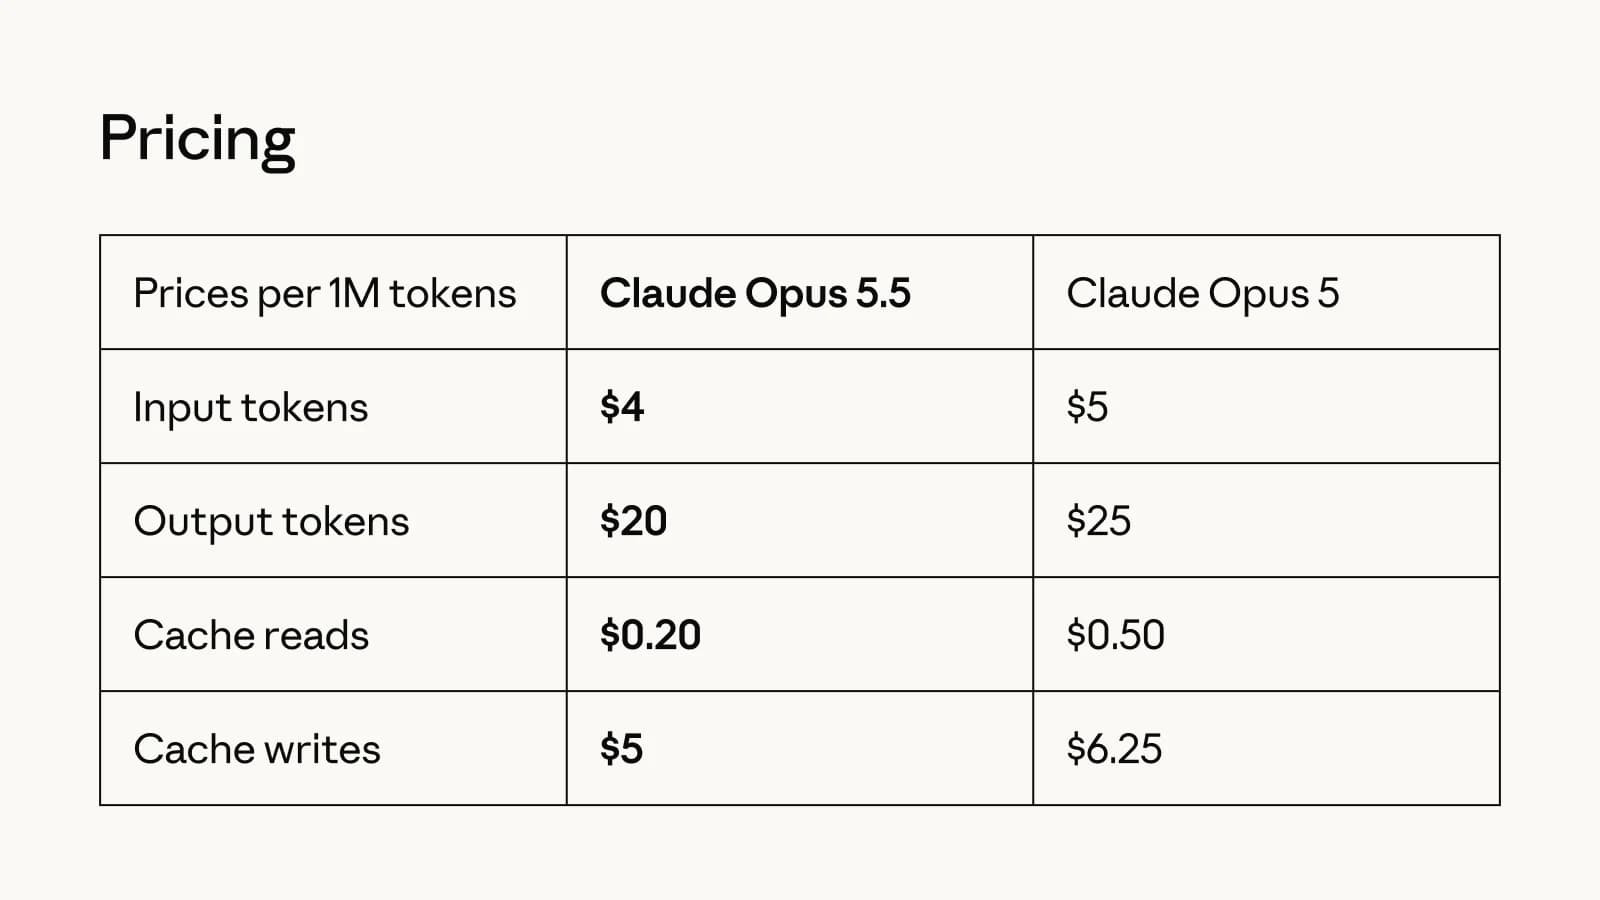
把 Sonnet 5.5 当作默认的编程模型;当任务很长、需求含糊或出错代价高时,再升级到 Opus 5.5。Sonnet 5.5 的价格是每百万输入 token 2 美元、每百万输出 token 10 美元;Opus 5.5 则是 4 美元和 20 美元。在 Anthropic 公布的编程基准上,Sonnet 5.5 在 CursorBench 上与 Opus 5.5 相差约两分,在一行 Terminal-Bench 4.0 成绩上还反超了它;但在 Sonnet 以 Max effort 运行时,FrontierCode 上落后约八分。Anthropic 自己也说,Opus 5.5 在“需要持续判断的复杂开放式工作”上“明显更强”。
effort 的设置和模型选择同样重要。两个模型都支持五档:low、medium、high、xhigh 和 max,而且两家厂商的图表都显示,档位越往上,单任务成本涨得越陡。同一个提示词,低 effort 的 Sonnet 5.5 与 max effort 的 Opus 5.5,花费可以差一个数量级,所以只盯着模型名,等于把大部分省钱空间白白放掉。API 上 Opus 5.5 默认 medium、Sonnet 5.5 默认 high,也就是说,一个完全不设 effort 的请求,已经让两个模型落在了各自曲线上的不同位置。
本文依据 Anthropic 的产品页、API 文档,以及一个独立来源——Artificial Analysis 智能指数 v5。下文所有 Anthropic 的基准数字都是厂商自报;有独立数字的地方都会标明。成本数字是对公开价目表做的算术,并非对某个具体代码库的实测;本文唯一来自真实负载的内容,是结尾那套需要你自己去跑的测试方案。如果想了解上一代的背景,Sonnet 5 与 Opus 4.8 对比(英文)讲了上一对模型如何分工,Claude Fable 5.1 指南(英文)则覆盖 Opus 之上的那一档。
Anthropic 发了什么
Anthropic 于 2026 年 9 月 22 日发布 Opus 5.5,六天后的 9 月 28 日发布 Sonnet 5.5。两个发布帖串都来自 @claudeai 账号,本文后面用到的大部分表述都出自其中。Opus 的首条帖子,是拿它去对标上一档的模型,而不是 Sonnet。
Introducing Claude Opus 5.5, the first model in our new Claude 5.5 family. It performs at the level of Claude Fable 5.1 for most tasks, and costs 40% less to run than Opus 5.
— @claudeai 2026 年 9 月 22 日
这条帖子里有两个细节,决定了后面的一切。第一,对比对象是 Fable 5.1 和 Opus 5,而不是 Sonnet;第二,那个 40% 是相对上一代 Opus 的“运行成本”说法。后续帖子解释了节省从何而来:一部分是更低的服务成本体现在价目表里,另一部分是每个任务用的 token 更少。Anthropic 说这 40% 是它在默认设置下、用“典型工作负载”自行测试得出的结果,也就是一条关于你看不到的负载组合的厂商表述。
Opus 5.5 requires less compute to serve than Opus 5, and its pricing reflects that. Our tests show that at default settings it will cost 40% less than Opus 5 on typical workloads.
— @claudeai 2026 年 9 月 22 日
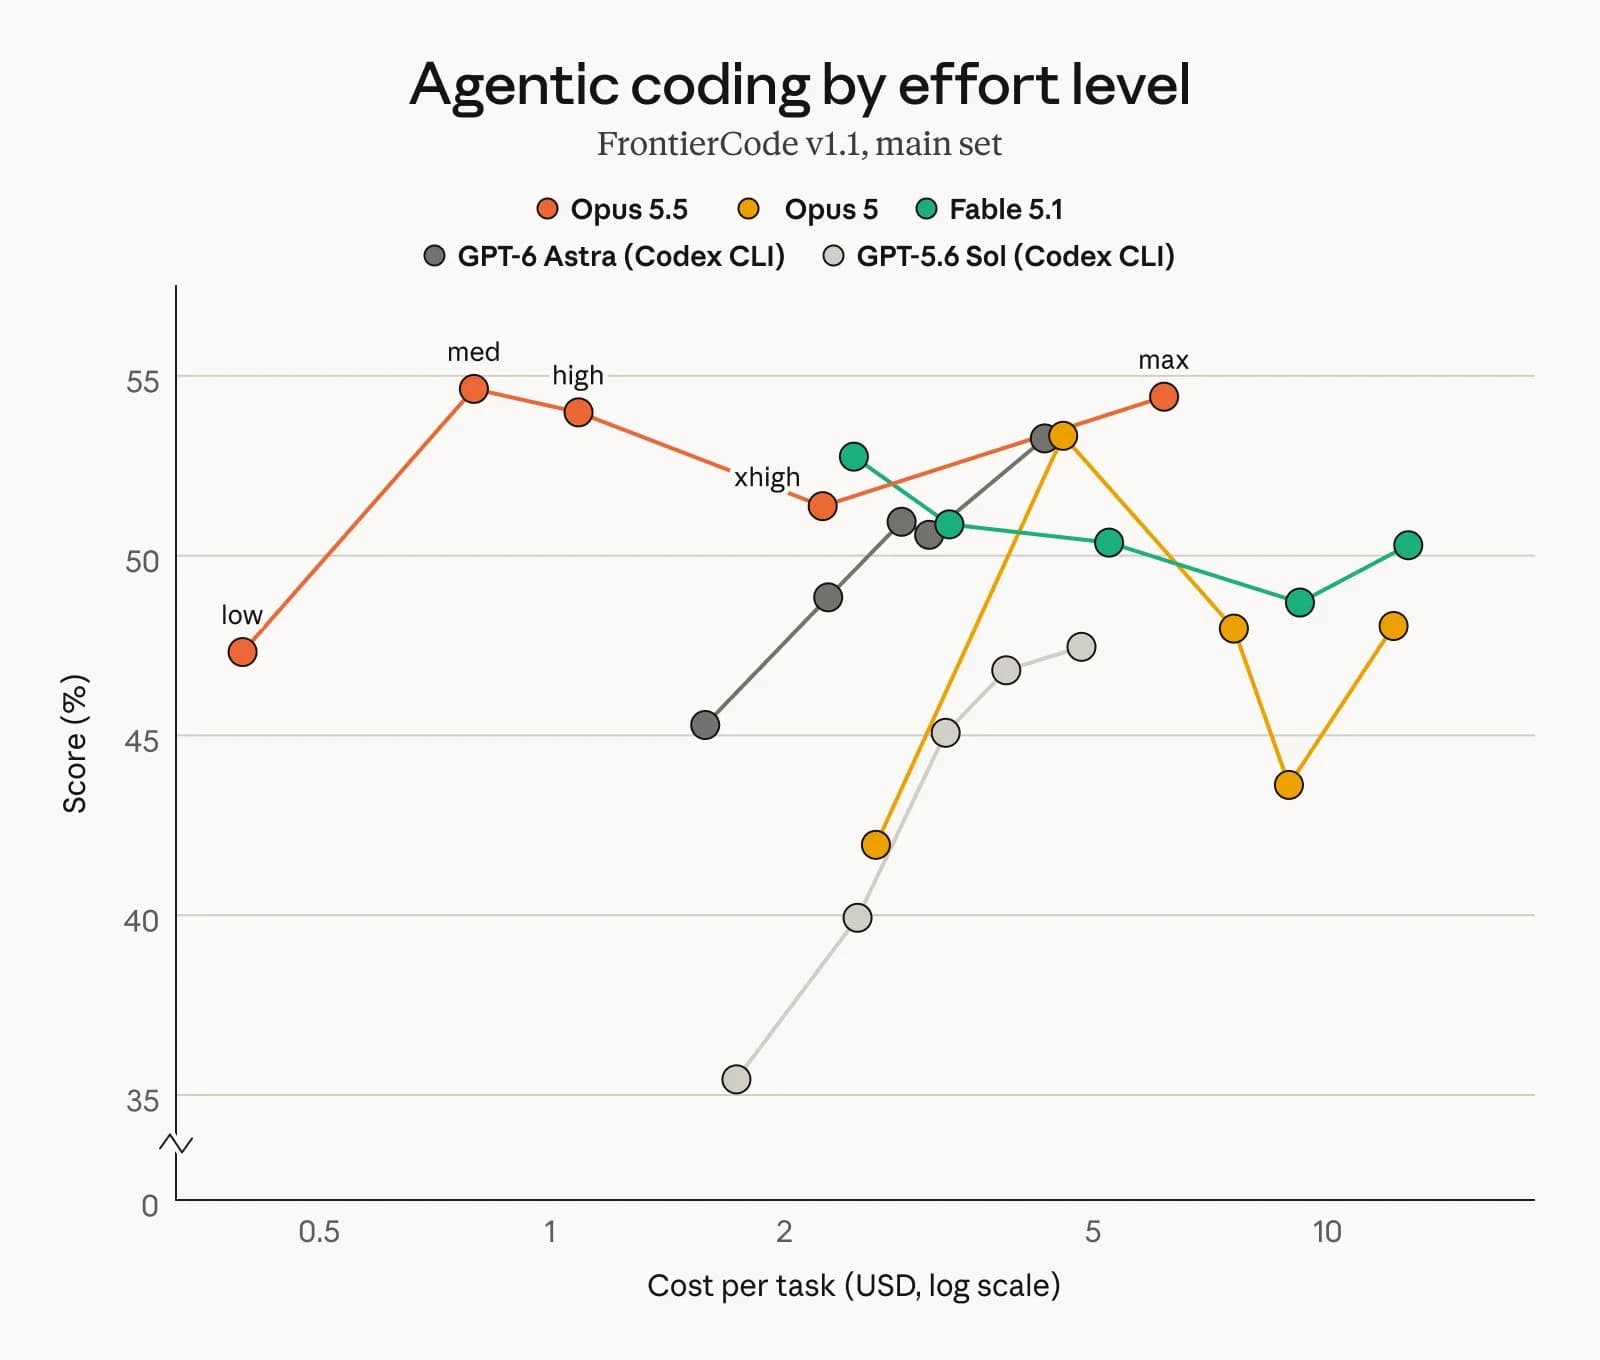
Opus 的第三条帖子与 effort 关系最大。它说,在默认 effort 下,Opus 5.5 能以低得多的单任务成本给出前沿水平的结果,常常胜过其他模型在其最高档位下的表现。它附了四张图,分别对应 FrontierCode、AutomationBench、GDPval-AA 和 Terminal-Bench 4.0,每张都把分数或通过率画在单任务成本(Terminal-Bench 那张是单次尝试成本)之上,并标出了 Opus 5.5 的各档 effort。这些图在下文复现。
At its default effort setting, Opus 5.5 delivers frontier results for a fraction of the cost per task, often beating other models running at their highest settings. It also generates output more than 30% faster than Opus 5.
— @claudeai 2026 年 9 月 22 日
Sonnet 的发布帖打的是另一张牌:相对 Sonnet 5 的明确升级,速度快 30% 以上,大多数工作成本最多可低 30%。它把 Sonnet 5.5 定位为这个家族的第二个模型,而不是“Sonnet 对 Opus”的二选一。
Introducing Claude Sonnet 5.5, the second model in the Claude 5.5 family. It’s a clear upgrade over Sonnet 5, runs more than 30% faster, and costs up to 30% less for most work.
— @claudeai 2026 年 9 月 28 日
后来的一条帖子改变了价格算术。10 月 7 日,Anthropic 宣布把 Sonnet 5.5 的缓存读取价格减半,降到每百万 token 0.10 美元,并称这让 Sonnet 5.5 在大多数长时间运行的工作上便宜约 20%。当前的定价页与产品页都显示 0.10 美元,所以任何基于发布周报道写成的成本表,都可能还带着旧的缓存读取价。本文后面的公式用的是现价。
One more thing: we’re halving the price of cache reads on Claude Sonnet 5.5, to $0.10 per million tokens. That makes Sonnet 5.5 around 20% cheaper to run on most long-running work.
— @claudeai 2026 年 10 月 7 日
Anthropic 还在官方 Claude YouTube 频道为每个模型各发了一支发布视频,见 Opus 5.5 与 Sonnet 5.5 的页面。两支都是简短的产品介绍;本文的数字取自书面页面和文档,因为脚注都在那里,视频里没有。
两个模型并排对比
从纸面上看,这两个模型是兄弟:都是 1M token 上下文窗口、128K 最大输出、2026 年 6 月知识截止,以及自适应思考。差别在价格、速度定位、默认 effort,以及思考系统允许什么。Anthropic 自己的模型对比表把 Opus 5.5 标为中等延迟,把 Sonnet 5.5 标为快。
| 属性 | Claude Opus 5.5 | Claude Sonnet 5.5 | 来源 |
|---|---|---|---|
| API 模型 ID | claude-opus-5-5 | claude-sonnet-5-5 | Anthropic 模型页面 |
| 发布日期 | 2026 年 9 月 22 日 | 2026 年 9 月 28 日 | Anthropic 产品页面 |
| 输入 / 输出(每 MTok) | $4 / $20 | $2 / $10 | 定价文档 |
| 缓存读取(每 MTok) | $0.20 | $0.10 | 定价文档;X 帖子,10 月 7 日 |
| 5 分钟缓存写入(每 MTok) | $5 | $2.50 | 定价文档 |
| 上下文 / 最大输出 | 1M / 128K token | 1M / 128K token | 模型概览 |
| 延迟标签 | 中等 | 快 | 模型概览 |
| API 默认 effort | medium | high | Effort 文档 |
| 关闭思考 | 不可能;思考始终开启 | thinking 类型 between_tools,只保留进度说明 | 各 What’s new 页面 |
| 快速模式 | 支持,$8 / $40 每 MTok | 未列出 | 定价文档 |
| 定位 | 长时间运行的智能体编程与知识工作 | 速度与智能的最佳组合 | Anthropic 文档 |
表里有两行值得细看。第一,Sonnet 一栏的每个价格都恰好是 Opus 一栏的一半:输入、输出、缓存读取、缓存写入无一例外。这让成本比较异常干净,因为这个比例与你的负载形态无关。如果 Sonnet 5.5 在某个任务上花的 token 数和 Opus 5.5 相同,它的成本就是一半;如果它花了两倍,账单就完全一样。第二,默认 effort 的方向与价格恰好相反:更便宜的模型默认用的反而是更高的 effort。所以只换模型 ID、其他什么都不动的团队,其实同时改了两个变量。
Opus 5.5 还支持快速模式,Anthropic 称其速度最高可达 2.5 倍,价格为每百万输入 token 8 美元、每百万输出 token 40 美元,是标准 Opus 价格的两倍。定价页说快速模式不能与 Batch API 一起用,缓存倍率也叠加在快速模式的价格之上。对延迟敏感的交互场景,这是在 Opus 上买速度的唯一办法;而 Sonnet 5.5 是更便宜的快响应路线,因为 Anthropic 报告它的输出速度比 Sonnet 5 快 30% 以上。
Effort 档位详解
Claude 的 effort 控制是一个请求参数 output_config.effort,文档列出五个取值:low、medium、high、xhigh 和 max。Opus 5.5 和 Sonnet 5.5 都支持全部五档。文档把 effort 描述为一种行为信号,而不是严格的 token 预算,并说它影响每一个输出 token,包括说明文字、工具调用和函数参数,以及(开启时的)思考。因此 effort 调低也意味着工具调用更少、更简短,这对编程智能体很重要,因为长会话的大部分时间都花在工具调用上。
| 档位 | Anthropic 文档的说法 | 文档建议的典型用途 |
|---|---|---|
| low | 最高效;显著节省 token,能力有所下降 | 需要最快速度和最低成本的较简单任务,例如子智能体 |
| medium | 均衡;适度节省 token。Opus 5.5 与 Haiku 5.5 的默认值 | 需要在速度、成本与表现之间取得平衡的智能体任务 |
| high | 按任务需要花费足够的 token。其他所有支持 effort 的模型的默认值,包括 API 上的 Sonnet 5.5 | 复杂推理、困难的编程问题、智能体任务 |
| xhigh | 为长周期工作扩展能力 | 超过 30 分钟、token 预算达到百万级的长时间智能体与编程任务 |
| max | 绝对最高能力,对 token 花费不设限 | 需要尽可能深入推理的任务 |
“opus 5 high”这个搜索词之所以出现,是因为默认值变了。Opus 5 及更早的 Opus 默认是 high,Opus 5.5 则是 medium,文档说得很直接:省略 effort 的请求,现在比在 Opus 5 上低一档运行。把 effort 设成模型的默认值,与完全省略它的行为一模一样。如果你把 Opus 5 的集成原封不动搬过来、从没设过 effort,那你现在已经在跑更便宜的配置,而且按 Anthropic 的说法,仍处在它自己基准曲线的靠前位置,只是你的质量底线动了。Anthropic 对这两个新模型的建议是一致的:用你自己的评测重新做一遍 effort 扫描,不要沿用旧模型的设置。
对 Sonnet 5.5,文档补充了具体说明。各档位经过重新校准,同一档位产生的思考量与 Sonnet 5 上不一样。Anthropic 的建议是:除非负载是智能体型或对延迟敏感,否则从 high 起步;对智能体编程和多步工具调用,规格明确的任务从 medium 开始,较难或较长的任务升到 high;只有在你的评测显示质量有提升时,才使用 xhigh 或 max。对智能体编程,它建议把 max_tokens 设为 128,000(模型上限)并开启流式输出,因为即使思考文本不返回,思考也计入 max_tokens。对 Opus 5.5,文档出于同样的原因,说在较高档位要把 max_tokens 设大:它是思考加回复文本的硬上限。
两个模型也都支持按消息设置 effort,让智能体循环在轮次之间改变 effort,同时保留提示缓存。按消息 effort 目前标注为 beta 功能。Sonnet 5.5 在这里有一个限制:如果你用 between_tools 设置关闭了前置思考,就不能在对话中途改 effort,与当前生效档位不同的按消息 effort 会返回 400 错误。Opus 5.5 没有这种模式,因为它的思考始终开启。
基准测试(已标注来源)
Anthropic 为每个模型各发布了一张基准表。Sonnet 的表里把 Opus 5.5 列为一栏,所以下面的正面对比数字来自 Anthropic 的 Sonnet 5.5 页面和 Opus 5.5 页面。这里每一个数字都是厂商自报,由 Anthropic 或脚注里点名的合作方跑出。各行附带的说明不是装饰,其中有几条会直接改变哪个模型看上去更好。
| 基准 | Sonnet 5.5 | Opus 5.5 | 说明 |
|---|---|---|---|
| Terminal-Bench 4.0(智能体终端编程) | 70.6% | 66.4% | Opus 取其最高分,对应 xhigh;Opus 的标准误差为 ±2.6 个百分点;表中未标明 Sonnet 的 effort |
| FrontierCode v1.1(主集,“这个改动会被合并吗”) | Max 档 46.2%;Xhigh 档 52.1% | 54.4% | Opus 的表中数值对应 max effort。Sonnet 在 Max 档反而低于 Xhigh 档,Anthropic 将其归因于代码审查 skill 的扇出,导致超时和超出范围的改动 |
| CursorBench 4.0(真实 Cursor 会话) | 55.5% | 57.8% | 取各自最佳成绩;Anthropic 称 Sonnet 的最佳成绩与 Opus 相差约两分 |
| GDPval-AA v2.1(知识工作,Elo) | 1844 | 1846 | 由 Artificial Analysis 运行;Sonnet 的数字来自一次预发布部署,其中的结构化输出 bug 已修复 |
| AA-Briefcase v1.1(长周期知识工作,Elo) | 1811 | 1822 | Sonnet 同样适用上述 Artificial Analysis 的说明 |
| Humanity’s Last Exam(可用工具) | 64.5% | 67.7% | 除非另有标注,Opus 取 max effort |
| OSWorld 2.1(计算机使用,部分) | 80.1% | 81.8% | 厂商自报 |
| Chartography(不用工具) | 61.6% | 64.4% | Sonnet 的表使用不用工具的设置 |
总体读法很直接:八行里有五行,两个模型的差距不到三分(或不到十个 Elo),而在 Terminal-Bench 4.0 上,Sonnet 的数字更高。真正把两者拉开的是 FrontierCode,这个基准看的是维护者会不会合并这个改动。Anthropic 的 Sonnet 页面给出 Max 档 46.2%、Xhigh 档 52.1%,对比 Opus 5.5 的 54.4%;Opus 页面的正文又补充说,默认 medium effort 下的 Opus 5.5 得分为 54.6%。这两个 Opus 数字并不是同一种配置,Anthropic 也没有在文中把它们对上,所以把 54.4 和 54.6 当作同一量级即可,不必当成需要解开的矛盾。
对运行编程智能体的人来说,Sonnet FrontierCode 那一行的脚注,是两篇发布文章里最有用的一段话。Anthropic 说,Sonnet 5.5 在 Max 档得分低于 Xhigh 档,是因为在 Max 档它更频繁地运行 Claude Code 的代码审查 skill,而这个 skill 会把一次审查拆给很多子智能体。在 Cognition 检查过的两个案例里,这导致了超时,或者导致了超出任务范围的额外改动;而 FrontierCode 即使对有益的改动,只要超出范围也会扣分。教训不是“Max 不好”,而是:更高的 effort 买来的是更多的动作,而更多的动作不等于更小、更容易合并的 diff。
Terminal-Bench 4.0 这一行则要往另一个方向小心。70.6 对 66.4 看起来像是 Sonnet 赢了,但 Anthropic 给出的 Opus 5.5 标准误差是 ±2.6 个百分点,足以覆盖 4.2 分差距的大部分;表里没有说明 Sonnet 用的是哪一档 effort;Opus 的数字又明确是它 xhigh 下的最高分,而不是同条件对比。说 Sonnet 5.5 在终端任务上至少与 Opus 持平是合理的;说 Sonnet 5.5 在终端编程上击败了 Opus 5.5,这张表并不能证明。
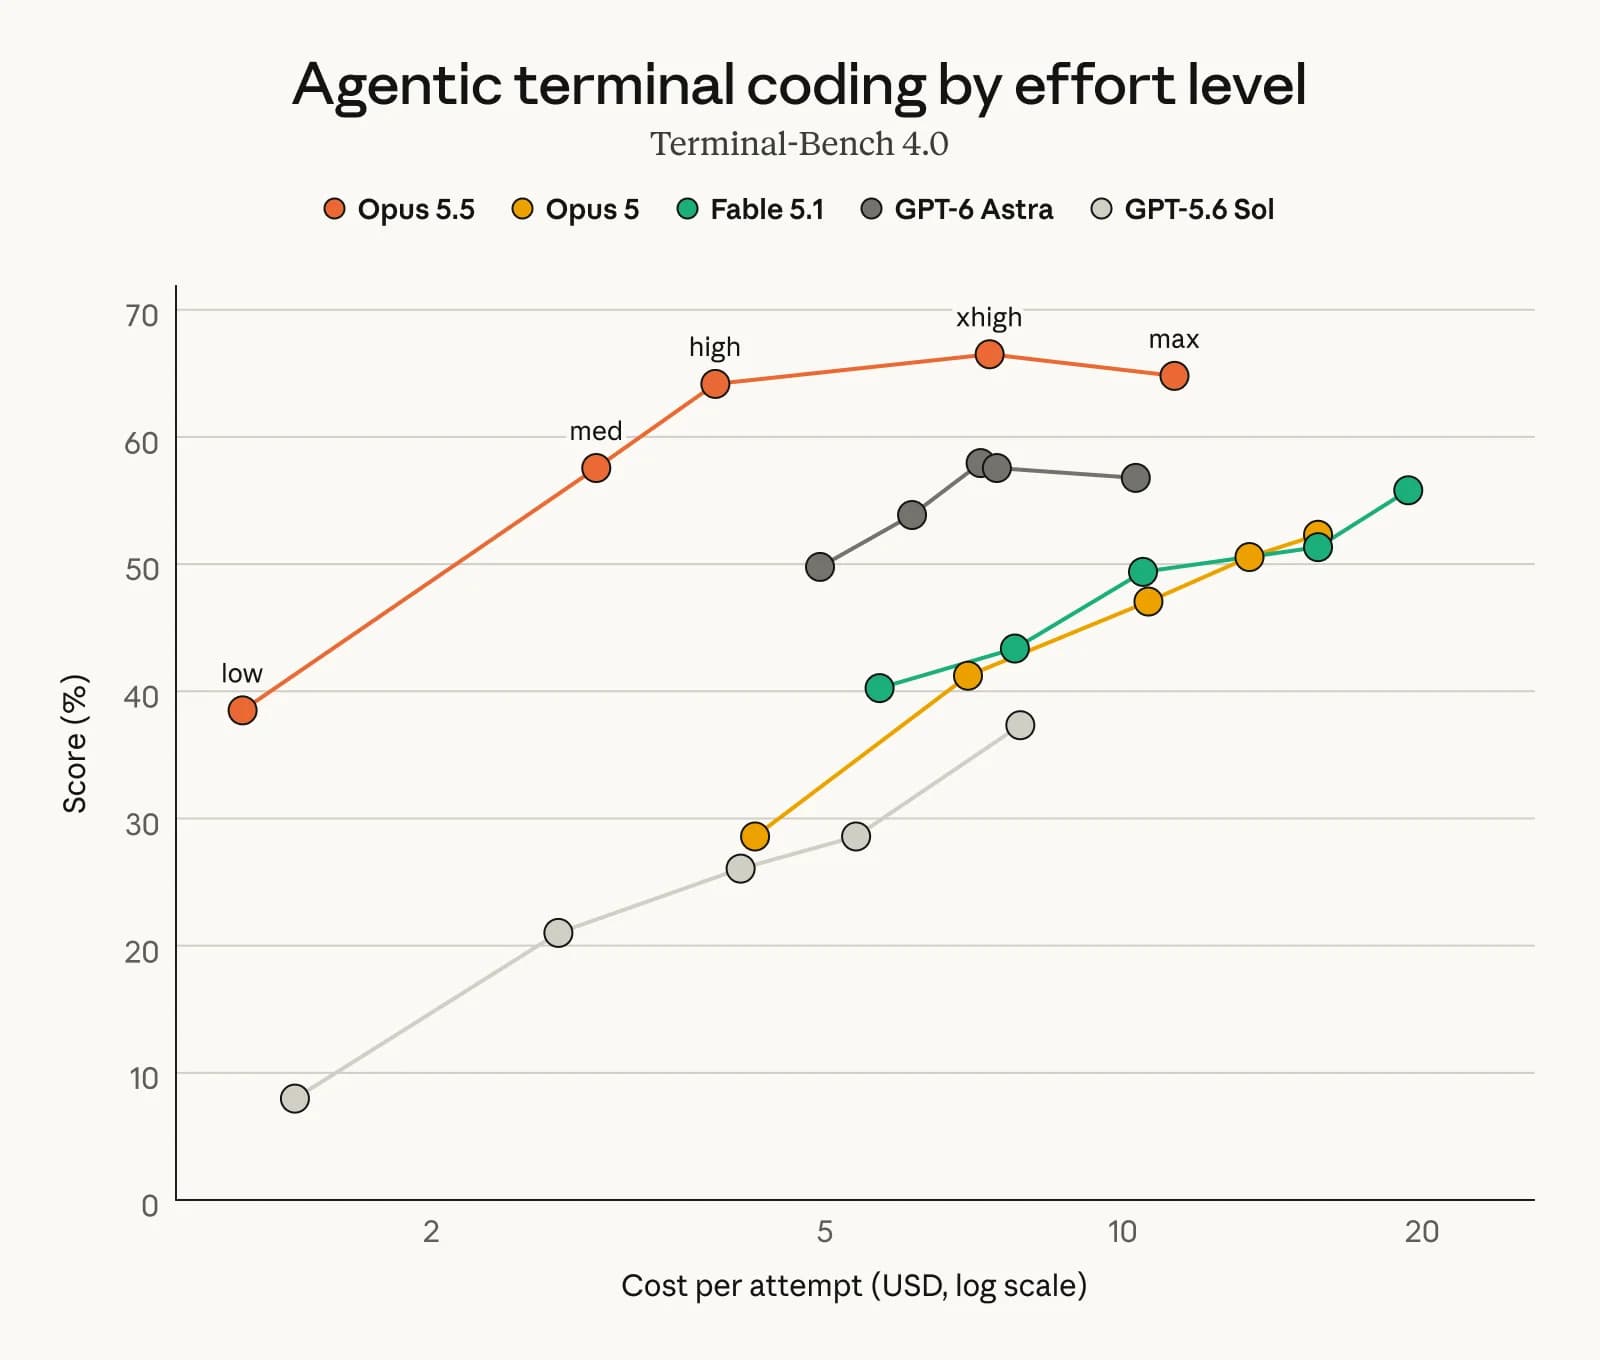
各个模型曲线的形状,决定了 Anthropic 的成本效率论断站不站得住。对 Opus 5.5,它说在 Terminal-Bench 4.0 上,默认 effort 的 Opus 5.5 以约五分之一的成本击败了 max effort 的 Opus 5;在 FrontierCode 上,默认 medium 的它以约五分之一的单任务成本超过了 GPT-6 Astra 的最高分。对 Sonnet 5.5,它说在多项基准上,Low 或 Medium effort 的 Sonnet 以约十分之一的单任务成本击败了 Sonnet 5 的最佳成绩;在 FrontierCode 上,High effort 的它以约五分之一的单任务成本追平了 GPT-6 Sol 的最佳成绩。它还说,Sonnet 5.5“在较低 effort 设置下与 Opus 5.5 搭配得最好,那里每个任务更便宜”,而在较高设置下两者表现可以相当、成本也相近。最后这半句才是关键:Anthropic 是在告诉你,effort 越高,两个模型的单任务成本差距越小,因为 Sonnet 会花更多 token。
独立证据
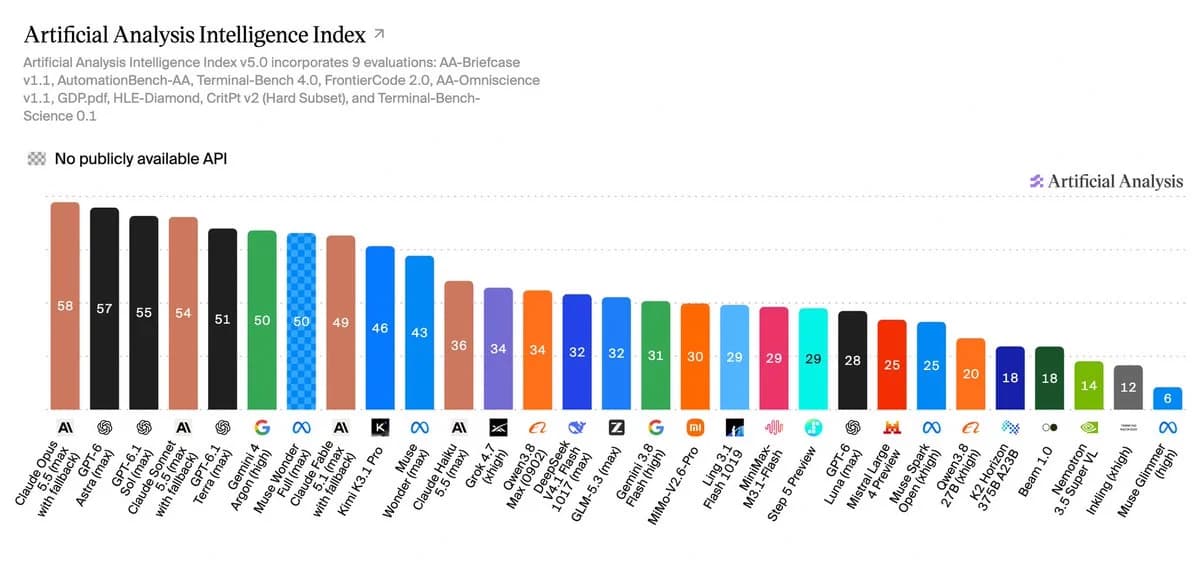
独立来源是 Artificial Analysis,它在 2026 年 10 月 27 日发布了智能指数 v5。第 5 版把九项评测分成四个等权组:知识工作、编程、科学与通用,各占 25%。编程组由占 15% 的 FrontierCode 2.0 和占 10% 的 Terminal-Bench 4.0 构成。AA 表示,现在指数的 60% 建立在私有或保留的测试集上,降低了厂商针对题目做调优的可能。
这篇文章里有三项结果与本次对比相关。max effort 的 Claude Opus 5.5 以 58 分领跑整个指数,领先 57 分的 GPT-6 Astra 和 55 分的 GPT-6.1 Sol。在 FrontierCode 2.0 上(Cognition 提供的 132 题私有基准,按维护者是否会合并改动来评分),max 档的 Opus 5.5 以 46% 领先,max 档的 Claude Sonnet 5.5 为 42%,与 GPT-6 Astra 和 GPT-6.1 Terra 并列。而在 AA-Briefcase 上,Sonnet 5.5 以 1812 Elo 领先所有被测模型。也就是说,独立的编程基准复现了 Anthropic 自己 FrontierCode 结果的方向:Opus 领先,Sonnet 在最高 effort 下落后几分;独立的知识工作基准则复现了另一个方向:Sonnet 与 Opus 持平或更高。
有两点要留意。AA 报告的是这些模型的 max effort 设置,也就是每条曲线上最贵的一端,所以这些分数对 medium 和 low 档位什么也说明不了,而 Sonnet 的成本优势恰恰在那里最大。AA 还指出,领先模型之间的单任务成本相差超过 13 倍,从最便宜的 0.96 美元,到 max 档 Claude Fable 5.1 的 13.04 美元;这个区间提醒我们,effort 和模型的选择对成本的影响,都比任何单一的 token 单价更大。我在这篇文章的正文里没有找到 Sonnet 5.5 或 Opus 5.5 的 Artificial Analysis 单任务成本数字,所以本文不引用。
Opus 5 与 Sonnet 5:已经收窄的差距
搜索上一对模型“Opus 5 对 Sonnet 5”的读者,通常想知道 5.5 这一代有没有改变两者的关系。答案是改变了,最清楚的证据就在 Anthropic 自己的表里。取两个发布页面上出现的 Sonnet 5 和 Opus 5 两栏:Terminal-Bench 4.0 上,Sonnet 5 得 10.3%,Opus 5 得 52.3%;FrontierCode 上,Sonnet 5 为 42.4%,Opus 5 为 48.0%;CursorBench 上,34.1% 对 46.6%。这些是对同名基准的跨页面比较,而不是同一次对跑,但它们描绘出了一个在智能体工作上大幅落后的 Sonnet。
Sonnet 5.5 把这个差距补上了大半。Anthropic 报告 Sonnet 5.5 在 Terminal-Bench 4.0 上为 70.6%,而 Sonnet 5 是 10.3%;CursorBench 上是 55.5%,对比 34.1%。它还说,在 FrontierCode 的 High effort 下,Sonnet 5.5 比同设置下的 Sonnet 5 高 10 分,而单任务成本只有约十五分之一。Sonnet 的价格表没有变,除了缓存读取减半之外仍是 2 美元和 10 美元,所以进步来自能力和 token 效率,而不是降价。Opus 5 的价格是 5 美元和 25 美元,缓存读取 0.50 美元,Opus 5.5 把它们降到了 4 美元、20 美元和 0.20 美元。如果你对 Sonnet 的印象还停留在 Sonnet 5 时代——那时做智能体编程只有 Opus 一个靠谱的选择——那么这个印象已经过时了。
单任务成本与公式
一个编程任务按四个量计费:新输入 token、缓存读取、缓存写入和输出 token。输出包括思考和工具调用参数,这正是 effort 会改变账单的原因。通用公式如下,价格单位为每百万 token 的美元数:
cost = (U x p_in + R x p_cache_read + W x p_cache_write + O x p_out) / 1,000,000
其中 U 是未缓存的输入 token,R 是缓存读取 token,W 是缓存写入 token,O 是输出 token。Opus 5.5 的价格为 4、0.20、5 和 20 美元,Sonnet 5.5 为 2、0.10、2.50 和 10 美元,均来自定价页。下面的负载形态只是示例,不是实测。
| 示例任务 | Token 数(U / R / W / O) | Opus 5.5 | Sonnet 5.5 |
|---|---|---|---|
| 小型 bug 修复 | 30k / 200k / 20k / 8k | $0.42 | $0.21 |
| 智能体循环中的中型功能 | 150k / 1.2M / 100k / 40k | $2.14 | $1.07 |
| 长时间重构会话 | 400k / 6M / 300k / 150k | $7.30 | $3.65 |
| 中型功能,Opus 快速模式 | 150k / 1.2M / 100k / 40k | $4.28 | 不适用 |
拿中间那一行手算一遍来验证。Opus 5.5:150,000 x $4 = $0.60;1,200,000 x $0.20 = $0.24;100,000 x $5 = $0.50;40,000 x $20 = $0.80。合计 $2.14。Sonnet 的每一项恰好是一半,所以总额是 $1.07。因为比例恒为 2,唯一重要的问题就是 token 倍数。如果 Sonnet 5.5 需要 1.5 倍的 token 才能达到同样的结果,这个任务花 $1.61,对比 Opus 的 $2.14,仍然省 25%;如果它需要两倍的 token,两者都是 $2.14,较便宜的模型就没有成本优势了。盈亏平衡点是 token 倍数 2.0。
这就是为什么“Sonnet 用 low 和 medium effort”这条建议站得住。Anthropic 的图表显示,两个模型的单任务成本都随 effort 上升,而 Low 档的 Sonnet 可以落在 Sonnet 5 最佳情形成本的大约十分之一。到了 xhigh 或 max,思考时间长得多的模型可以把 2:1 的价格比抹平,Anthropic 自己的文字里也这么说。如果你的测试框架无法统计每个被接受改动所消耗的 token,你就无从知道自己落在盈亏平衡点的哪一边。
另外两个杠杆也值得算一算。Batch API 对输入和输出各打 50% 折扣(五折),Anthropic 说这个折扣可以与缓存叠加。所以中型功能那一行通过 Batch API 跑 Opus 5.5,成本是 $2.14 x 0.5 = $1.07,与标准价格下的 Sonnet 5.5 相同。对不需要即时答复的工作,比如通宵生成测试或批量迁移,这让 Opus 在标价看上去不划算的地方成为候选。此外,Opus 5.5 和 Sonnet 5.5 的 1M 上下文窗口都按标准价格计费,没有长上下文附加费,所以 900,000 token 的请求,每个 token 的价格和 9,000 token 的请求一样。大型仓库的工作在这两个模型上都不会触发价格跳升。
公式没有覆盖的一项成本是重试。一个首轮通过率 90%、每次 $1.07 的模型,一旦把失败任务的审查时间和重跑算进去,每个被接受的改动就比通过率 70%、每次 $0.80 的模型更便宜。Anthropic 的合作方引述也围绕这个思路:Lovable 称用 Opus 5.5 完成构建的步骤少了三分之一到一半;Sonnet 页面里引述的一家 AI 应用构建合作方称,Sonnet 5.5 每次构建需要 3.6 次迭代,而 Opus 5 需要 7.7 次。这些都是合作方对自己测试框架的说法,请当作待验证的假设,而不是常数。
任务对应的模型与 effort
下表把证据转成起步建议。这些是待测试的建议,不是保证。effort 的建议在 Anthropic 有文档指引的地方遵循其指引,文档没有说明的地方则标注为我的推断。
| 任务 | 优先尝试的模型与 effort | 理由 | 依据 |
|---|---|---|---|
| 需求明确、只涉及一两个文件的 bug 修复 | Sonnet 5.5,medium | 文档建议需求明确的智能体任务从 medium 开始;每个 token 价格只有一半 | 文档指引 |
| 快速编辑、重命名、样板代码、测试桩 | Sonnet 5.5,low | 文档把 low 列给简单且对延迟敏感的工作;Anthropic 称 Low 在部分基准上胜过 Sonnet 5 的最佳成绩 | 文档加厂商图表 |
| 需求清晰的工单对应的多文件功能 | Sonnet 5.5,high | 这是 Sonnet 在较难或较长的智能体工作上的文档默认值 | 文档指引 |
| 含糊且需要设计判断的任务 | Opus 5.5,medium | Anthropic 称 Opus 在开放式工作上仍更强;medium 是它调校过的默认值 | 厂商表述 |
| 全代码库迁移或审计 | Opus 5.5,medium 到 xhigh | Anthropic 把长而庞杂的工作列为 Opus 的强项,并建议超过 30 分钟的会话用 xhigh | 厂商表述加文档 |
| 合并前的代码审查 | Opus 5.5,medium;或 Sonnet 5.5,high | 合作方引述称 Opus 在低 effort 下抓 bug 能力很强;请在你自己的 diff 上两个都跑一遍 | 合作方说法,需自行测试 |
| 做搜索或文件分拣的子智能体 | Sonnet 5.5,low | 文档点名子智能体是 low effort 的用途 | 文档指引 |
| 通宵批处理工作 | Opus 5.5 配合 Batch API | 50% 折扣让 Opus 降到 Sonnet 的标准价格 | 价格算术 |
| 对延迟敏感的结对编程 | Sonnet 5.5,medium;或 Opus 5.5 快速模式 | Sonnet 被标为快;Opus 快速模式价格翻倍 | 文档加价格 |
| 任一模型使用 max effort | 仅在评测显示有提升之后 | Sonnet 5.5 在 FrontierCode 上 Max 低于 Xhigh | 厂商脚注 |
有两行属于推断而非文档。把 Opus 与含糊的设计工作配对,是从 Anthropic 关于“持续判断”的那句话推出来的;Batch API 一行是算术,不是 Anthropic 的建议,而且只有当你的负载能容忍异步延迟时才成立。
论断与证据对照表
| 论断 | 出自 | 类型 | 怎样验证 |
|---|---|---|---|
| Opus 5.5 在典型工作负载上比 Opus 5 便宜 40% | Anthropic | 厂商自报 | 用默认设置在两个模型上各跑你自己的任务,比较花费 |
| Opus 5.5 为每 MTok $4 / $20;Sonnet 5.5 为 $2 / $10 | Anthropic 定价文档 | 一手来源,可查证 | 查看定价页;本文已确认 |
| Sonnet 5.5 缓存读取为 $0.10 | Anthropic 定价文档及 10 月 7 日的 X 帖子 | 一手来源,可查证 | 定价页显示 $0.10 |
| Sonnet 5.5 在 Terminal-Bench 4.0 上得分 70.6% | Anthropic | 厂商自报 | 公开的 Terminal-Bench 排行榜;未标明 effort |
| Sonnet 5.5 的 CursorBench 最佳成绩与 Opus 5.5 相差约两分 | Anthropic | 厂商自报 | 同一张表上的 55.5% 对 57.8% |
| Opus 5.5 在 FrontierCode 2.0 上以 46% 领先;Sonnet 5.5 为 42% | Artificial Analysis | 独立来源 | AA 发布的指数文章 |
| Opus 5.5 以 58 分居智能指数 v5 榜首 | Artificial Analysis | 独立来源 | AA 发布的指数文章 |
| Low 或 Medium 档的 Sonnet 5.5 以约十分之一的成本胜过 Sonnet 5 的最佳成绩 | Anthropic | 厂商自报 | 仅有图表;取决于测试框架和 token 数 |
| Sonnet 5.5 比 Sonnet 5 快 30% 以上 | Anthropic | 厂商自报 | 给你自己的运行计时 |
| Opus 5.5 比 Opus 5 快 30% 以上 | Anthropic | 厂商自报 | 给你自己的运行计时 |
| Opus 5.5 更擅长需要持续判断的开放式工作 | Anthropic 及其引述的外部测试者 | 厂商自报,定性 | 在你最难的工单上测试 |
| Sonnet 5.5 在 Max 档得分低于 Xhigh 档,原因是子智能体扇出 | Anthropic,引用 Cognition 对两个案例的检查 | 厂商自报,仅两个案例 | 本文未独立复现 |
迁移与破坏性变更
“sonnet 5.5 breaking changes”这类搜索反映的是一个真实问题:这个模型沿用了与前代相同的 ID 命名模式,却拒绝了 Sonnet 5 允许的好几种请求形态。Anthropic 的 what’s-new 页面为已在 Sonnet 5 上运行的代码列出了五项破坏性变更,外加一项不会让请求失败、但会改变响应的变更。模型 ID 由 claude-sonnet-5 改为 claude-sonnet-5-5,分词器与 Sonnet 5 相同,所以相同文本的 token 数不变。
| 变更 | 会发生什么 | 修复方式 |
|---|---|---|
| thinking 类型 disabled 被拒绝 | 带有 thinking 类型 disabled 的请求返回 400 invalid_request_error,并提示改用 between_tools | 发送 thinking 类型 between_tools 来关闭前置思考。它在 low、medium、high effort 下可用,在 xhigh 或 max 下返回 400 |
| 强制使用工具被拒绝 | tool_choice 类型为 any 或 tool 时返回 400 | 保持 tool_choice 为 auto,在提示词里说明何时应使用某个工具,并用严格工具调用(strict tool use)或结构化输出来保证输入符合 schema |
| thinking 块与模型和对话绑定 | 目标模型读不了的块会在模型看到之前被丢弃;在系统提示词、工具或更早消息发生变化后重放某个块,对 2026 年 8 月 31 日及之后创建的账号会返回 400 | 保持对话只追加;用对话中途的系统消息代替修改;或设置块绑定 beta 请求头,丢弃不匹配的块 |
| 不再接受 computer_20251124 工具 | 在 Claude API 和由 Google 托管的 Google Cloud 上的 Claude 模型中,声明该工具会返回 400 | 改用 computer_toolset_20260801 工具集。Amazon Bedrock 仍接受旧工具 |
| 部分 advisor 搭配被拒绝 | Sonnet 5.5 作为执行者时,不能把 Opus 4.8、Opus 4.7、Sonnet 5 或 Haiku 5.5 作为 advisor | 使用 Opus 5.5、Opus 5、Fable 或 Mythos 系列模型,或 Sonnet 5.5 本身作为 advisor |
| 工具调用之间的文字转入 thinking 块 | 在默认的 display 设置下,进度说明文字为空,所以把它流式推给用户的应用会在工具调用之间悄无声息地沉默,且不报错 | 设置能返回该文字的 display 值,或用 between_tools 关闭前置思考 |
thinking 块的规则,对混用多个模型的人有直接影响。Anthropic 的文档说,Sonnet 5.5 能读取来自 Sonnet 5、Opus 4.8、Haiku 4.5 及更早模型的 thinking 块,但读不了 Opus 5、Opus 5.5 或任何 Fable、Mythos 模型的;而在 Claude API 上,Opus 5.5 能读取 Sonnet 5.5 的块。因此,从 Sonnet 5.5 起步、再升级到 Opus 5.5 的对话会保留推理轨迹,反过来则后面几轮在没有它的情况下运行。被丢弃的块不计费,请求仍会成功,只是第二个模型在没有第一个模型推理轨迹的情况下起步。向上升级是成本更低的交接方式。
如果你是从 Opus 5 迁到 Opus 5.5,而不是从 Sonnet 5 迁,文档列出四项破坏性变更:不能再关闭 thinking、强制使用工具会报错、thinking 块与模型和对话绑定,以及旧的计算机使用工具在 Claude API 上被拒绝。对 Opus 5.5 而言,实际要处理的是第一项。如果你的测试框架在 Opus 5 上为了省钱而在 high 及以下的 effort 关闭了 thinking,替代做法是调低 effort,而不是关掉 thinking。按位置而不是按类型选取响应内容块的框架也会出问题,因为在默认 display 设置下,每个 Opus 5.5 的响应都可能以一个空的 thinking 块开头。
据此可以列出一份迁移清单。全局搜索 thinking 类型的字面量、任何强制使用工具的 tool_choice、旧的计算机使用工具类型,以及按下标读取第一个内容块的代码。更新模型 ID,显式设置 effort,而不是依赖两个模型各不相同的默认值,然后跑一遍你自己的 effort 扫描。Anthropic 的 Claude Code 自带迁移辅助功能,包括一个用于把 API 代码迁移到新模型的 migrate skill,不过我读到的文档只列出了它的名字,我没有实际测试过。
Claude Code 的默认设置
在 Claude Code 里,选模型用的是简短的别名。Claude Code 文档说,sonnet 选择最新的 Sonnet 用于日常编程任务,opus 选择最新的 Opus 用于复杂推理,在 Anthropic API 上这两个别名分别解析为 Sonnet 5.5 和 Opus 5.5。还有一个 opusplan 模式:规划模式用 Opus,随后切换到 Sonnet 执行,这是内置的、最简单的落地本文所推荐分工的办法——前期做判断,后面出量。Sonnet 5.5 要求 Claude Code 2.1.284 或更高版本,Opus 5.5 要求 2.1.280 或更高版本,所以版本太旧的安装会导致请求失败。
关于默认值,Anthropic 的 Sonnet 页面写道:在 Claude Code 和它的应用中,默认 effort 为 Medium,而 Claude Platform 默认为 High。这是产品页上的厂商表述,与 API 文档里关于 Sonnet 5 的措辞(API 和 Claude Code 里都是 high)不同。Sonnet 5.5 的 effort 文档说 high 是 Claude API 上的默认值,没有另行说明 Claude Code 的默认值,所以这两个页面并不严格矛盾:一个讲 API,一个讲产品。Claude Code 的确切默认值,请在你自己的会话里用 /effort 命令确认,不要从任何一个页面直接推断。Claude Code 模型配置文档还写明,子智能体的 frontmatter 可以同时设置 model 和 effort(skills 文档现在也为 SKILL.md 列出了可选的 model 与 effort 字段),其中 effort 字段会覆盖会话级别,但不会覆盖环境变量 CLAUDE_CODE_EFFORT_LEVEL。想了解更深入的工作流细节,请看 Claude Code 最佳实践指南;想看 Claude 以外的工具对比,请看英文的 2026 年最佳 AI 编程智能体榜单。
切换前的测试方案
Anthropic 自己的文档就让你在自己的评测上做 effort 扫描。下面是一个小到一下午就能跑完的版本。从你的仓库里挑 20 个已关闭、有已知正确 diff 的工单,十个简单、十个困难。把每个工单分别在 Sonnet 5.5 的 low、medium、high,以及 Opus 5.5 的 low、medium、high 下各跑一遍,共六种配置。每次运行记录四个数字:结果是否通过了你的测试;审查者是否会不加修改就合并;按类别统计的总 token 数;以及实际耗时。然后用上面的公式计算每个被接受改动的成本,而不是每次尝试的成本。
xhigh 只加在十个困难工单上,并且只用于 high 档下得分更高的那个模型。只有在 xhigh 显示出提升时才加 max,因为 Sonnet 的 FrontierCode 脚注就是在警告:别为超出任务所需的动作量付费。按文档的建议,把 max_tokens 设得宽裕并使用流式输出,否则运行会被截断,看上去就像质量问题。每个工单都在干净的分支上检出,免得模型看到自己之前的尝试。如果 medium 档的 Sonnet 在简单工单上的合并通过率与 Opus 相同,就把这类任务交给 Sonnet。如果 Opus 在困难工单上的通过率,使它较高的单次成本低于 Sonnet 含重跑在内的成本,就把这类任务交给 Opus。你的数据里分出来的这套分工,比任何公开图表都更值得信任,包括本文里的这些。
局限
- 本文所有 Anthropic 的基准都是厂商自报。包括 AutomationBench 和 CursorBench 在内的几项合作方基准是由合作方运行的,Anthropic 还披露,安全防护可能会拉低 Opus 5.5 在某些任务上的得分。
- Anthropic 表中两个模型的分数并不总是在同一档 effort 下,Terminal-Bench 4.0 一行也没有说明 Sonnet 的 effort。几分之内的差异都落在所给的标准误差范围内。
- Sonnet 5.5 在 GDPval-AA 和 AA-Briefcase 上的 Artificial Analysis 分数,来自一次带有结构化输出 bug 的预发布部署;Anthropic 说该 bug 已修复,并预计这会低估其表现。
- 本文的单任务成本表是基于示例 token 组合的算术。真实任务的 token 数会因测试框架、仓库和 effort 而差异很大。
- Sonnet 5.5 在 Claude Code 里的默认 effort,在 Anthropic 的两个页面上说法不同。我没有测试过。
- Anthropic 所说的 40% 与 30% 成本论断,来自它自己的“典型工作负载”测试,无法根据已发布的材料复现。
- 各模型 effort 图表是作为图片从 Anthropic 的帖子里转载的。我从中读取了坐标轴和标签,但不引用曲线上的精确点位。
结论
如果只要一条规则,那就是:每个编程负载都先用 medium effort 的 Sonnet 5.5 起步,衡量每个被接受改动的成本,把表现不佳的具体负载升级到 medium 或 high 的 Opus 5.5。理由都摆在页面上:Sonnet 5.5 每一项价格都是一半,在 CursorBench 上与 Opus 相差约两分以内,在 Terminal-Bench 那一行与 Opus 持平或更高,并且上下文窗口相同。Opus 5.5 的溢价体现在长周期、含糊和迁移规模的工作上:在 FrontierCode 上,Anthropic 和一个独立基准都把它放在前面,而且 Anthropic 称它用的 token 比上一代 Opus 更少。
把 max effort 当作两个模型上的特殊情形,而不是默认值。把标价只当成故事的一半,因为只要较便宜的模型需要两倍的 token,2:1 的价格比就消失了。在升级任何东西之前,先对照你的集成检查 Sonnet 5.5 的五项破坏性变更,因为这些失败表现为 400 错误和流式进度文字的悄然丢失,而不是缓慢的退化。你选哪个模型的重要性,不及你有没有做过测量。
常见问题
Opus 5.5 编程比 Sonnet 5.5 更好吗?
在长周期的 FrontierCode 基准上是的:Anthropic 报告 Opus 5.5 为 54.4%,而 Sonnet 5.5 在 Max 档为 46.2%(Xhigh 档为 52.1%);Artificial Analysis 在 FrontierCode 2.0 上也独立得出 Opus 46%、Sonnet 42%。CursorBench 上差距约两分,Terminal-Bench 4.0 的厂商表里 Sonnet 更高,但在噪声范围内。Anthropic 说,在需要持续判断的开放式工作上,Opus 仍然明显更强。
Opus 5.5 多少钱?
Opus 5.5 为每百万输入 token 4 美元、每百万输出 token 20 美元。缓存读取每百万 0.20 美元,5 分钟缓存写入 5 美元,1 小时缓存写入 8 美元。Batch API 请求享受 50% 折扣;快速模式(Anthropic 称最快可达 2.5 倍速)为每百万 token 输入 8 美元、输出 40 美元。
Claude 的 effort 档位有哪些?
五档:low、medium、high、xhigh 和 max,通过 output_config.effort 设置。Opus 5.5 与 Sonnet 5.5 都支持全部五档。Opus 5.5 与 Haiku 5.5 默认 medium;其他支持 effort 的模型,包括 API 上的 Sonnet 5.5,默认 high。把参数设为默认值,等同于不传该参数。
Opus 5.5 的默认 effort 与 high 档的 Opus 5 相比如何?
Opus 5 及更早的 Opus 默认 high。Opus 5.5 默认 medium,所以没有设置 effort 的请求,运行档位比在 Opus 5 上低一档。Anthropic 报告,在 Terminal-Bench 4.0 上,默认 effort 的 Opus 5.5 以约五分之一的成本击败了 max effort 的 Opus 5;这是厂商图表,请在自己的任务上确认。
从 Sonnet 5 迁到 Sonnet 5.5 会坏什么?
五种请求形态:thinking 类型 disabled 返回 400(改用 between_tools);强制 tool_choice 返回 400;thinking 块与模型和对话绑定,若之前的上下文发生变化可能返回 400;computer_20251124 工具在 Claude API 上被拒绝;以及 Sonnet 5.5 作为执行者时,有四个 advisor 模型被拒绝。此外,工具调用之间的文字也会转入 thinking 块,可能让流式的进度更新静默。
同一个任务,Sonnet 5.5 比 Opus 5.5 便宜吗?
按 token 计价,是的,每一项价格都正好是一半。按任务计则取决于 token 用量。如果 Sonnet 5.5 用了两倍的 token,成本就与 Opus 5.5 相同。Anthropic 说,Sonnet 5.5 在较低 effort 设置下与 Opus 搭配得最好,在较高设置下表现相当、成本相近。
Opus 5 和 Sonnet 5 哪个更好?
在 Anthropic 公布的表里,Opus 5 在智能体编程上遥遥领先:Terminal-Bench 4.0 上 52.3% 对 10.3%。这个差距在 Sonnet 5.5 上基本补上了,Anthropic 报告其为 70.6%。当前的工作请比较 5.5 这两个模型;在列出 Sonnet 5 的每一行表里,它都是较弱的选项。
我该用 max effort 吗?
只有当你的评测显示有提升时才用。Anthropic 自己的 Sonnet 5.5 FrontierCode 结果在 Max 档低于 Xhigh 档,它把原因归结为代码审查 skill 派生出大量子智能体,造成超时和超出范围的改动。Max 取消了对 token 花费的任何限制,所以成本与波动会一起升高。
来源
来源核对于 2026 年 10 月 28 日。
- Introducing Claude Opus 5.5 — Anthropic(基准、价格、effort 图表、合作方引述)
- Introducing Claude Sonnet 5.5 — Anthropic(含 Opus 一栏的基准表、脚注、价格、effort 默认值)
- Claude API 定价(所有价格项、批处理、快速模式、长上下文)
- Claude Opus 5.5 模型概览(上下文、输出上限、默认 effort、可用性)
- What’s new in Claude Opus 5.5 与 What’s new in Claude Sonnet 5.5(破坏性变更、迁移)
- Effort 参数文档(五个档位、各模型的指引)
- Claude Code 模型配置(别名、opusplan、最低版本)
- Artificial Analysis 智能指数 v5(独立指数、FrontierCode 2.0、AA-Briefcase)
- @claudeai 的 X 帖子:Opus 5.5 发布、定价、effort 图表、Sonnet 5.5 发布、缓存读取降价
- Claude 官方 YouTube 发布视频:Introducing Claude Opus 5.5 与 Introducing Claude Sonnet 5.5
相关阅读:Claude Sonnet 5 对比 Opus 4.8(英文)、Claude Fable 5.1 完整指南(英文)、2026 年最佳 AI 编程智能体(英文)、Claude Code 最佳实践指南,以及 GPT-6.1 Sol 指南。