9 月 29 日发布的内容
Ultrafast 是 OpenAI 针对对速度有极高要求的工作负载推出的高级速度层级。根据 2026 年 DevDay 的回顾,GPT-6 Astra Ultrafast 已于 2026 年 9 月 29 日在 API 以及 Pro 500 和 Enterprise 计划的 ChatGPT Work 和 Codex 中上线,而 GPT-6.1 Sol Ultrafast即将推出。
与此同时,OpenAI 推出了 Pro 500,据称其“提供我们最高的用量配额,是 ChatGPT Plus 配额的 25 倍”,并包含对 Ultrafast 的访问权限。此外,OpenAI 还重新开放了 Pro 200 订阅,用户可继续访问包括 GPT-6.1 Sol 在内的前沿模型。
这就是 Ultrafast。作为我们的高级速度层级,Ultrafast 在 Codex 中提供最高 8 倍的 Token 生成速度(每秒 300 个 Token),在 API 中最高可达 6 倍。
— @OpenAI September 29, 2026
Ultrafast 实际衡量的指标
OpenAI 的产品文档对该指标的描述异常精确,而这种精确性至关重要:Ultrafast “在 Codex 的标准模式下,Token 生成速度比 GPT-6 Astra 快 8 倍”。OpenAI 随后直接补充了注意事项—— 此对比衡量的是 Token 生成速度,而非计费费率或整体任务完成时间。
因此,“最高 8 倍速度”的准确解读是:Token 生成吞吐量最高提升 8 倍,在 Codex 中最高可达每秒 300 个 Token,在 API 中最高提升 6 倍。这并不意味着任务完成时间缩短了 8 倍。智能体(Agentic)工作不仅涉及 Token 输出,还包括工具调用、文件系统操作、网络往返和模型推理所耗费的时间。对于长文本生成任务,输出速度翻倍带来的实际耗时改善,远比那些受工具延迟主导的任务更为显著。
这也是 OpenAI 建议为此类工作负载使用 WebSockets 的原因。其 API 文档指出,如果没有持久连接,网络开销可能会抵消延迟方面的收益;并强烈建议在频繁进行工具调用的智能体应用中优先使用 WebSockets。
Pro 100、Pro 200 和 Pro 500
OpenAI 的 Pro 层级帮助文章现已列出三种月度 Pro 计划。价格和 Ultrafast 的包含情况详见文中的表格。
| 计划 | 月费 | Ultrafast | 备注 |
|---|---|---|---|
| Pro 100 | $100/month | Not included | Baseline Pro tier. Buying credits on Pro 100 does not unlock Ultrafast at launch. |
| Pro 200 | $200/month | Not included | More included usage than Pro 100. Reopened to new subscriptions; new non-grandfathered subscriptions include a lower usage allowance. |
| Pro 500 | $500/month | Included | Highest included usage of the three Pro plans and the only Pro tier with Ultrafast. Uses included usage first, then credits. |
以上价格摘自 OpenAI 于 2026 年 9 月 29 日发布的“关于 ChatGPT Pro 层级”帮助文章。订阅前请核实当前价格;计划结构可能会有所变动。
有两个结构细节容易被忽略。首先,Pro 500 是 仅限 包含 Ultrafast 的 Pro 层级, 购买 Pro 100 或 Pro 200 的额度并不会在发布时解锁 Ultrafast。其次,在 Pro 500 上,Ultrafast 会优先使用您套餐内包含的额度,待额度用尽后,再从您的充值余额中扣除。其他符合条件的功能也会优先消耗套餐内包含的额度,然后再使用充值额度。
Ultrafast 现已在 Codex、ChatGPT Work 和 API 中面向 GPT-6 Astra 开放,GPT-6.1 Sol 也即将推出。为了在 Codex 和 ChatGPT Work 中使用它,我们推出了 Pro 500——这是一个拥有我们最高使用限额的新套餐。
— @OpenAI September 29, 2026
计费倍率,而非速度
这是此次发布中最容易被误解的部分。OpenAI 为每个层级发布了两个不同的数字:速度数值和计费倍率。文档中明确指出,计费倍率并不代表速度提升。
| 层级 | 速度 | 扣除套餐内包含的限额 | 购买的额度 / 企业按量付费 |
|---|---|---|---|
| Fast mode | 1.5x for GPT-5.6 and GPT-5.5; model-dependent for other supported models | 2.5x the Standard rate | 2x the Standard rate |
| Ultrafast (GPT-6 Astra) | Up to 8x faster token generation than Standard in Codex | 8x the Standard rate | 6x the Standard rate |
因此,对于 GPT-6 Astra,Ultrafast 消耗套餐内限额的速度是 Standard 速率的 8 倍,而使用购买的额度或企业按量付费时,计费则是 Standard 速率的 6 倍。8 倍的计费倍率恰好与标题中 8 倍的速度数值吻合,这正是导致两者混淆的原因:它们是出于不同目的的独立数字。企业计费仍受工作区协议约束。
从规划角度来看,实际影响很简单:Ultrafast 以成比例的额度消耗换取速度。如果您的订阅额度是限制因素,那么启用 Ultrafast 更像是一个预算决策,而非性能设置。这也是为什么 OpenAI 将其限制在 Pro 500 和企业版之后,而不是将其作为面向所有人的开关。
哪些套餐和工作区可以获得访问权限
资格规则比标题暗示的更为严格,其中几项仅在文档中说明。
| Surface | 要求 |
|---|---|
| Codex and ChatGPT Work | Pro $500, plus eligible Enterprise and Edu plans. Enterprise workspaces have Ultrafast off by default and a workspace owner must enable it. |
| OpenAI API | Broadly available for GPT-6 Astra to all API users at low rate limits. Set model to gpt-6-astra and service_tier to ultrafast. |
| Other self-serve plans | No Ultrafast access at launch, even with purchased credits. |
| Inference residency | Ultrafast is not available to workspaces that require inference residency outside the United States. A workspace's location alone does not determine eligibility. |
针对企业买家的三个进一步细节。符合条件的企业工作区使用基于额度或基于美元的使用量协议,使用量将根据工作区的协议进行计费。符合条件的教育版(Edu)计划使用额度。而依赖速率限制而非基于使用量计费的旧版企业计划则 不受支持。现有的每用户支出控制适用于符合条件的 Ultrafast 使用量。
ChatGPT Work 和 Codex 也共享使用量:两者使用相同的定价、额度和使用限制。如果您在一个中启用了 Ultrafast,则会从另一个的同一资源池中扣除。
Pro 200 重新开放与保留条款(Grandfathering)
OpenAI 已重新开放 Pro 200 的新订阅,其条件具体如下。
- 新的 Pro 200 订阅可从定价页面购买,价格为每月 200 美元。
- 不符合保留条款(Grandfathering)资格的新订阅 包含的使用额度低于 此前 Pro 200 提供的额度,OpenAI 称这反映了其模型效率的不断提升。月费保持 200 美元不变。
- 如果您的 Pro 200 订阅在资格截止日期或截止前七天内处于活跃状态,您将保留之前包含的使用额度, 直至 2026 年 10 月 29 日 (前提是订阅保持活跃)。在该日期之后,订阅将调整为较低的使用额度,价格仍为 200 美元/月。
- 如果您的 Pro 200 订阅在那七天内失效,您仍可通过重新订阅获得之前的额度,直至 2026 年 10 月 29 日。
- 保留当前的额度并不会升级您的计划 或添加 Ultrafast。它仍然是 Pro 200。
OpenAI 表示,只有受额度变更影响的用户才会收到包含详细信息的电子邮件。如果您计划购买,请阅读额度条款而不仅仅是价格:保留条款(Grandfathering)下的 Pro 200 额度与新额度之间,在相同的 200 美元标价下,实际可用容量存在显著差异。
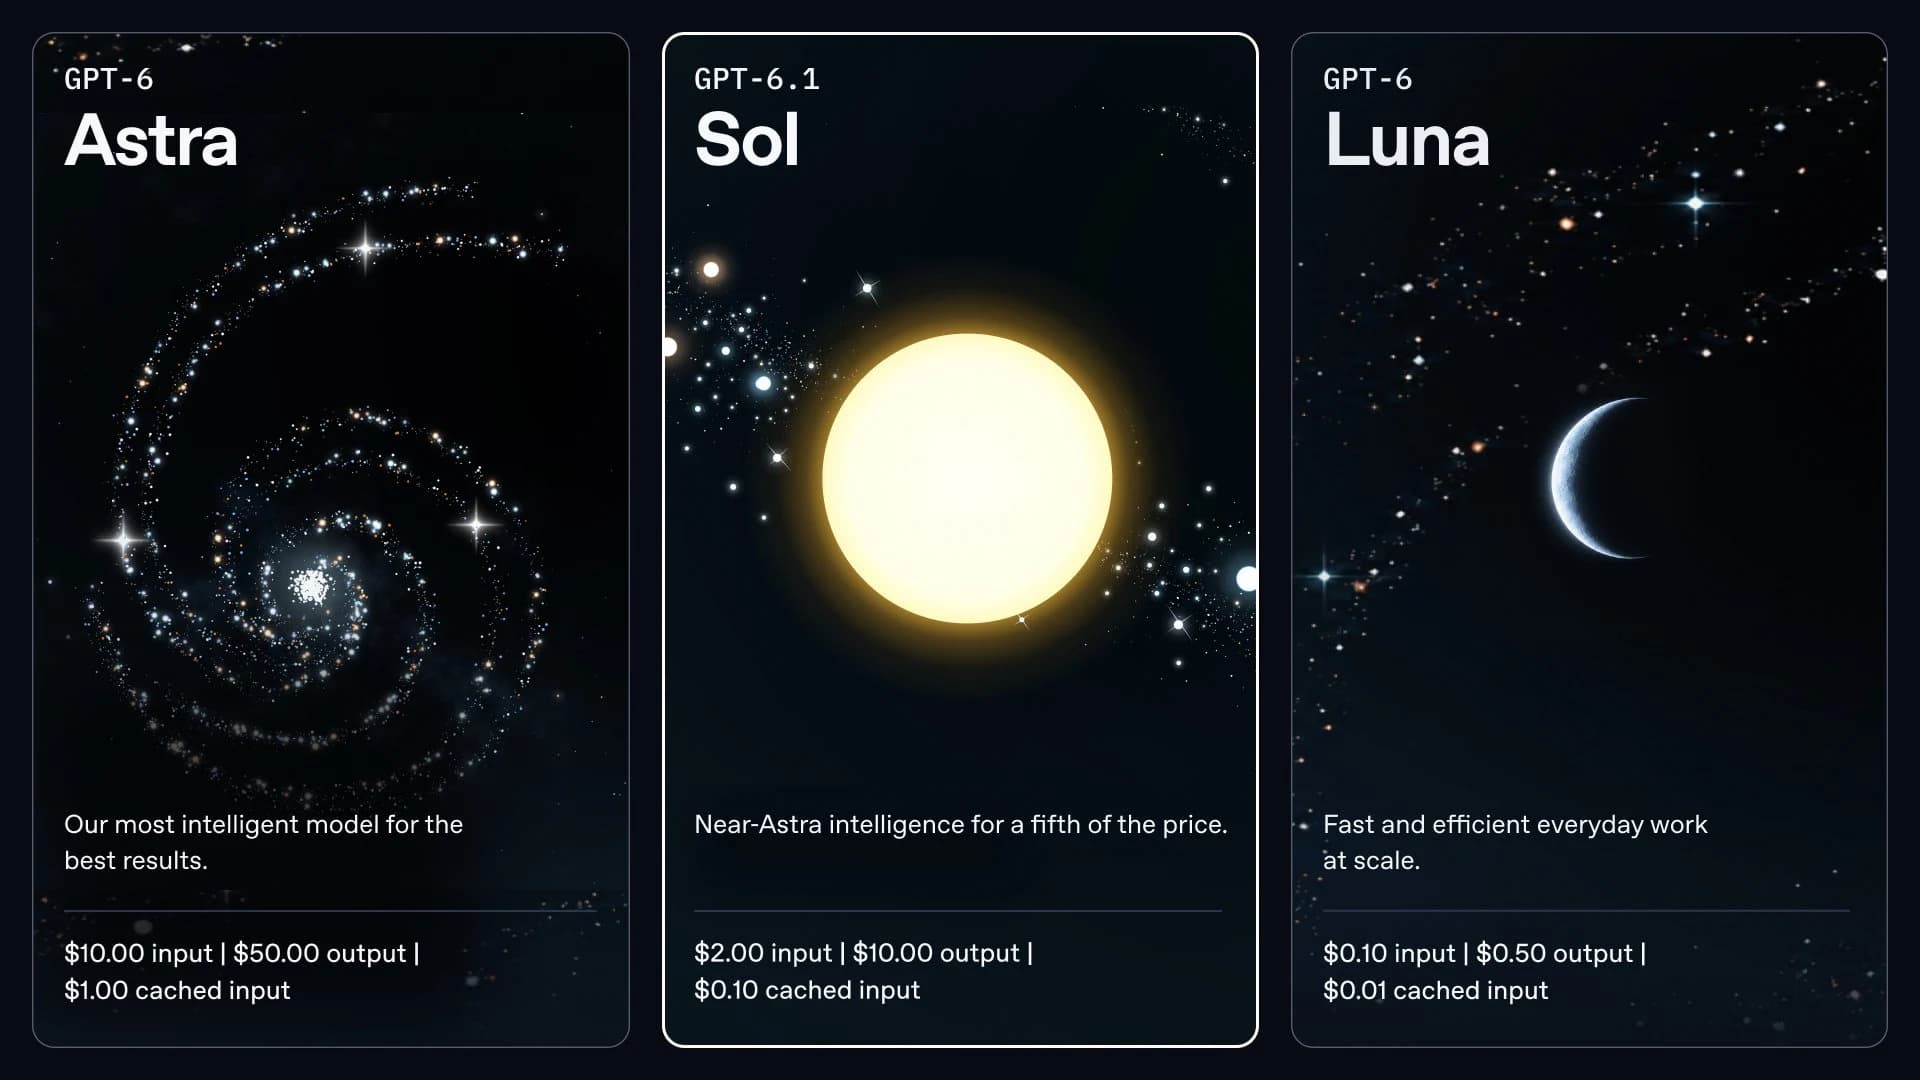
我们也重新开放了 Pro 200 订阅,并继续提供对 Astra 等前沿模型的访问权限,包括我们全新的 GPT-6.1 Sol 模型,它为您日常使用的模型带来了接近 Astra 的能力。
— @OpenAI September 29, 2026
OpenAI 的公开资料中未说明的一点是,除了计划价格以及 Pro 500 的“25× ChatGPT Plus 额度”框架之外,使用量的具体美元价值。回顾链接 chatgpt.com/pricing 以获取功能对比。我们未采用任何未在第一方来源中公布的额度面值。
在 API 中使用 Ultrafast
在 API 方面,OpenAI 提供 Ultrafast 模式作为最快的服务层级,广泛适用于 GPT-6 Astra,并向所有 API 用户开放低速率限制。如果贵组织有专门的 OpenAI 客户团队,OpenAI 建议联系他们以申请更高的速率限制。
该配置包含两个参数。将 model 设置为 gpt-6-astra 并将 service_tier 设置为 ultrafast 在每个请求中。
# Python (per OpenAI's Ultrafast mode docs)
# Install: pip install --upgrade "openai[realtime]"
# Set OPENAI_API_KEY in your environment.

from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-astra",
    input="Explain why the sky is blue in one sentence.",
    service_tier="ultrafast",
)

print(response.output_text)
对于包含多次工具调用的智能体循环(agentic loops),OpenAI 的文档模式建议复用同一个 WebSocket 连接,并将每个先前的响应 ID 作为 previous_response_id 传入,这样后续的轮次将从之前的响应继续,而无需重新发送整个交互过程。OpenAI 的示例展示了如何在同一连接上流式传输两个响应,并将其复用于后续的轮次和工具结果。
虽然也存在 HTTP 路径,但文档明确指出,当工具调用频繁时,推荐使用持久化的 WebSockets,因为每个请求的连接开销会抵消掉延迟方面的优势。
一个重要的计费说明:使用 API key 时,Codex 采用 API token 定价,ChatGPT 的额度倍数不适用。上述提到的 8 倍和 6 倍额度倍数仅适用于 ChatGPT 订阅计划;API 使用量按公布的 API 费率以 token 为单位进行计量。
Fast Mode 和 Ultrafast 是不同的
OpenAI 还有一个较低的层级称为 Fast mode,混淆这两者是一个常见的错误。Fast mode 可以加速受支持的模型。OpenAI 列出了 GPT-6.1 Sol、GPT-6 Astra、GPT-6 Sol 和 GPT-6 Luna 作为受支持模型(视可用情况而定),对于 GPT-5.6 和 GPT-5.5,文档记录的速度提升为 1.5 倍。它使用包含的订阅额度,费率为标准费率的 2.5 倍;购买的额度和企业版按量付费模式则按标准费率的 2 倍计费。
功能覆盖范围是另一个区别。Fast mode 可在 ChatGPT 桌面应用、Codex CLI 以及使用 ChatGPT 登录后的 IDE 扩展中使用,在 CLI 中通过 /fast 进行切换,使用 /statusline 在页脚显示,或通过 service_tier = "fast" 加 [features].fast_mode = true 在中进行持久化配置。 config.toml相比之下,Ultrafast 仅限于 Pro 500 以及符合条件的 Enterprise/Edu 工作区使用。
OpenAI 也在其模型文档中指出,GPT-6.1 Sol 在可用区域支持 Standard 和 Fast 模式。这就是为什么 Sol 今天出现在 Fast 模式中,而 Sol Ultrafast 显示为“即将推出”是前后一致的,而非相互矛盾。
GPT-5.5 的停用日期
同一套文档中明确给出了截止日期: GPT-5.5 将于 2026 年 10 月 14 日从所有计划的 ChatGPT、ChatGPT Work 和 Codex 中停用。OpenAI API 不受影响。如果你在 ChatGPT 或 Codex 工作流中依赖 GPT-5.5,这属于近期需要处理的迁移事项,而非后台关注项。
选择层级
现在有四个选项并列,它们不可互换。下表将决策与约束条件而非标题数字对应起来。
| 如果你的约束条件是…… | 考虑 | 原因 |
|---|---|---|
| 每个已完成任务的成本 | GPT-6.1 Sol(Standard 速度) | 每百万 token 输入 $2,输出 $10,缓存输入 $0.10;在智能体编码和计算机使用方面,据供应商报告其性能接近 Astra。 |
| 峰值输出吞吐量 | GPT-6 Astra Ultrafast | Codex 生成速度最高可提升至 8 倍(每秒 300 tokens)。需要 Pro 500 或符合条件的 Enterprise/Edu 账户。 |
| 最高推理质量 | 标准负载下的 GPT-6 Astra | Astra 在 OpenAI 最严苛的科学基准测试中仍保持最高得分,且测得的未对齐结果率(misaligned-outcome rate)最低。 |
| 智能体循环(agentic loop)中的全任务延迟 | 优先修复传输层 | 任何层级都无法解决工具延迟问题。文档明确指出,持久化的 WebSocket 连接是获得 Ultrafast 性能提升的前提条件。 |
Ultrafast 实现说明
如果你决定采用 Ultrafast,OpenAI 文档中的以下四个细节将为你节省时间。
- 在多轮对话和工具调用结果中复用同一个连接。 OpenAI 的示例通过同一个 WebSocket 流式传输两个响应,并将第一个响应的 ID 作为
previous_response_id传递给第二个响应。同样的模式也适用于工具调用结果:保持连接开启,而不是每次调用都重新连接。 - 处理故障事件类型。 OpenAI 的示例代码将
response.failed和response.incomplete视为错误条件,并在响应完成前连接中断时单独抛出异常。在智能体循环中,静默断开连接是最容易被误认为是模型问题的故障模式。 - 不要假设 HTTP 等同于 WebSocket。 Ultrafast 通过 SDK 支持 HTTP,但 OpenAI 指出,对于频繁调用工具的智能体应用,应使用持久化 WebSocket 以减少请求间的开销。如果你在无状态 HTTP 上对 Ultrafast 进行基准测试且仅看到微小的提升,这是预期结果,而非 Bug。
- 如果你同时使用这两个界面,请协调好两套计费系统。 使用 API key 时,Codex 采用 API token 定价,ChatGPT 额度乘数不适用。白天使用 ChatGPT Work 而在 CI 中使用 API key 的团队,针对同一模型会通过两种不同的机制计费,除非你预先决定好各工作负载的支付方式,否则这会使内部成本归因变得复杂。
文档中也间接回答了关于容量的问题:所有 API 用户均可在低速率限制下使用 GPT-6 Astra 的 Ultrafast 模式,OpenAI 表示如需更高限额,请联系您的客户团队。如果 Ultrafast 成为生产环境功能的负载核心,那么与团队沟通才是扩展路径,而非通过自助设置解决。
何时付费购买
如果满足以下条件,请购买 Pro 500: 您的工作受限于生成吞吐量而非工具延迟,且您已经用完了较低层级的大部分配额。Pro 500 是唯一包含 Ultrafast 的 Pro 计划,因此它是个人用户评估该层级的唯一途径,无需通过企业协议。其 8 倍的使用量乘数意味着它消耗配额的速度与生成 token 的速度相当,因此请做好管理剩余额度的准备。
如果满足以下条件,请在 API 中使用 Ultrafast: 您正在构建一个对延迟敏感的应用程序,并且可以围绕持久的 WebSocket 连接重构客户端。OpenAI 的官方文档警告称,如果不进行此项更改,网络开销可能会抵消性能提升。GPT-6 Astra 的 Ultrafast 模式目前已向所有 API 用户开放,且速率限制较低,这使其成为比 500 美元订阅费更具性价比的评估方式。
如果满足以下条件,请保持现状: 您的瓶颈在于推理质量或单项任务的完成成本,而非每秒 token 生成速度。GPT-6.1 Sol 的输入成本为每百万 token 2 美元,输出成本为 10 美元,缓存输入为 0.10 美元,这是实现成本效益的关键,且 Sol Ultrafast 目前尚未全面开放。此外,如果您的 Pro 200 订阅处于保留期(grandfathering window),且您主要想保留现有配额,也请保持现状。OpenAI 指出,保留配额并不会自动升级或添加 Ultrafast,因此这两项决策是独立的。
FAQ
Ultrafast 有多快?
OpenAI 报告称,在 Codex 中 token 生成速度最高可提升 8 倍(每秒 300 个 token),在 API 中最高可提升 6 倍(相对于标准模式下的 GPT-6 Astra)。文档说明该指标衡量的是 token 生成速度,而非计费速率或整体任务完成时间。
哪些 ChatGPT 计划包含 Ultrafast?
在 Pro 计划中,仅每月 500 美元的 Pro 500 包含此功能。Ultrafast 也适用于符合条件的企业版和教育版计划中的 Codex 和 ChatGPT Work,但默认处于关闭状态,需由工作区所有者手动启用。其他自助服务计划在发布时无法使用,即使购买了额度也不行。
在 500 美元的计划之外,使用 Ultrafast 是否需要额外付费?
Ultrafast 会优先使用您的包含配额,配额用尽后将扣除您的信用余额。对于 GPT-6 Astra,包含的订阅限额消耗速度是标准速率的 8 倍;购买的额度和企业版按量付费的使用量则按标准速率的 6 倍计费。
我可以通过购买额度在 Pro 100 或 Pro 200 上使用 Ultrafast 吗?
不能。OpenAI 表示,在发布初期,在 Pro 100 或 Pro 200 上购买额度无法解锁 Ultrafast。
Pro 200 计划重新开放了吗?
是的,每月 200 美元。不符合保留期资格的新订阅,其使用配额比之前提供的要低。在截止日期当天或之前七天内处于活跃状态的订阅,在 2026 年 10 月 29 日之前仍可保留之前的配额。
GPT-6.1 Sol 何时支持 Ultrafast?
OpenAI 将 GPT-6.1 Sol Ultrafast 列为“即将推出”,GPT-6.1 Sol 发布页面称其将在未来几天内提供,与 Codex 中的标准速度相比,token 生成速度最高可提升 8 倍。目前尚未公布具体日期。
为什么 Ultrafast 需要 WebSockets?
OpenAI 强烈建议在 Ultrafast 中使用 WebSockets,特别是对于需要快速连续进行多次工具调用的智能体应用,因为如果没有持久连接,网络开销会抵消延迟方面的性能提升。
Ultrafast 适用于所有模型吗?
不适用。它目前广泛适用于 GPT-6 Astra,并为 GPT-5.6 Sol 提供预览访问权限。OpenAI 表示 GPT-6.1 Sol Ultrafast 将在未来几天内推出。此外,GPT-5.5 定于 2026 年 10 月 14 日从所有方案的 ChatGPT、ChatGPT Work 和 Codex 中退役,但 API 不受影响。
我可以关闭 Ultrafast 吗?
可以。在 Enterprise 和 Edu 版本中,它默认处于关闭状态,直到工作区所有者启用它。在 Pro 500 中,你可以在模型选择器中进行选择,因此这是针对单次对话的设置,而非永久性的方案设置。之所以需要谨慎使用,是因为其倍率:包含的使用额度消耗速度是 Standard 速率的 8 倍,因此如果会话一直保持在 Ultrafast 模式,消耗额度的速度会比单纯的 token 计数所显示的要快得多。
本文是如何核实的?
文中所有数据均来自 OpenAI 官方资料,核实日期为 2026 年 9 月 29 日:包括 DevDay 2026 回顾、Ultrafast API 指南、ChatGPT 和 Codex 文档中的速度说明、Pro 层级帮助中心文章、GPT-6.1 Sol 发布公告以及 @OpenAI 的官方发布帖。文中未使用任何第三方基准测试、其他媒体的截图或未发布的定价信息。对于 OpenAI 未公布的数据(如绝对额度余额、模型级 Ultrafast 限制或 Sol Ultrafast 的具体日期),本文均如实说明,而非进行估算。
来源
- OpenAI — DevDay 2026 回顾(Ultrafast 可用性、Pro 500、公告列表)
- OpenAI — 速度文档(Ultrafast 和 Fast 模式、计费倍率、资格要求、驻留规则)
- OpenAI — API 中的 Ultrafast 模式(service_tier、WebSocket 指导、速率限制、代码示例)
- OpenAI 帮助中心 — 关于 ChatGPT Pro 层级(Pro 100、Pro 200、Pro 500 价格及老用户保留政策)
- OpenAI — WebSocket 模式(Ultrafast 循环的增量输入)
- OpenAI — GPT-6.1 Sol 介绍(Sol Ultrafast 即将推出、token 价格)
- @OpenAI on X — Ultrafast 公告(8x Codex、6x API、300 tokens/秒)
- @OpenAI on X — Pro 500 介绍及 Ultrafast 可用性
- @OpenAI on X — Pro 200 重新开放
Agentpedia 相关内容: GPT-6.1 Sol:基准测试、定价和 API 指南, DevDay 2026:OpenAI 发布的所有内容, Antigravity 额度与定价详解, 以及 2026 年最便宜的 AI 编程模型.
Get the latest on AI, LLMs & developer tools
New MCP servers, model updates, and guides like this one — delivered weekly.