先看两条发布帖,因为它们定下了基调。Sundar Pichai 和 Logan Kilpatrick 于 2026 年 11 月 12 日相隔约三分钟先后发布。
Following Carbon + Argon, Gemini 4 Hydrogen brings cutting-edge intelligence to everyone. Built for speed and efficiency for everyday tasks, coding and agentic workflows. Compared to 3.8 Flash, it finishes tasks 2.5x faster. Also has 4 thinking levels, so you only wait and pay
— @sundarpichai November 12, 2026
Introducing Gemini 4 Hydrogen, an extremely capable and fast model built to bring Gemini 4 to everyone! Available to all tiers of Google AI Studio, Gemini API, Gemini for business, the Gemini app, Google Search, and paid Google AI Pro + Ultra subscribers in Google Antigravity.
— @OfficialLoganK November 12, 2026
简短回答
Gemini 4 Hydrogen(API 模型 ID 为 gemini-4-hydrogen)是 Google 2026 年 11 月 12 日发布的快速、低价 Gemini 4 模型,接替 Gemini 3.8 Flash。价格为每百万输入 token $1.50、每百万输出 token $7.50(含思考),在 1M token 上下文内保持不变。它有四档思考(low、medium、默认的 high,以及新增的 xhigh),可在 Gemini API 和 Google AI Studio 的免费层使用,也在 Gemini 应用中、对所有用户的 Google 搜索中,以及面向付费 Google AI Pro 和 Ultra 订阅用户的 Google Antigravity 中提供。
有四点要提醒,才不会被标题带偏。第一,Hydrogen 不是 Google 最强的模型。Google 的模型卡说它由 Gemini 4 Carbon 改造而来,并把 Carbon 和 Argon 定位为深度、长程推理的工具,Hydrogen 则是快速执行模型。第二,最醒目的基准说法,即 Hydrogen 在 Artificial Analysis 智能指数上超过 Argon(默认 high 档 51 对 50,xhigh 档 54),出自 Google 自己的发布帖;而我们读到的 Artificial Analysis 独立页面只列出 xhigh 的测试,并标注它非常啰嗦。第三,Google 公布的基准表把 Hydrogen 与 Claude Sonnet 5.5 和 GPT-6.1 Terra 对比,行是自己挑的,其中十行里有三行 Sonnet 5.5 领先。第四,相对 Carbon 和 Argon 它便宜,但相对 Gemini 3.8 Flash 并不便宜,后者在 2026 年底前价格更低。
本文没有做实际动手测试。下面每个数字都来自旁边写明的来源,并标注为厂商自报、独立或媒体。本文与我们的 Gemini 4 Carbon 指南和 Gemini 4 Argon 指南配套;想看上一代 Flash 档请读 Gemini 3.8 Flash 指南。
视频:Single-Shot Website: Gemini 4 Hydrogen,来自 Google YouTube 频道的官方短片,Google 也把它嵌入了发布帖,展示 Hydrogen 借助 Antigravity 中的 Gemini 前端设计技能一次生成电商店铺页面。
Google 宣布了什么
主要来源是 Koray Kavukcuoglu 的文章 Introducing Gemini 4 Hydrogen。核心信息是:Carbon 和 Argon 这类前沿模型擅长最难问题上的深度、长程推理,Hydrogen 则为各类智能体工作流中的快速执行而造。Google 补充说,Hydrogen 既可以单独作为日常模型,也可以与 Carbon、Argon 搭配,充当高效率的执行引擎。同时它说此次发布把 Gemini 4 带给所有人:Google AI Studio 的所有层级、Gemini API、Gemini for business、Gemini 应用、Google 搜索,以及 Google Antigravity 中付费的 Google AI Pro 和 Ultra 订阅用户。
文中的主要说法都是 Google 自报:Hydrogen 在 Artificial Analysis 智能指数默认 high 档得 51 分,高于 Argon 的 50,xhigh 档达到 54。相对 Gemini 3.8 Flash,默认设置下任务完成快 2.5 倍,Terminal-Bench 4.1 得分 57% 对 18.2%,编造性陈述减少超过 5 倍。它能并行批量发出读文件和搜索调用,Google 说在复杂图、SQL 和数据密集的企业工作流的早期合作伙伴测试中,Hydrogen 比 3.8 Flash 快 2 到 2.8 倍,token 用量少 12% 到 23%。
另有一篇由 Robby Stein 撰写的 Google 搜索文章,称 Hydrogen 是搜索迄今最大的模型升级,面向全球所有用户,带来更好的意图理解、更好的查询扩散与链接、更多可视化回答,以及在所有受支持的 AI Mode 语言中更丰富的语言理解。Antigravity 博客补充了下文介绍的 Orchestrator 模型选项,DeepMind 模型卡载有基准表和安全说明。

| 日期 | 事件 | 来源 |
|---|---|---|
| 2026 年 10 月中旬 | Gemini 4 Argon 发布(我们读到的来源没有给出确切日期) | 我们的 Carbon 指南 |
| 2026 年 10 月 28 日 | Gemini 4 Carbon 宣布 | 我们的 Carbon 指南;Google 博客 |
| 2026 年 11 月 10 日 | Carbon 全面可用,优惠价 $2/$10 | 我们的 Carbon 指南;定价页 |
| 2026 年 11 月 12 日 | Hydrogen 宣布并在 API、应用、搜索和 Antigravity 推出;模型卡发布 | Google 博客;模型卡 |
| 2026 年 11 月 30 日 | Carbon 与 Argon 的 $2/$10 优惠价结束 | Gemini API 定价页 |
| 2026 年 12 月 31 日 | Gemini 3.8 Flash 的 $0.75/$3.75 价格结束 | Gemini API 定价页 |
| 2027 年 1 月 1 日 | Gemini 3.8 Flash 涨到 $1.50/$7.50,与 Hydrogen 相同 | Gemini API 定价页 |
Hydrogen 与 Carbon、Argon、3.8 Flash
Gemini 4 家族现在有三个档位,共用同一套 API 设计、同一个 1M 统一上下文窗口和同样的内置工具。Google 的 What’s new 页让你按推理深度、延迟和成本目标来选。Gemini 3.8 Flash 是 Hydrogen 要取代的模型。
| 模型 | 模型 ID | 每百万 token 价格(输入 / 输出) | 思考档位 | 定位(Google 的说法) |
|---|---|---|---|---|
| Gemini 4 Hydrogen | gemini-4-hydrogen | $1.50 / $7.50,整个 1M 上下文内不变 | low、medium、high(默认)、xhigh | 快速高效的执行:日常编码、交互式网页应用、会用工具的智能体、多模态文档工作、并行子智能体 |
| Gemini 4 Carbon | gemini-4-carbon | 到 2026 年 11 月 30 日为 $2 / $10;12 月 1 日起 $4 / $20 | low、medium(默认)、high | 最强前沿模型:困难的架构、调试、科学和安全审计 |
| Gemini 4 Argon | gemini-4-argon | 到 2026 年 11 月 30 日为 $2 / $10;12 月 1 日起 $4 / $20 | low、medium(默认)、high | 处理多数高级长程任务,token 用量低于 Carbon |
| Gemini 3.8 Flash | gemini-3.8-flash | 到 2026 年 12 月 31 日为 $0.75 / $3.75;2027 年 1 月 1 日起 $1.50 / $7.50 | 默认 medium | 上一代 Flash 档;Google 推荐升级到 Hydrogen |
有两点值得注意。Hydrogen 比 Carbon 和 Argon 的优惠价便宜 25%,比它们 12 月价格便宜 62.5%($1.50 对 $4,$7.50 对 $20),也就是按标价只有 Carbon 12 月 1 日起价格的 37.5%。而且它的默认思考档比它们高:Google 的迁移说明写道,Hydrogen 默认 high 并支持 xhigh,而 Carbon 和 Argon 默认 medium、上限是 high。比较每个任务的成本时这一点很重要,因为用默认值发出的请求,思考量并不相同。
Google 推荐的做法是搭配使用:让 Carbon 规划系统接口或解决棘手的阻塞,再把代码编辑、并行子智能体工作和测试运行交给 Hydrogen。这正是 Orchestrator 背后的思路。如果你只想用一个模型,Google 对从 Gemini 3.8 Flash 及更早版本升级的多数场景推荐 Hydrogen。同一页说明,Gemini 3.5 Flash-Lite(gemini-3.5-flash-lite)仍留给大批量分类、路由和亚秒级延迟目标。
规格与模型 ID
确切的 Gemini API 模型 ID 是 gemini-4-hydrogen。它是模型页上的 model code,出现在 What’s new 页的快速入门中,也出现在定价页的 AI Studio 链接里。模型页只列出一个稳定版本,字符串与此相同。我们没有发现单独的带日期或预览别名。
| 属性 | 取值 | 来源 |
|---|---|---|
| 模型 ID | gemini-4-hydrogen | Gemini API 模型页 |
| 基础 | 由 Gemini 4 Carbon 改造而来 | DeepMind 模型卡 |
| 输入 | 文本、图像、视频、音频和 PDF | Gemini API 模型页 |
| 输出 | 仅文本(不支持图像生成和音频生成) | Gemini API 模型页 |
| 上下文窗口 | 1,048,576 token,输入、思考和输出共用一个窗口 | Gemini API 模型页 |
| 最大输出 | 同步默认 65,536;长解码最多 1,048,576 | Gemini API 模型页 |
| 思考档位 | low、medium、high(默认)、xhigh;minimal 会被拒绝 | What’s new 页 |
| 知识截止 | 2026 年 3 月(部分领域可能更旧) | DeepMind 模型卡 |
| 工具 | 函数调用、代码执行、computer use、结构化输出、URL 上下文、文件搜索、Google 搜索与 Google 地图接地、智能体式视频理解 | Gemini API 模型页 |
| 不支持 | Live API、显式上下文缓存、图像生成、音频生成 | Gemini API 模型页 |
| 使用方式 | Standard、Batch API、Flex 推理、Priority 推理 | Gemini API 模型页;定价页 |
| 权重 | 专有并托管;Artificial Analysis 标为专有 | Artificial Analysis |
定价与成本示例
定价页给 Hydrogen 的是付费层统一标准价,覆盖整个 1M 上下文,没有优惠期。免费层不收费但有限速。和其他 Gemini 4 模型一样,Google 对模型处理的每个 token 计数计费,包括思考 token,以及使用接地时的内部工具系统指令和函数声明。Google 搜索接地在免费层不可用;付费层每月 5,000 次免费请求(在 Gemini 3 及更新模型间共享),之后每 1,000 次 $14,每日上限 1,500 次。
| 项目(每百万 token) | 免费层 | 付费层 |
|---|---|---|
| 输入,Standard | 免费 | $1.50 |
| 输出,Standard(含思考) | 免费 | $7.50 |
| 缓存输入(仅隐式) | 免费 | $0.075 |
| 输入 / 输出,Batch 与 Flex | 不可用 | $0.75 / $3.75 |
| 缓存输入,Batch 与 Flex | 不可用 | $0.0375 |
| 输入 / 输出,Priority | 列为免费 | $2.70 / $13.50 |
| 缓存输入,Priority | 列为免费 | $0.135 |
| 内容用于改进 Google 产品 | 是 | 否 |
成本计算示例
以下是按上表标价算出的数字,不是实测账单。一个请求有 200K 未缓存输入 token 和 30K 输出 token(含思考),Standard 下成本为 0.2 x $1.50 + 0.03 x $7.50 = $0.525。如果其中 150K 输入命中隐式缓存,则为 0.05 x $1.50 + 0.15 x $0.075 + 0.03 x $7.50 = $0.075 + $0.01125 + $0.225,约 $0.31。用 Batch 或 Flex 处理未缓存版本是 $0.2625。上限为 262,144 输出 token 的长解码任务,按 Standard 价输出部分最多约 $1.97,不含输入。
同样 200K 输入、30K 输出且未缓存的请求,按 Carbon 的价格($2/$10,12 月 1 日起 $4/$20)为 $0.70 和 $1.40。Gemini 3.8 Flash 到 2026 年 12 月 31 日为 $0.2625,2027 年 1 月 1 日起为 $0.525,与 Hydrogen 相同。所以如果你今天在用 3.8 Flash,换成 Hydrogen 会让单价翻倍,直到 Flash 涨价为止,赌的是更快、更准的运行能把差价抵回来。不同模型和思考档的 token 数不同,请把这些数字当作预算上限,而不是预测。
基准(按来源标注)
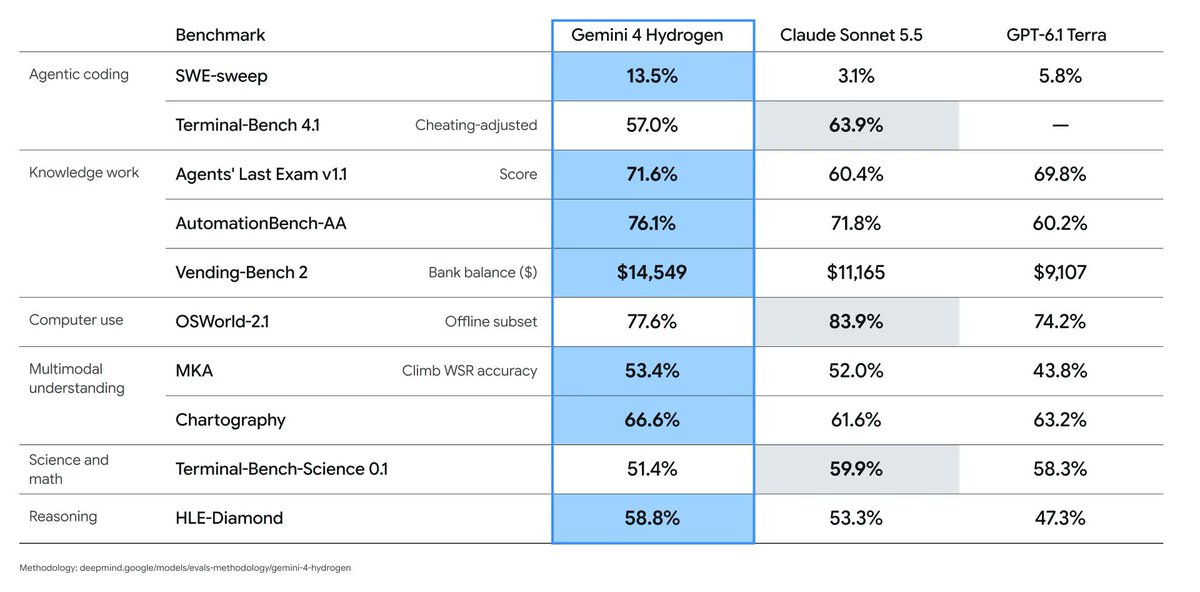
本节所有数字都是厂商自报:基准、对手模型和设置都由 Google 选定。表格抄自 DeepMind 模型卡,它把 Hydrogen 与 Claude Sonnet 5.5、GPT-6.1 Terra 在 2026 年 11 月的结果放在一起比较。方法说明在模型卡链接的 Google 评测方法页。
| 类别 | 基准(备注) | Gemini 4 Hydrogen | Claude Sonnet 5.5 | GPT-6.1 Terra |
|---|---|---|---|---|
| 智能体编码 | SWE-sweep | 13.5% | 3.1% | 5.8% |
| 智能体编码 | Terminal-Bench 4.1(已排除作弊) | 57.0% | 63.9% | 未列出 |
| 知识工作 | Agents’ Last Exam v1.1(得分) | 71.6% | 60.4% | 69.8% |
| 知识工作 | AutomationBench-AA | 76.1% | 71.8% | 60.2% |
| 知识工作 | Vending-Bench 2(银行余额) | $14,549 | $11,165 | $9,107 |
| Computer use | OSWorld-2.1(离线子集) | 77.6% | 83.9% | 74.2% |
| 多模态 | MKA(Climb WSR 准确率) | 53.4% | 52.0% | 43.8% |
| 多模态 | Chartography | 66.6% | 61.6% | 63.2% |
| 科学与数学 | Terminal-Bench-Science 0.1 | 51.4% | 59.9% | 58.3% |
| 推理 | HLE-Diamond | 58.8% | 53.3% | 47.3% |
按 Google 自己的说法来读这张表:Hydrogen 在十行中领先七行。差距最大的是 SWE-sweep,要求它找到并修复 bug 而不破坏已有代码(13.5% 对 3.1% 和 5.8%)。Claude Sonnet 5.5 在 Terminal-Bench 4.1、OSWorld-2.1 和 Terminal-Bench-Science 0.1 上领先,这几项分别对应命令行工作、computer use 和科学任务;在 Terminal-Bench-Science 0.1 上 GPT-6.1 Terra(58.3%)也高于 Hydrogen。Terminal-Bench 4.1 一行标注为已排除作弊,且没有 GPT-6.1 Terra 的数字。这些都是厂商给出的单个数字,我们读到的内容里没有误差范围或运行次数,所以几个百分点的差距不应决定采购。
发布文章中的其他厂商自报说法
| 说法 | 数字 | 备注 |
|---|---|---|
| Artificial Analysis 智能指数 | high(默认)51,xhigh 54;Argon 50 | Google 的说法;AA 页面列的是 xhigh(见下一节) |
| 相对 Gemini 3.8 Flash 的速度 | high 默认档任务完成快 2.5 倍 | Google 自报;文中未按基准定义 |
| 相对 3.8 Flash 的 Terminal-Bench 4.1 | 57% 对 18.2% | 分数超过 Flash 的三倍 |
| 相对 3.8 Flash 的编造性陈述 | 减少超过 5 倍 | Google 自报 |
| Agent Arena(arena.ai 实时基准) | 第 5 名 | 深度研究等开放式多步任务 |
| Vals Tax Agent Bench | 52.3%,总榜第 1 | Google 的描述 |
| Vals Legal Research Bench | 55.8%,并列第 1 | Google 的描述 |
| HLE-Diamond | 58.8%,同档领先 | 也在模型卡表格中 |
| 合作伙伴速度与 token(早期测试) | 比 3.8 Flash 快 2 到 2.8 倍;token 少 12% 到 23% | 文中未点名合作伙伴 |
| Google Sheets 中的 Gemini canvas | 输出比之前的模型快 30% 以上 | Google 自报 |
| Orchestrator 在 Terminal-Bench 上 | 接近 Carbon 的成功率,配额少 24%,快 19% | Google 文章写 4.0;Antigravity 文章写 4.1 |
有一处不一致值得指出。Google 发布文章把 Orchestrator 的结果写在 Terminal-Bench 4.0 上,而 Antigravity 博客把同样的 24% 和 19% 写在 Terminal-Bench 4.1 上。我们照原文引用两者,无法判断哪个是笔误。
独立数据:Artificial Analysis
Artificial Analysis 在发布当天就上线了该模型的页面。页面标题为 Gemini 4 Hydrogen (xhigh),所以下面描述的都是 xhigh 设置,而不是默认的 high 档。指数版本为 v5.0.1,由九项评测构成:AA-Briefcase v1.1、AutomationBench-AA、Terminal-Bench 4.0、FrontierCode-AA 2.0、AA-Omniscience v1.1、GDP.pdf、HLE-Diamond、CritPt v2(Hard Subset)和 Terminal-Bench-Science 0.1。
| 指标(xhigh) | 数值 | 页面上的背景 |
|---|---|---|
| 智能指数 | 54,78 个模型中排第 16 | 可比模型的中位数为 41 |
| 输出速度 | 每秒 198 token | 77 个模型中排第 40 |
| 首个答案 token 时间 | 41.11 秒 | 推理模型,所以包含思考时间 |
| 每个智能指数任务耗时 | 13.0 分钟 | 略慢于可比模型 12.9 分钟的中位数 |
| 每个智能指数任务成本 | $3.16 | 按 $1.50 / $7.50 和 95% 缓存折扣;77 个中排第 41 |
| 指数评测使用的输出 token | 304M | 中位数 72.8M;啰嗦程度 77 个中排第 76 |
| 上下文窗口 | 1M token | 输入文本、图像、语音和视频;输出文本 |
可以得出三点。指数分数支持 Google 的说法,即 Hydrogen 在最高档有竞争力:54 远高于该页的对比中位数。速度表现好坏参半:每秒 198 token 还可以,但每个任务 13 分钟并不比同档平均更快,41 秒才出第一个答案 token 也提醒我们 xhigh 是先想后说。啰嗦程度是应该影响你测试方式的注意点:304M 输出 token 大约是对比中位数的四倍,页面称该模型非常啰嗦。所以每个任务 $3.16 的成本,虽然低于我们的 Carbon 指南在 11 月 11 日记录的 Artificial Analysis 上 Carbon(high)的 $7.76,但它同时反映了啰嗦程度和价格。两次测试的思考档位不同,所以这不是同条件对比。
我们抓取的页面上没有看到默认 high 档的独立分数,所以 Google 的 51 在这里仍属厂商自报。至于与 3.8 Flash 的对比,我们的来源里除了下文 Box 的评测,没有第三方数字。
思考档位与适用场景
思考档位是控制质量、延迟和成本的主要旋钮。Google 说这四档平滑、可预测地递进,所以你只为任务所需的推理深度付出等待和费用,并且在各档上 Hydrogen 往往比同档竞品完成得更快、输出 token 更少。思考 token 按输出计费,所以档位也是价格控制项。
| 档位 | token 用量 | Google 对何时使用的建议 |
|---|---|---|
| low | 最少 token,最低延迟 | 对成本和延迟敏感的工作,如快速聊天和高吞吐处理;在智能体任务上仍有能力 |
| medium | 较低 token 用量,响应更快 | 交互式编码、实时 UI 原型、响应式聊天和对延迟敏感的工具调用 |
| high(默认) | 智能与速度平衡 | 多数任务的推荐默认值,包括复杂编码、智能体执行、工具调用和多模态知识工作 |
| xhigh | 最多 token,最深推理 | high 不够用的困难多步编码和智能体问题,前提是你能接受更高延迟和 token 用量 |
Google 的流程很简单:先用 high,只在 high 失败的问题上用 xhigh,在四个档位上用较大的 max_output_tokens 跑你的评测,避免上限截断答案,然后选达到你质量要求的最低档。Google 还提醒 xhigh 可能对简单提示想得过多。注意早期一些 Gemini 模型接受的 minimal 在 Hydrogen 上会报错。
第三方的建议略有不同,两边都值得读。Cursor 的模型页说,做智能体编码应保持在 high,medium 和 low 上质量明显下降,所以只适合简单、对延迟敏感的任务,xhigh 用于困难调试,代价是更多思考 token 和更慢的响应。而 Google 文档把 medium 列为适合交互式编码。如果把 medium 理解为实时原型和聊天,把 high 理解为多步智能体运行的设置,两者并不矛盾。我们的实用规则是:凡是带工具的任务默认用 high,只有在自己的评测显示没有退化后才降到 medium,鉴于 Artificial Analysis 的啰嗦数据,把 xhigh 当作重试档而不是默认档。
如何使用 Hydrogen
Google AI Studio(免费和付费)
最快的试用方式是已预选该模型的 AI Studio 提示页。Google 说 Hydrogen 在那里的免费层和付费层都有,所以不用开通账单就能试,但受免费层限速和上文提到的免费层数据使用条款约束。
Gemini API:Python 快速入门
Google 的快速入门使用 Interactions API。模型默认以 high 思考和 64K 同步输出上限运行。安装最新的 google-genai SDK,设置 GEMINI_API_KEY,然后运行:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Build an interactive single-file HTML token bucket rate-limiter simulator with live sliders for burst size and request traffic.",
)

print(interaction.output_text)
要改变思考档位,在 generation_config 中设置。输出上限同时计入思考和答案,所以要留足空间:
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Audit this payment retry queue for race conditions and rewrite the lock acquisition logic.",
    generation_config={
        "thinking_level": "xhigh",  # low | medium | high (default) | xhigh
    },
)

print(interaction.output_text)
Gemini API:curl
REST 调用沿用我们 Carbon 指南示例的写法,换成 Hydrogen 的模型 ID。我们读到的 Google 文档摘录只在 Python 中展示了思考档位设置,所以把该字段复制进原始请求前,请先查 REST 参考:
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-hydrogen",
    "input": "Explain the difference between optimistic and pessimistic locking in three short paragraphs."
  }'
用后台执行生成长输出
同步响应每一跳最多 65,536 token。要更长的输出,把 max_output_tokens 设到 65,536 以上(最多 1,048,576 减去你的输入 token),并把 background 设为 true,让 Google 的服务器以 64K 为一跳继续,或者在最新 SDK 里用客户端续写。如果设置了 background 却没有设置 token 上限,服务器会在 65,536 处停止。Google 推荐用后台执行做长解码。
import time
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Generate a complete multi-module migration specification and test suite for this service.",
    background=True,
    generation_config={
        "max_output_tokens": 262144,
        "thinking_level": "high",
    },
)

while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

# Each 64K continuation hop adds a model_output step, so join them all.
text = "".join(
    content.text
    for step in interaction.steps
    if step.type == "model_output"
    for content in step.content
    if content.type == "text"
)
print(text)
print("Status:", interaction.status)
print("Usage:", interaction.usage)
在同一会话中搭配 Carbon 与 Hydrogen
Google 说你可以用 previous_interaction_id,或在无状态模式下保留思考步骤,在同一个多轮会话中把规划轮次路由给 Carbon,把执行轮次路由给 Hydrogen。下面的示例是根据这些文档字段拼出来的,我们没有运行过,使用前请先测试。
from google import genai

client = genai.Client()

# Planning turn on Carbon
plan = client.interactions.create(
    model="gemini-4-carbon",
    input="Read the auth module and write a step-by-step plan to move sessions to signed cookies.",
)

# Execution turn on Hydrogen, continuing the same conversation
build = client.interactions.create(
    model="gemini-4-hydrogen",
    input="Implement step 1 and 2 of the plan and list the tests you would run.",
    previous_interaction_id=plan.id,
)

print(build.output_text)
Google Antigravity 与 Orchestrator
在 Google Antigravity 中,Hydrogen 正向付费的 Google AI Pro 和 Ultra 订阅用户推出,企业则通过 Gemini for business 使用。模型下拉菜单里新增的 Orchestrator 选项把 Hydrogen 与 Carbon 配对在同一会话里。Google 的描述是动态且双向的:Carbon 先进入只读阶段,探索依赖、澄清歧义,并制定带有明确重新规划触发条件的计划;Hydrogen 接手写编辑、更新包并运行测试;如果 Hydrogen 遇到阻碍,就交回给 Carbon 检查状态、修复计划并继续。Antigravity 的文章把它与静态模型路由器作对比:后者根据你的第一条提示猜测难度,在智能体运行更久时就会失效。
Google 自报接近 Carbon 的任务成功率,配额少用 24%,完成快 19%。对于并行工作,Carbon 可以做协调者,Hydrogen 驱动隔离工作区中的 worker 和 verifier 智能体。Orchestrator 先向 Google AI Ultra 订阅用户推出,其他套餐之后再支持。如果你已经在用 Carbon 的 /swarm,我们的 Carbon 指南有介绍;上一代模型的配置方式见 Antigravity 与 Gemini 3.8 Flash 集成指南(英文)。Antigravity SDK 还允许你在代码里按角色把两个模型接起来;Google 的演示是一个 issue 分诊系统,由 Hydrogen 智能体做分诊和编码,Carbon 智能体处理更大的重构和安全检查。
在 API 一侧,Gemini Managed Agents 中的 Antigravity 智能体现在默认使用 gemini-4-hydrogen,你可以通过 agent_config 覆盖底层模型。预览期间环境算力不计费,但模型推理按标准标价收费:
from google import genai

client = genai.Client(http_options={"api_version": "v1beta"})

interaction = client.interactions.create(
    agent="antigravity-preview-09-2026",
    input=(
        "Audit https://web.dev for performance, Core Web Vitals, and SEO. "
        "Format the output as a side-by-side scorecard table with prioritized fixes."
    ),
    environment="remote",
)

print(interaction.output_text)
Gemini 应用、搜索与 Google Sheets
在 Gemini 应用里,Hydrogen 出现在模型下拉菜单中。免费用户在 Google 判断它适合当前提示时,通过自动模型选择用到它,所以按我们读到的内容,免费账号无法固定使用它。在 Google 搜索中,它面向全球所有用户上线。在 Google Sheets 的 Gemini 中,它先从 Google AI Pro 和 Ultra 订阅用户及符合条件的商业套餐开始。Google 面向消费者的卖点是跨轮次更严格地遵循指令、更好的工具调用、清晰的表格和可视化拆解,以及用更少的提示得到可用的版面。
其他工具
Cursor 把 Hydrogen 记录为 Gemini 3.8 Flash 的继任者,支持所有智能体工具。Cursor 把它列为第三方模型,所以不包含在 Cursor 套餐的内含用量中。Google 的发布文章还列出付费层的 Android Studio。Box 说 Hydrogen 即将登陆 Box AI。关于其他提供商渠道,见我们的最佳 AI 推理提供商盘点;Hydrogen 本身是托管的专有模型,所以 Google 的 API 是第一方渠道。
合作伙伴结果与演示
Box 是我们的来源里唯一带数字的第三方评测。在 Box AI Complex Work Eval(一套以加权评分标准打分、每个任务多次运行的真实文档密集型任务基准)上,Box 报告 Hydrogen 得 79%,Gemini 3.8 Flash 为 74%,耗时不到一半,典型任务 token 少约 12%。Box 给出的各行业例子都是相对 3.8 Flash:公共部门 69% 到 95%,医疗 76% 到 81%,科技 68% 到 78%,媒体与娱乐 57% 到 76%,生命科学 56% 到 70%。Box 说收益主要来自读对确切的行、对齐多个来源的记录,以及每次运行都得到相同答案。这是合作伙伴自己的基准,由合作伙伴自己发布,只能当作一个数据点。
Google 的演示展示的是模型的用途,而不是证明。发布文章和 Google 的 YouTube 频道展示了 Geminisland,一个共享的体素岛,一条提示就能实时生成建筑;一次生成的电商店铺,带 WebGL2 地形着色器和滚动叙事;被做成像素动画画布的 Google Sheets;从 YouTube 主题演讲生成多页 Google Slides,再由自动循环审核并修复;带 Web Audio 音乐引擎的闪电 3D 地球;以及一段关于氢元素的档案风格短片。这些是精选示例,没有附带失败率。
视频:Geminisland: Gemini 4 Hydrogen,官方,来自 Google YouTube 频道。
安全方面的说法
发布文章提出了若干智能体安全方面的说法,全部是 Google 自己的内部评测,且都是与 Gemini 3.8 Flash 对比。Hydrogen 在智能体任务中把越权行为最多减少 81%,把服务不足最多减少 79%;在工具使用和编码评测中把错位行为和任务取巧减少为原来的十二分之一;面对不可能完成或被阻止的任务时,绕过权限边界的可能性最多低一半;在 Google 内部的智能体诚实度评测中诚实率为 96.7%。Google 还说,在超过 200,000 个被审计的轮次中,它保持了 99.9% 的思维链可读性,且没有欺骗性的推理编辑;在 Gray Swan 间接提示注入基准上抵抗力超过 2.3 倍;在 HealthBench Pro 上的误拒率保持在 0.4% 以下。
模型卡则更克制。相对 3.8 Flash,它显示文本到文本安全小幅提升(+0.80 个百分点)、多语言安全(+1.10)、图像到文本安全提升更大(+7.00),但拒绝语气得分更低(-0.65),不合理拒绝更多(+5.57 个百分点),尤其是多模态提示。在前沿安全方面,Google 做了定向评估,因为它不能排除 Argon 和 Carbon 达到 CBRN 生物和网络安全的关键能力等级。Hydrogen 没有达到任一等级,但两者都达到了警戒阈值,Google 说会继续部署缓解措施。我们读模型卡时,完整的安全与保障报告标为“未来几天发布”。
从 Gemini 3.8 Flash 迁移
Google 的清单既覆盖从 Gemini 3.8 Flash 升级,也覆盖从 Carbon 和 Argon 迁移或与它们搭配。Antigravity 的 gemini-api-dev 技能可以用 Google 文档里展示的提示来自动完成升级。手动步骤如下:
- 更换模型 ID:把
gemini-3.8-flash改成gemini-4-hydrogen。 - 适应统一窗口。3.8 Flash 把 1M 输入和 64K 输出预算分开。Hydrogen 在输入、思考和输出之间共享 1,048,576 token,同步调用的默认值和上限仍是 65,536。去掉写死的偏低
max_output_tokens(如 8,192),或调到 65,536。 - 有意识地设置
thinking_level。默认值现在是high而不是medium;xhigh是新增的;minimal会报错。在你自己的评测集上测试medium和high,平衡速度和成本。 - 放弃显式缓存。移除
cached_content字段和caches.create。隐式缓存对至少 4,096 token 的提示生效,命中有 95% 折扣。 - 移除采样参数。发送
temperature、top_p和top_k会被忽略。 - 原生声明工具。不要在没有声明任何工具的情况下,用系统提示让模型输出原始 JSON 工具调用,这可能返回
MALFORMED_FUNCTION_CALL。请使用函数调用或结构化输出。 - 保持会话状态。在 Interactions API 中使用
previous_interaction_id。在客户端管理的generateContent历史中,原样返回之前的模型轮次和思考签名,并且不要把一个签名复制到并行的函数调用部分。 - 超过 64K token 的输出用后台执行。
- 重新核对计费估算。思考 token、接地指令和函数声明都会计费。
如果你已经在运行 Carbon 或 Argon,加入 Hydrogen 不需要改请求结构:把 model 设为 gemini-4-hydrogen,想要 medium 或 xhigh 行为时设置 thinking_level,并注意 Hydrogen 每个非流式跳最多 65,536 token,而 Carbon 和 Argon 在非流式 REST 下每跳为 32,768。
局限与注意事项
- 多数是厂商基准。十行表格、2.5 倍速度的说法和安全数字都来自 Google。Artificial Analysis 是我们找到的唯一独立来源,而且只覆盖 xhigh。
- xhigh 非常啰嗦。Artificial Analysis 在其指数上记录了 304M 输出 token,中位数为 72.8M,啰嗦程度在 77 个中排第 76。Google 的模型卡承认,模型在更高思考档可能使用更多 token,且偶尔会慢或超时。我们没有找到 Artificial Analysis 对默认 high 档的 token 数。
- Sonnet 5.5 领先三行。在 Google 自己的表里,Terminal-Bench 4.1、OSWorld-2.1 和 Terminal-Bench-Science 0.1 是 Claude Sonnet 5.5 领先。做编码智能体和 computer use 的用户应该两者都测。
- 对无害提示的拒绝率更高。模型卡的不合理拒绝指标比 3.8 Flash 差 5.57 个百分点,尤其是多模态提示。
- 成本上并非直接替换。到 2026 年 12 月 31 日,3.8 Flash 的单价只有一半。
- 不支持 Live API、图像生成、音频生成或显式缓存。这些工作请选其他模型。
- 幻觉减少但没有消除。模型卡把幻觉列为已知局限,且知识截止为 2026 年 3 月。
- 访问分层。Gemini 应用的免费用户无法固定该模型;Orchestrator 先从 Ultra 开始;Antigravity 需要付费套餐;Box AI 的支持标为即将推出。
- 安全报告待发。我们查看时完整报告还没有发布,而且 Hydrogen 达到了 CBRN 和网络安全的警戒阈值。
- 竞品价格未核实。我们没有从一手来源核实 Claude Sonnet 5.5 或 GPT-6.1 Terra 的标价,所以本文不与它们做价格对比。
适合谁用
| 如果你是 | 用 | 原因 |
|---|---|---|
| 在用 Gemini 3.8 Flash,想要更可靠的智能体 | Hydrogen 的 high 档,再测 medium | Google 自报 Terminal-Bench 4.1 大幅提高、编造性陈述减少;到 2027 年 1 月 1 日前要按双倍单价做预算 |
| 构建带规划者和执行者的编码智能体 | Carbon 规划,Hydrogen 执行(Antigravity 的 Orchestrator 或 SDK 中按角色路由) | Google 自己的多模型模式;自报配额少 24%、快 19% |
| 构建交互式网页或 UI 原型 | Hydrogen 的 medium 或 high 档 | Google 把它定位为实时 UI 原型和设计到代码的迭代 |
| 处理长 PDF、表格、图表、音频或视频 | Hydrogen | 1M token 多模态输入,长解码下最多 1M 输出,且 Google 表中 MKA 和 Chartography 领先 |
| 做困难调试、安全审计或研究 | 先用 Carbon 或 Argon,Hydrogen xhigh 作为更便宜的重试 | Google 把前沿模型留给最难的问题 |
| 运行大批量分类或路由 | Gemini 3.5 Flash-Lite | Google 文档把它留给最低成本和亚秒级延迟 |
| 预算有限的业余或学生项目 | 免费层的 Hydrogen | 免费、限速,数据使用条款请自己读 |
| 需要 Live API、图像或音频输出 | 换另一个 Gemini 模型 | Hydrogen 不支持 |
结论
Hydrogen 是一个清晰合理的产品:由 Carbon 改造而来、定价 $1.50 和 $7.50、为快速执行调优,思考档位的范围从聊天一直覆盖到困难调试。它比 3.8 Flash 有实质提升的证据还不错(Google 的数字、Box 的评测,以及 xhigh 档 54 分的独立指数分数),但几乎全部是厂商或合作伙伴自报,我们看到的唯一独立页面还标注了很高的啰嗦程度。它不是 Google 卖的最强模型,也没有在每一行都赢过 Claude Sonnet 5.5,而且在接下来七周里它的价格是 3.8 Flash 的两倍。
实用的做法很简短。拿一组固定的自己的任务,在 Hydrogen 的 low、medium、high 和 xhigh 档上各跑一遍,记录 token、耗时和评审结果,按 $1.50 和 $7.50 计价,再与你现在的模型比较。如果你用 Antigravity,先试试 Orchestrator,再决定是否每一轮都为 Carbon 付费。想了解周边背景,请读 Carbon 对比 Claude Fable 5.2和 Claude Fable 5.2 指南,了解市场高端的情况。
常见问题
Gemini 4 Hydrogen 是什么?
Gemini 4 Hydrogen 是 Google Gemini 4 家族中主打速度与效率的模型,2026 年 11 月 12 日发布,接替 Gemini 3.8 Flash。Google 的模型卡说它由 Gemini 4 Carbon 改造而来。它面向日常编码、会调用工具的智能体和多模态知识工作,也可以作为 Carbon 与 Argon 旁边的快速执行模型。
Hydrogen 的 Gemini API 模型 ID 是什么?
gemini-4-hydrogen。这个字符串同时出现在 Google 的模型页、What’s new 页和定价页上。模型页只列出一个稳定版本,ID 就是它。
Gemini 4 Hydrogen 多少钱?
付费层每百万输入 token $1.50,每百万输出 token $7.50(含思考 token),在整个 1M 上下文内价格不变。通过隐式缓存命中的输入为每百万 $0.075。Batch 和 Flex 为 $0.75 与 $3.75,Priority 为 $2.70 与 $13.50。没有会到期的优惠价。
Gemini 4 Hydrogen 免费吗?
Gemini API 和 Google AI Studio 有免费、限速的层级,Google 的免费层条款写明内容可能被用于改进其产品。在 Gemini 应用里,免费用户在 Hydrogen 适合当前提示时通过自动模型选择用到它。Google 搜索对所有用户使用它。Google Antigravity 需要付费的 Google AI Pro 或 Ultra。
Hydrogen 比 Carbon 或 Argon 更强吗?
一般不是。Google 把 Carbon 和 Argon 定位为最难的长程任务,把 Hydrogen 定位为快速执行。Google 自报 Hydrogen 在 Artificial Analysis 智能指数上默认 high 档为 51,Argon 为 50,xhigh 档为 54。我们的 Carbon 指南记录 Carbon 在同一指数上为 60,所以 Hydrogen 是更便宜更快,而不是更强。
Gemini 4 Hydrogen 能赢 Claude Sonnet 5.5 吗?
Google 自己挑选的表格里,Hydrogen 在与 Claude Sonnet 5.5 和 GPT-6.1 Terra 的十行对比中领先七行;Sonnet 5.5 在 Terminal-Bench 4.1(63.9% 对 57.0%)、OSWorld-2.1(83.9% 对 77.6%)和 Terminal-Bench-Science 0.1(59.9% 对 51.4%)上领先。这些是厂商自报数字,请用你自己的任务验证。
四档思考分别是什么?
low、medium、high(默认)和 xhigh。在 Gemini API 中通过 generation_config 里的 thinking_level 设置。minimal 会报错。Google 建议从 high 开始,只在困难的多步问题上用 xhigh,因为 xhigh 会增加延迟和 token,也可能对简单提示想得过多。
Hydrogen 与 Gemini 3.8 Flash 有什么不同?
Google 自报任务完成快 2.5 倍,Terminal-Bench 4.1 为 57% 对 18.2%,编造性陈述减少超过 5 倍。价格也不同:3.8 Flash 到 2026 年 12 月 31 日为 $0.75/$3.75,所以在 2027 年 1 月 1 日 Flash 涨到 $1.50/$7.50 之前,Hydrogen 的单价是它的两倍。Hydrogen 还取消了显式缓存,并忽略 temperature、top-p 和 top-k。
Google Antigravity 里的 Orchestrator 是什么?
它是模型下拉菜单里的新选项,在同一会话内于 Gemini 4 Carbon 与 Gemini 4 Hydrogen 之间切换:Carbon 负责规划和理清问题,Hydrogen 负责改代码和跑测试,Hydrogen 卡住时可交还给 Carbon。Google 自报在 Terminal-Bench 上接近 Carbon 的任务成功率,配额少用 24%,完成快 19%。Orchestrator 先向 Google AI Ultra 订阅用户推出。
上下文窗口和输出上限是多少?
输入、思考和输出共享一个 1,048,576 token 的窗口。同步输出默认上限为 65,536 token。更长的输出需要把 max_output_tokens 设到 65,536 以上并使用后台执行,它会以 64K 为一跳继续,最多可到 1,048,576 减去输入 token。
Hydrogen 支持显式上下文缓存吗?
不支持。Google 的说明写明 cachedContents 和 caches.create 不受支持。隐式缓存对至少 4,096 token 的提示默认开启,命中时缓存输入享受 95% 折扣,这就是 $0.075 缓存价的来源。
来源
来源于 2026 年 11 月 12 日核对。
- Introducing Gemini 4 Hydrogen:Google 博客,2026 年 11 月 12 日,Koray Kavukcuoglu(发布、说法、访问、安全)
- Google Search gets a major upgrade with Gemini 4 Hydrogen:Google 博客,2026 年 11 月 12 日,Robby Stein
- Gemini 4 Hydrogen 模型卡:Google DeepMind(输入、截止时间、基准表、安全表、前沿安全)
- Gemini 4 Hydrogen 模型页、What’s new in Gemini 4 Hydrogen 和定价页:Gemini API 文档(模型 ID、思考档位、代码、迁移、价格)
- Gemini 4 Hydrogen and Orchestrator:Google Antigravity 博客,2026 年 11 月 12 日
- Gemini 4 Hydrogen (xhigh):Artificial Analysis(独立的指数、速度、成本、啰嗦程度)
- Gemini 4 Hydrogen in Cursor:Cursor 文档(effort 档位、计费)
- Gemini 4 Hydrogen brings accuracy and speed to data-heavy enterprise work:Box 博客(合作伙伴评测,自家发布)
- X 帖子:Sundar Pichai 和 Logan Kilpatrick,2026 年 11 月 12 日
- YouTube:Single-Shot Website 和 Geminisland,Google 官方频道