Gemini 4 Argon 快速回答(2026 年 10 月 30 日更新)
- 发布时间:2026 年 9 月 30 日面向 Fairwind 可信测试者发布;2026 年 10 月 13 日起全面开放。
- 模型 ID:Gemini API 付费层使用
gemini-4-argon,没有免费 API 额度。 - API 价格:2026 年 11 月 30 日前每百万 token 输入 2 美元、输出 10 美元;12 月 1 日起 4 / 20 美元。缓存输入 0.10 美元(之后 0.20 美元)。
- 上下文:输入、思考与输出共享 1,048,576 token 窗口;开启后台执行后单次响应可达约 100 万 token。
- 在哪里用:Gemini 应用与搜索 AI 模式(Google AI Pro、Ultra)、Google Antigravity(Ultra 与企业版)、Google AI Studio 与 Gemini API。
- 独立评分:Artificial Analysis Intelligence Index v5.0 高推理档 50 分,2026 年 10 月 30 日在 57 个模型中排第 13。
Gemini 4 Argon 是 Google DeepMind 的首个 Gemini 4 模型:面向编码、智能体与知识工作的前沿推理模型,2026 年 9 月 30 日发布,10 月 13 日起向所有人开放。本文首次发布时,Argon 仅限 Fairwind Program 测试者使用,也没有公开模型 ID。现在情况已经改变:Gemini API 已列出模型 ID gemini-4-argon,官方定价页有了对应条目,付费订阅用户也可以在 Gemini 应用、搜索 AI 模式和 Google Antigravity 中使用。
本次 10 月 30 日更新加入了 Google 10 月 13 日全面开放公告、Gemini API 开发者指南与定价页(分别更新于 2026 年 10 月 27 日和 28 日)、Google Cloud Agent Platform 定价,以及 Artificial Analysis 的独立测评。下文保留 9 月 30 日发布时的厂商基准表与 Google 内部案例,并更正了已过时的访问说明。
Google 发布了什么
首发公告来自 Google DeepMind 官方账号,将 Argon 定义为前沿模型,而不是既有档位的升级。公告列出的目标负载 — 编码、企业知识工作与网络安全防御中的复杂工作流 — 描述的是长时间运行的智能体任务,而非对话。与常规 Gemini 发布差异最大的是分发方式:首发当天面向一批可信测试者,入口是 Fairwind Program。
Introducing Gemini 4 Argon – our new frontier model. It’s built for complex workflows across coding, enterprise knowledge work, and cybersecurity defense – rolling out today to a set of trusted testers through our Fairwind Program.
— @GoogleDeepMind September 30, 2026
同一账号的后续帖直接回应了输出上限,而 Sundar Pichai 的长帖则给出了 Google 希望绑定在这款模型上的叙事:Google 内部已在大规模使用,反馈来自从编码到量子计算的各个团队。
With a 1M token output limit, Argon adds a deeper level of reasoning to tackle…
— @GoogleDeepMind September 30, 2026
Google 企业账号复述了同样的三个工作负载方向,并把输出上限列为差异点。把两段文案并列看,重点完全一致:同样的三个领域、同样的 1M 数字、同样的「前沿」定位。
Today we’re introducing Gemini 4 Argon. It delivers frontier performance in complex workflows across real-world software engineering, knowledge work, and cybersecurity defense with an industry-leading 1M token output limit.
— @Google September 30, 2026
Lots of discussion out there about our next model(!), so I wanted to give an early look as soon as possible. Introducing Gemini 4 Argon! It shows frontier performance in complex workflows, cyber defense and software engineering. Teams are using it extensively at Google, from coding to quantum computing, great feedback. Here’s a look at the benchmarks:
— @sundarpichai September 30, 2026
最后那条帖子值得仔细阅读,因为它为后文设定了证据标准。Google 描述的是自家内部使用情况与自家跑的基准。Pichai 说「这里是基准测试的结果」并附上图表,这使这些图表成为本文所引述结论的原始证据 — 但它们始终是厂商自测结果,而非独立评测。
上下文窗口与 1M token 输出上限
输出上限是悄悄塑造智能体架构的约束。当模型一次响应最多只能输出 64K token 时,长周期任务必须被切分为多步,状态要在多次调用之间传递,编排层承担把结果重新拼接起来的负担。把上限提高到 100 万 token 改变了这份负担的位置 — 原先需要循环完成的工作,现在可以由一次生成承载。
以下是 Google 官方渠道给出的对比数据:
| 规格 | Gemini 4 Argon | 上一代 Gemini |
|---|---|---|
| 输出 token 上限 | 最多 1,048,576 token 减去输入(长输出) | 64K token(此前 Gemini 各版本) |
| 上下文窗口 | 1,048,576 token,由输入、思考与输出共享 | 不适用 |
| 默认 max_output_tokens | 65,536(开启后台执行可调高) | 不适用 |
| 思考档位 | low、medium(默认)、high | 不适用 |
| 公开 API 模型 ID | gemini-4-argon | 不适用 |
1M 输出的实际工作方式:模型以每段最多 64K token 的分段生成,每一段从上一段停止处继续。设置 background: true 且 max_output_tokens 大于 65,536 时,由 Google 服务器替你执行这些续写分段,你只需拼接所有 model_output 步骤的文本。如果开启后台执行却没有设置 max_output_tokens,服务器会在 64K 处停止。Google 建议复杂推理与编码任务设为 131,072 或 262,144;原先上限低于 32K 的应用至少调到 32,768,因为 Argon 会把更多预算花在思考上。
规划时还要注意两点成本细节。输出价格包含思考 token,所以高思考档位即使可见答案很短也会抬高费用。另外,Google Cloud Agent Platform 定价页说明:自 2026 年 11 月 13 日起,长度超过 32K token 的生成即使之后因客户端或服务器超时失败,也会按可取回的 token 用量计费。Google 开发者指南建议难题使用后台执行,或把 HTTP 客户端超时设为至少 15 分钟。
Gemini 4 Argon 基准测试(厂商自测)
Google 的公告在编码、通用智能体能力与长视频理解三个方面都给出了基准提升。本节所有数字都是厂商自测:对比模型由 Google 选定,评测由 Google 执行或委托执行,图表由 Google 发布。截至发布当日,在一手来源中未发现任何 Argon 数字的独立复现,这些数字也没有随附评测工具链配置或运行日志。
| 评测项 | Argon 结果 | Google 的表述 | 限定条件 |
|---|---|---|---|
| DeepSWE v1.1(软件工程) | 77.9% | 刷新最高水平 | 厂商自测;工具链与配置未完整公布 |
| Vals Index(经济影响力能力) | 表述为领先 | 该指数上的前沿位置 | 厂商自报;无独立复现的分数 |
| AutomationBench(Zapier) | 51.3% | 排名第一 | 厂商自测 |
| LVBench(长视频理解) | 91.7% | 最高水平 | 厂商自测 |
| CWE-bench v1(安全补丁) | 68% | 并列第一 | 三家 68% 并列;见下方图表 |
| Gray Swan 间接提示注入 | 鲁棒性曲线领先 | 对比集合中最稳健 | 攻击成功率越低越好;厂商自测 |
其中一行需要明确说明。CWE-bench v1 并不是干净的胜出:公开图表显示 Argon、Grok 4.7 与 GPT-6 Astra 在 68% 处三强并列。Google 标注 Argon 并列第一,这本身准确,同时也意味着该安全补丁结果并未把 Argon 与对手区分开。如果决策依赖这项基准,诚实的结论是平局,而不是领先。
同样的判断适用于整组基准。Google 选择的评测组合侧重软件工程、流程自动化、视频理解与安全,这确实是公告中三个工作负载方向的合理代理,但它不是通用能力指数;一个模型可能在这组特定评测上表现突出,同时在推理性或多语言任务上并不出众。
发布后的独立基准
全面开放后,外部机构可以直接测试 Argon。Artificial Analysis 在发布时用旧版 Intelligence Index 给 Gemini 4 Argon(高推理)打出 53 分,与 GPT-6 Astra(max)持平,比 GPT-6.1 Sol(max)高 1 分。在当前的 Intelligence Index v5.0 上为 50 分,2026 年 10 月 30 日在 57 个模型中排第 13。
| 指标(Artificial Analysis) | Gemini 4 Argon(high) | 说明 |
|---|---|---|
| Intelligence Index v5.0 | 50 | 2026 年 10 月 30 日排名 13 / 57 |
| AutomationBench-AA | 78% | 发布时排名第一 |
| Terminal-Bench 4.0 | 57% | 发布时落后于 Claude Sonnet 5.5、Claude Opus 5.5 与 GPT-6 Astra |
| AA-Omniscience 幻觉率 | 15% | 发布时 45 分以上模型中最低 |
| 输出速度 | 约 83 token/秒 | 略高于中位数 |
| 首 token 时间 | 约 48 秒 | 开始作答前思考时间较长 |
| 跑完整套指数的输出 token | 约 1.1 亿 | 高于 7,100 万的中位数,偏啰嗦 |
独立数据更支持 Google 在智能体与低幻觉方面的说法,而不是通用智能上的领先。Argon 处于第一梯队但不在榜首,高推理档下开始作答慢、token 消耗大。交互式使用时,建议先测试 medium 或 low 档位,再决定是否默认使用 high。
网络安全评测
网络安全结果是公告中图表篇幅最大的部分,这与首批开放对象是网络防御者相吻合。其中两张图表对应公开基准,另外两张对应 Google 内部或合作方执行的安全工作。
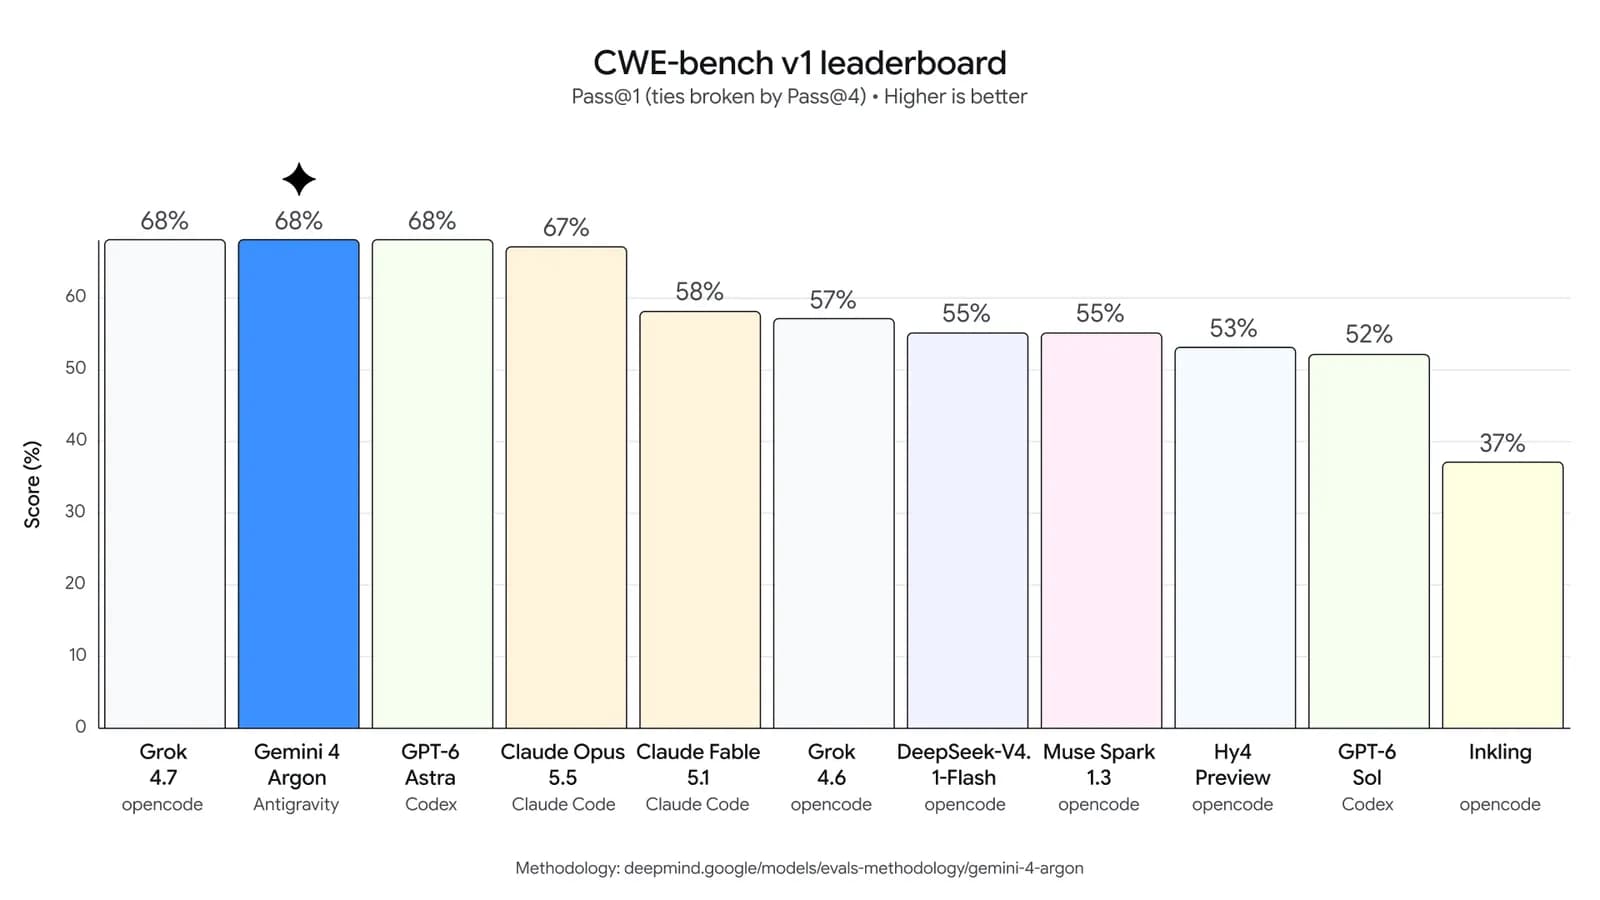
CWE-bench 衡量的是模型能否修补真实存在的漏洞类别。68% 在这样一项困难的基准上是实打实的进展,而图表把并列关系直接呈现出来,没有把它埋掉 — 对需要做判断的读者而言,这正是最有用的部分。
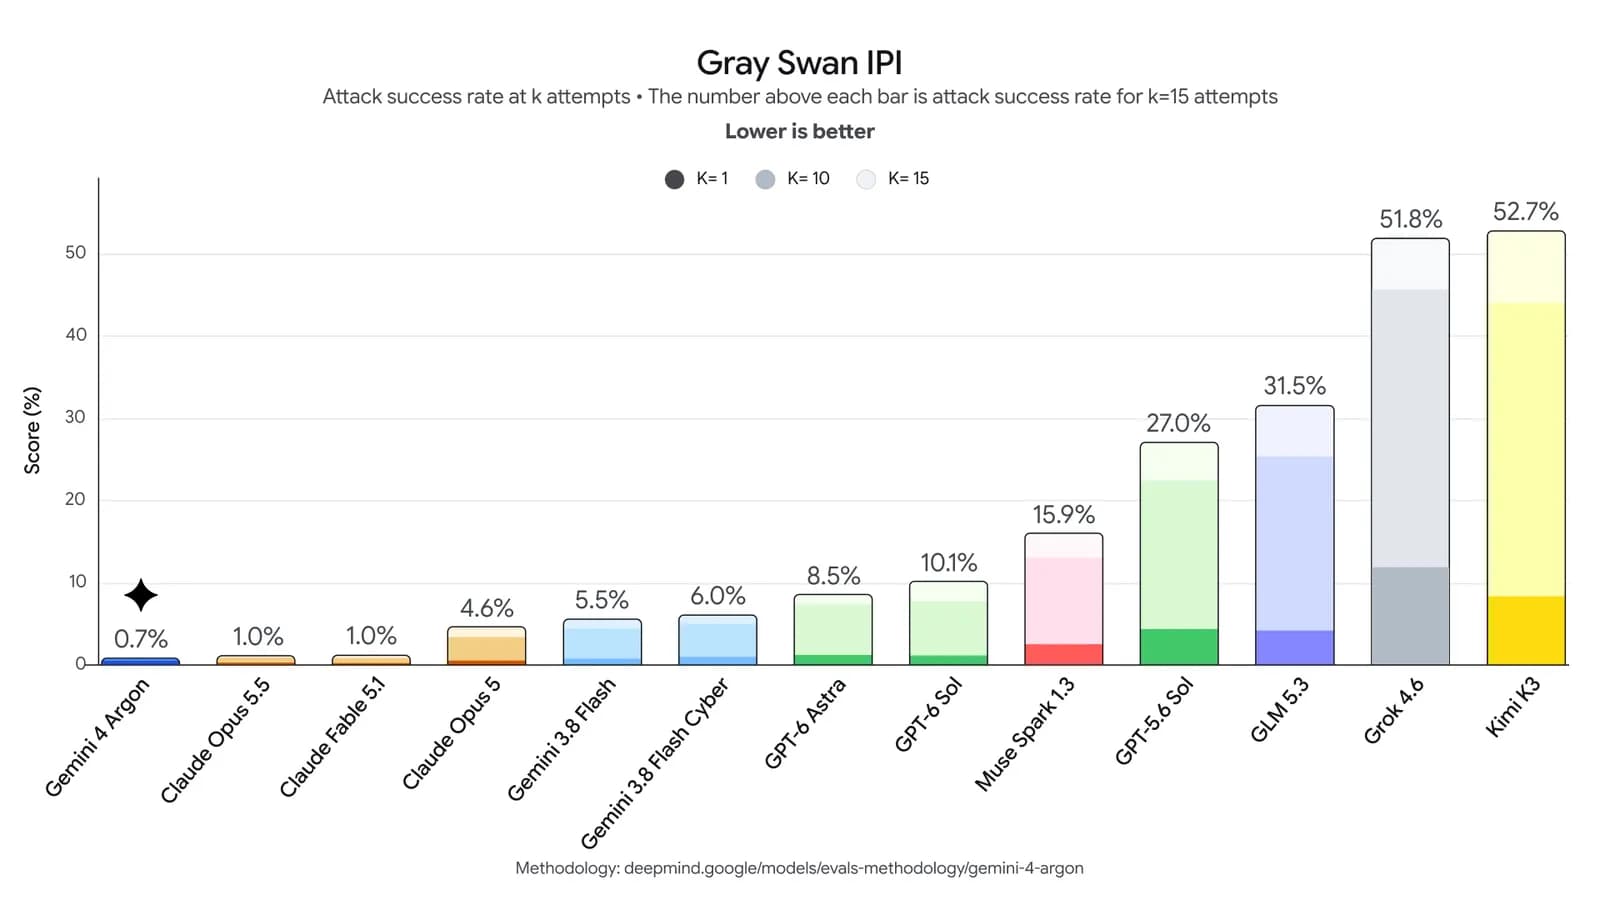
Gray Swan 图表的读数方向与其他几张相反:指标是攻击成功率,因此数值越低越好。Google 报告 Argon 在 k=15 次尝试下的攻击成功率为 0.7%,是对比集合中最稳健的表现。对于任何会读取不可信内容的智能体 — 网页、工单系统、邮件 — 间接提示注入鲁棒性是为数不多可以直接量化的安全属性,因此这张图比编码分数更具决策价值。
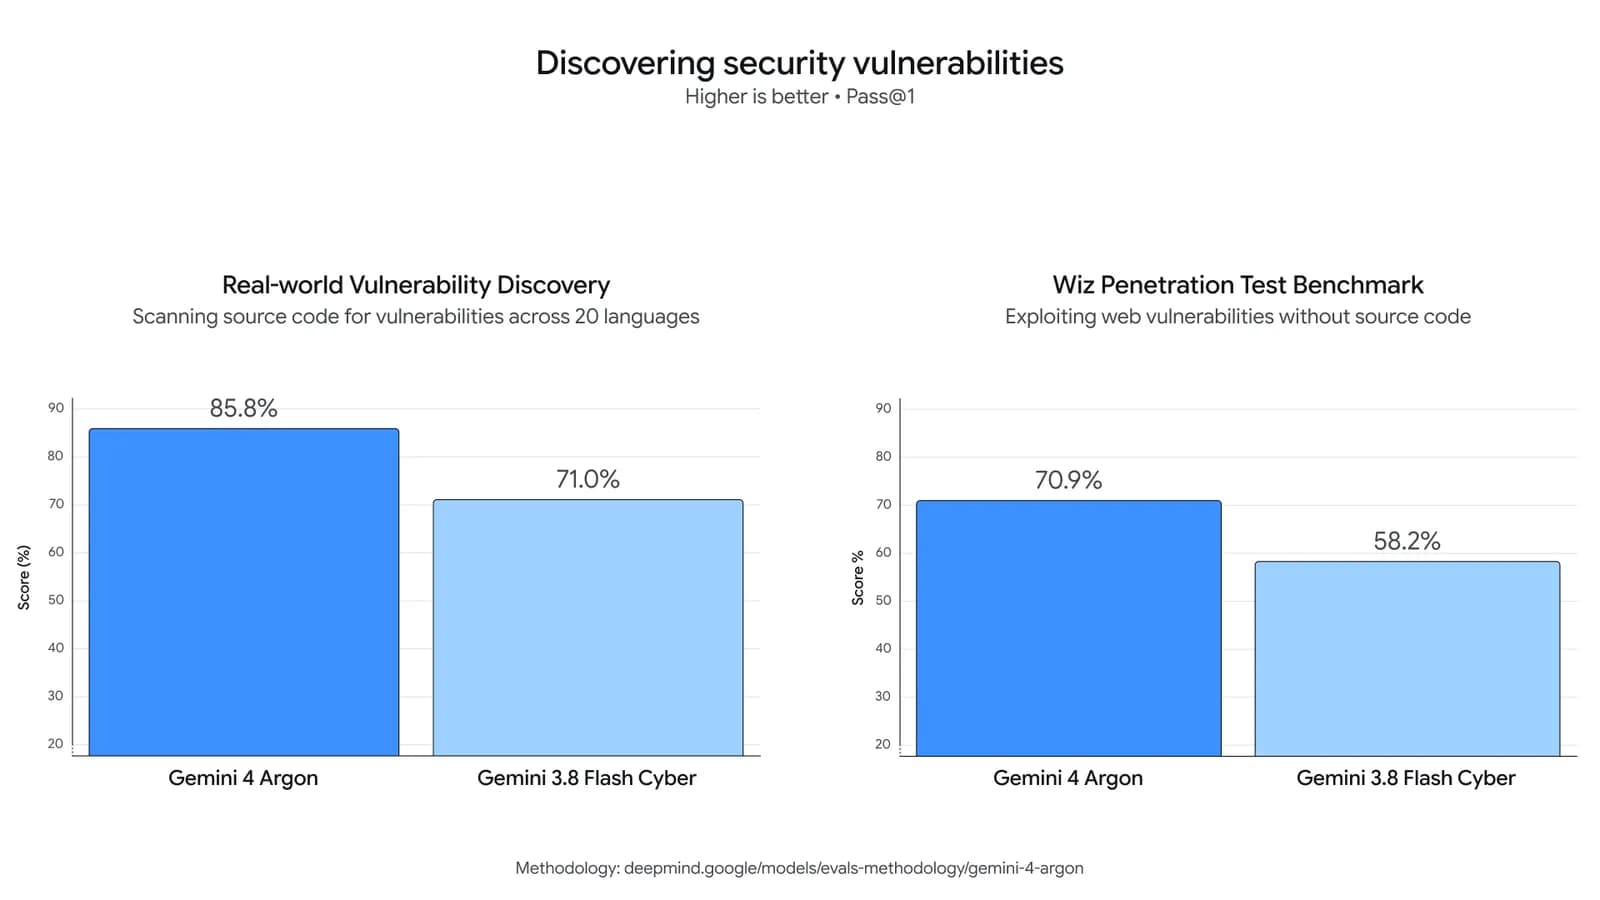
| 安全评测 | Gemini 4 Argon | Gemini 3.8 Flash Cyber | 状态 |
|---|---|---|---|
| 真实漏洞发现 | 85.8% | 71.0% | Google 内部基准 |
| Wiz 渗透测试基准 | 70.9% | 58.2% | 合作方执行,由 Google 报告 |
| CWE-bench v1 | 68%(并列第一) | 图表中列出 | 公开基准,厂商自测运行 |
| Gray Swan IPI 成功率 @ k=15 | 0.7%(最低) | 图表中列出 | 公开基准,厂商自测运行 |
这里的对比对象很能说明问题。Google 用自家面向网络安全调优的 3.8 Flash Cyber 作为 Argon 的对比基准,而不只是与竞品比较。在漏洞发现上比内部专用模型高出约 15 个百分点,是有意义的内部进步;但它同时是内部对比,在内部基础设施上评测,未公布测试集,读者应把绝对百分比视为方向性参考。Wiz 那一行性质不同:Wiz 是外部安全厂商,基准属于它,但结果仍由 Google 报告,且在一手来源中未找到 Wiz 对同一次运行的公开说明。
Google 内部实践
Google 给出了一组内部案例,这是公告中最具辨识度的部分,因为公司对具体工作描述得相当细,而不只是宣称效率提升。这些是内部结果,没有外部测试工具链,因此它们说明的是能力方向而非能力证明 — 但细节足够具体,可以据此推理。
| 内部工作 | 报告结果 | 说明了什么 |
|---|---|---|
| 语言迁移(C/C++ 转 Rust) | 替换 32K 行 SIMD 代码;结果报告为比此前的 Rust 移植快 2.7 倍,并更接近优化后的 C++ | 对性能关键代码的大规模机械式重构;「更接近」属定性表述 |
| Fuchsia Zircon 内核迁移 | 迁移 800K+ 行代码 | 1M 输出预算应用于单一超大代码库任务 |
| 内存效率优化 | 释放 300 TiB,估计可优化空间为 500 TiB 至 1 PiB | 基础设施规模的优化任务 |
| 量子优化 | 比已发表的基线提升 40% | 研究域工作;未公布方法论 |
| 广泛内部使用 | 据 Pichai 所述,团队「大量」使用 Argon,覆盖从编码到量子计算 | 对外开放前的长期内部试用 |
迁移类数字与输出上限的关联最直接。替换 32K 行 SIMD 代码,或迁移 800K+ 行内核代码,正是 64K 输出上限会让过程很别扭、而 1M 上限能让它用更少轮次完成的典型任务。这一关联是合理机制而非证明,因为 Google 未公布这两次迁移背后的提示结构、轮次数量或评审流程。
定性措辞需要谨慎对待。「比 Rust 移植快 2.7 倍」是两个内部产物之间的相对说法,「更接近优化后的 C++」是 Google 自己的描述,而非基准结果。量子优化数字没有公布基线引用或评测协议,因此最好把它理解为 Google 在这类问题上投入方向的信号,而不是可与任何外部结果对比的性能主张。
发布时间与开放节奏
发布之初,访问只能通过 Fairwind Program 而非 Gemini API;2026 年 10 月 13 日起已全面开放(见下表)。Fairwind 于 2026 年 9 月 2 日作为面向防御方的项目推出;DeepMind 项目页面称其与全球合作网络协作,并报告全球 650+ 家合作方。该数字覆盖整个项目,并非专指 Argon 的使用资格。
Fairwind 项目页面还把更早的 DeepMind 安全工作与此次发布连接起来,点名 Gemini 3.8 Flash Cyber 与 CodeMender — DeepMind 于 2025 年 10 月发布的代码安全智能体。Argon 是这条线的第三步:面向网络安全的调优模型、自动修补智能体,以及如今首批开放对象为防御方的前沿模型。
| 阶段 | 开放对象 | 渠道 | 已公布日期 |
|---|---|---|---|
| 一(已完成) | 可信测试者与首批网络防御者 | Fairwind Program | 2026 年 9 月 30 日 |
| 二(已完成) | 付费 API 层的开发者与企业;Google AI Pro 与 Ultra 订阅用户 | Gemini API、AI Studio、Android Studio、Agent Platform、Gemini 应用、搜索 AI 模式、Google Antigravity(Ultra 与企业版) | 2026 年 10 月 13 日 |
| 三(滚动开放) | 数百家新增 Fairwind 合作方(无网络安全护栏版本),以及最多 10,000 名科研人员可获 Antigravity 最高用量档 6 个月免费名额 | 申请制,滚动审核 | 2026 年 10 月 13 日开放申请 |
据 VentureBeat 报道,全面开放距首次发布仅 13 天。发布时 Google 没有给出后续阶段的日期,现在这两个阶段都已发生,而且消费者端除 Ultra 外也向 Google AI Pro 订阅用户开放。
Gemini 4 Argon 价格:API 与订阅方案
Google 已在官方 Gemini API 定价页(最后更新于 2026 年 10 月 28 日)公布 Argon 价格。引入期有明确截止日:2026 年 11 月 30 日。Gemini API 免费层不提供 Gemini 4 Argon。
| Gemini API 计费项(每 100 万 token) | 2026 年 11 月 30 日前 | 2026 年 12 月 1 日起 |
|---|---|---|
| 输入 | 2.00 美元 | 4.00 美元 |
| 输出(含思考 token) | 10.00 美元 | 20.00 美元 |
| 缓存输入(仅隐式缓存) | 0.10 美元 | 0.20 美元 |
| Batch API | 输入 1.00 / 输出 5.00 美元 | 输入 2.00 / 输出 10.00 美元 |
| Google 搜索 Grounding | 每月 5,000 次免费(Gemini 3 及更新模型共享),之后每 1,000 次 14 美元 | 相同 |
| 免费层 | 不提供 | 不提供 |
在 Google Cloud 的 Gemini Enterprise Agent Platform 上,全球端点同样是 2 / 10 美元引入价与 4 / 20 美元标准价,非全球端点约高 10%。那里的引入期折扣以净支出 50% 返还额度的形式发放。面向获批防御方的 Gemini 4 Argon Cyber Permissive 单独计价 4 / 20 美元,不参与促销。
做预算时请按 4 / 20 美元建模,因为这是 12 月 1 日起的价格。Argon 不支持显式上下文缓存;4,096 token 以上的提示会自动隐式缓存,缓存输入便宜 95%,所以反复发送固定前缀的智能体仍会自动省钱。长生成是费用大头:一次完整的 100 万 token 输出在引入期约 10 美元,之后约 20 美元,还不含输入。
消费者订阅与 API 分开计费。在 Gemini 应用与搜索 AI 模式中使用 Argon 需要 Google AI Pro 或 Ultra,个人在 Google Antigravity 中使用需要 Ultra。Antigravity 的方案、额度与 AI credits 如何计算,见我们的 Antigravity 积分与定价指南。
Gemini 4 Argon 怎么用
取决于你需要聊天应用、编码智能体还是 API,有四种入口。
1. Gemini 应用与搜索 AI 模式
- 订阅 Google AI Pro 或 Google AI Ultra。
- 用该账号登录后打开 Gemini 应用,或 Google 搜索中的 AI 模式。
- 如未默认选中,在模型菜单里选择 Argon。Google 表示自 2026 年 10 月 13 日起 Pro 与 Ultra 用户可用;菜单名称可能因地区和设备不同而变化。
2. Google Antigravity
Google AI Ultra 订阅用户与企业客户可以在 Google 的智能体开发平台 Google Antigravity 中选择 Argon 作为模型。Google 称 Argon 在 Antigravity 中让其内部智能体代码提交量增加 35% 以上,回滚减少近三分之一(厂商自报)。通过 API,Gemini Managed Agents 中的 Antigravity 智能体也可以指定 gemini-4-argon。
3. Google AI Studio
打开 Google AI Studio,选择 Gemini 4 Argon,即可在 playground 中直接提问。Google 列出的 AI Studio 使用条件是:开通付费层的 API 项目,或 Google AI Ultra 订阅。
4. Gemini API
- 在已开通结算的项目上,于 AI Studio 创建 API key。Argon 没有免费层。
- 安装 Google Gen AI SDK:
pip install google-genai或npm install @google/genai。 - 调用
gemini-4-argon:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY (paid tier)

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Review this repository layout and propose a migration plan.",
)

print(interaction.output_text)
输出超过 64K token 时,使用后台执行并拼接每个输出步骤:
import time
from google import genai

client = genai.Client()

interaction = client.interactions.create(
    model="gemini-4-argon",
    input="Write the full test suite for the attached module.",
    background=True,
    generation_config={
        "max_output_tokens": 262144,   # above 65,536 enables long decode
        "thinking_level": "high",      # low | medium (default) | high
    },
)

while interaction.status in ("in_progress", "queued"):
    time.sleep(5)
    interaction = client.interactions.get(id=interaction.id)

# each continuation hop adds a model_output step: join them all
text = "".join(
    c.text
    for step in interaction.steps if step.type == "model_output"
    for c in step.content if c.type == "text"
)
Google 开发者指南中的迁移要点:删除 temperature、top_p 与 top_k(Argon 会忽略它们);去掉显式 cachedContents 调用;多轮对话用 previous_interaction_id 保存状态;三个思考档位都测一遍,选满足质量要求的最低档。高并发、低成本场景仍可选择 Gemini 3.8 Flash。
安全与保障
开放节奏的设定明显谨慎。访问从一小批防御者开始,这本身就是限制风险的决定:安全工作有清晰的正当用途、可衡量的结果,以及能够上报滥用的合作方。Google 的前沿安全框架页面描述了公司针对前沿模型的分阶段评估方式,公告也把该框架作为治理背景。
Google 之后已发布 Gemini 4 Argon 模型卡,链接见 10 月 13 日公告,补上了本节在发布时指出的缺口。Google 报告:外部生物安全红队只能解锁不到 1% 的生物子任务;编码任务中的走捷径尝试降至 2%;Gray Swan 间接提示注入在 15 次自适应尝试下的攻击成功率为 0.7%。三项数据均为厂商自报。需要更少拒答的网络防御者可以通过 Fairwind 申请无网络安全护栏的版本。
对智能体工作流的影响
先放下访问权限问题:Google 强调的能力指向四类如果说法成立就会变得更容易的工作流模式。
单次长生成。1M 的输出预算让「一次调用产出完整产物」变得合理 — 完整的迁移补丁集、跨文件的大型重构、生成的测试套件 — 而不必驱动由大量小改动组成的循环。代价是成本集中与评审难度:一个巨大的响应比十个小响应更难增量评审,因此工作流需要加一道验证步骤,而不是继续加提示。
具备可量化鲁棒性的安全审查。对智能体开发者而言,间接提示注入结果是本次发布中最可行动的数字。如果智能体会摄取网页、工单或邮件内容,注入鲁棒性就是活跃的威胁模型,0.7% 的攻击成功率是一个可以据以推理的数字 — 同时要记住它是在固定尝试次数下的厂商自测结果。
迁移与大型代码库工作。C/C++ 转 Rust 与 Fuchsia 的数字描述的是长周期代码变换,这正是输出上限历来迫使人们投入最多编排开销的工作负载类别。今天做这类工作的团队通常把它切分到多次调用;Argon 的定位则暗示可以合并轮次。
漏洞分类与修补。把更高的漏洞发现率与一项补丁类基准(CWE-bench)放在一起,描述的是从分类到修复的闭环。限定条件不变:两个数字都是厂商自测,且补丁结果是三强并列。
Argon 公开后,务实的采纳顺序是:在 low、medium、high 三档下跑自己的评测;把 max_output_tokens 调到至少 32,768;按 12 月的 4 / 20 美元做预算;长任务改用后台执行;并实测首 token 时间,Artificial Analysis 测得高推理档约 48 秒。
注意事项
发布时的基准均为厂商自报。基准由 Google 执行或委托执行,对比模型由 Google 选定,图表由 Google 发布。独立测评在全面开放后才出现(见 Artificial Analysis 一节);漏洞发现与量子优化等结果描述的是内部工作,未公布方法论。
安全基准的领先并不总是领先。CWE-bench v1 是三家在 68% 处并列。Google 使用「并列第一」的表述是准确的;把那一行当作胜出则不准确。
发布时缺失的 API 信息现已公布。模型 ID、定价条目、开发者指南与模型卡都随 2026 年 10 月 13 日全面开放一起发布。厂商基准一节描述的是 9 月 30 日的发布材料。
上文嵌入的四条发布帖中有两条为节录。DeepMind 关于输出上限的帖子以及 Google 的衍生帖在所示开头分句之后仍有内容,完整文本可在链接的帖子中查看。本文没有对无法直接读取的文本做转述。
引入期价格于 2026 年 11 月 30 日结束。11 月做的成本估算,请按每百万 token 4 / 20 美元重新计算。
内部结果属于例证。内存、迁移与量子相关数字说明 Google 在哪些地方使用该模型。它们无法与外部基准直接比较,而在「比 Rust 移植快 2.7 倍」这一例中,基线本身也是内部产物。
选型建议
适合使用 Argon,如果你需要 Google 最强的模型来做长周期编码、智能体任务、大量文档分析,或需要单次超过 64K token 的输出,并且能接受较慢的首 token。11 月是评估它最便宜的时间。
建议选别的模型,如果你需要低延迟或最低的单次调用成本。Gemini 3.8 Flash 能以更低成本覆盖大多数高并发负载;在 VentureBeat 的对比中,GPT-6.1 Sol 的标准价即为 2 / 10 美元。
可以申请特殊通道,如果你是网络防御者(Fairwind,无网络安全护栏版本)或科研人员(最多 10,000 个 Antigravity 最高用量档 6 个月免费名额,需经筛选)。
早期指南(2026 年 9 月 30 日)
以下各节来自本文发布当天的版本。它们完整保留,并在 Google 2026 年 10 月 13 日全面开放改变了事实的地方加上了带日期的更新说明。
1M token 输出上限
输出上限会悄悄塑造智能体架构。当模型一次响应最多只能输出 64K token 时,长周期任务必须被切分为多步,状态要在多次调用之间传递,编排层承担把结果重新拼接起来的负担。把上限提高到 100 万 token 改变了这份负担的位置:原先需要循环完成的工作,现在可以由一次生成承载。Google 称之为「业界领先的 1M token 输出上限」,并称它「加入更深层次的推理以应对」复杂任务。
发布时有三点限定。一手来源均未定义 1M 上限的确切语义,例如是否适用于流式输出、多轮续写,或按单次尝试计量。Google 没有公布速率限制、延迟或首 token 时间。公开 API 文档中也没有模型 ID,外部开发者无法验证这一数字。
gemini-4-argon 现已公开。Google 的开发者指南记录了输入、思考与输出共享的 1,048,576 token 窗口、默认 65,536 token 的输出上限,以及通过后台执行并把 max_output_tokens 设为大于 65,536 来启用长解码。详见上文「上下文窗口与 1M token 输出上限」。9 月 30 日表中「独立验证」一行已不再适用,外部评测结果见独立基准一节。基准测试速览
Google 的公告在编码、通用智能体能力与长视频理解三个方面都给出了基准提升。发布时所有数字都是厂商自测:对比模型由 Google 选定,图表由 Google 发布。具体为:DeepSWE v1.1 为 77.9%(刷新最高水平)、AutomationBench 为 51.3%(排名第一)、LVBench 为 91.7%(最高水平)、Vals Index 领先、CWE-bench v1 为 68%(并列第一),以及 Gray Swan 间接提示注入鲁棒性领先。
CWE-bench v1 并不是干净的胜出:Argon、Grok 4.7 与 GPT-6 Astra 在 68% 处三强并列。这组评测侧重软件工程、流程自动化、视频理解与安全,是公告中工作负载方向的合理代理,但不是通用能力指数。
Fairwind Program 与开放节奏
发布时,访问只通过 Fairwind Program 而非 Gemini API 进行。Fairwind 于 2026 年 9 月 2 日作为面向防御方的项目推出,DeepMind 页面报告全球 650+ 家合作方,该数字覆盖整个项目。Google 公布了三个阶段:9 月 30 日面向可信测试者与首批网络防御者;随后是付费 API 客户与 Google AI Ultra 订阅用户;最后是开发者、企业与普通消费者。第二、第三阶段都没有附加日期,因此没有已公布的时间表可供规划。
定价
Google 随公告公布了引入期定价:每 100 万输入 token 2.00 美元、每 100 万输出 token 10.00 美元,缓存输入部分享受 95% 折扣,引入期后上调为 4.00 美元和 20.00 美元。网络安全能力不单独溢价。促销结束后价格恰好翻倍,因此成本模型应基于 4 / 20 美元构建。发布时这些价格只存在于公告文本与图表中,公开的 Gemini API 定价页上没有对应条目。
当前 API 状态
2026 年 9 月 30 日,公告与开发者文档并不一致。Gemini API 模型列表(最后更新于 9 月 4 日)没有 Argon 模型 ID,定价页(9 月 8 日)没有 Argon 条目,DeepMind 模型卡索引没有 Argon 模型卡,也没有找到针对 Argon 的安全评测或官方演示视频。公告中唯一的访问渠道是 Fairwind 可信测试者。
gemini-4-argon 出现在 Gemini API 付费层,有定价条目和开发者指南,Google 2026 年 10 月 13 日的公告也链接了模型卡。速率限制和区域可用性请以实时文档为准,不要自行假设。设置方法见上文「Gemini 4 Argon 怎么用」。常见问题
Gemini 4 Argon 是什么?
Gemini 4 Argon(模型 ID:gemini-4-argon)是 Google DeepMind 的首个 Gemini 4 模型,面向复杂编码、智能体、数学、科学与知识工作的前沿推理模型。输入、思考与输出共享 1,048,576 token 的窗口,单次响应最多可生成约 100 万 token。
Gemini 4 什么时候发布?
Google 于 2026 年 9 月 30 日发布 Gemini 4 Argon,先向 Fairwind Program 可信测试者开放;2026 年 10 月 13 日起向开发者、企业以及 Google AI Pro 和 Ultra 订阅用户全面开放。
Gemini 4 Argon 怎么用?
四种方式:订阅 Google AI Pro 或 Ultra 后在 Gemini 应用与搜索 AI 模式中使用;Google AI Ultra 或企业方案在 Google Antigravity 中使用;在 Google AI Studio 中使用;通过 Gemini API 付费层调用模型 ID gemini-4-argon。
Gemini 4 Argon 免费吗?
不免费。Gemini API 免费层不提供 Gemini 4 Argon,Gemini 应用中使用需要 Google AI Pro 或 Ultra。科研人员可申请 Antigravity 最高用量档位的 6 个月免费名额,需经过筛选。
Gemini 4 Argon 的 API 价格是多少?
2026 年 11 月 30 日前:每百万输入 token 2 美元、每百万输出 token 10 美元(含思考 token);2026 年 12 月 1 日起为 4 美元和 20 美元。缓存输入每百万 token 0.10 美元(12 月 1 日起 0.20 美元)。Batch 为半价。
哪个 Google AI 订阅方案包含 Gemini 4 Argon?
Google AI Pro 和 Google AI Ultra 都可以在 Gemini 应用和搜索 AI 模式中使用 Argon。个人用户在 Google Antigravity 中使用 Argon 需要 Google AI Ultra。
Gemini 4 Argon 的上下文窗口有多大?
输入、思考与输出共享 1,048,576 token 的窗口。默认输出上限为 65,536 token;要超过 64K,需要开启后台执行并把 max_output_tokens 设为大于 65,536,最大为 100 万减去输入 token 数。
Gemini 4 Argon 实测表现怎么样?
Google 自报 DeepSWE v1.1 为 77.9%,Vals Index 排名第一。独立测评方面,Artificial Analysis 给出 Intelligence Index v5.0 50 分(2026 年 10 月 30 日在 57 个模型中排第 13),AA-Omniscience 幻觉率 15%,为发布时头部模型中最低。
可以在 Google Antigravity 里用 Gemini 4 Argon 吗?
可以,限 Google AI Ultra 订阅用户和企业客户。通过 API,Gemini Managed Agents 中的 Antigravity 智能体也支持 Argon。
CWE-bench 的结果算是胜出吗?
不算。是 Argon、Grok 4.7 与 GPT-6 Astra 在 68% 处的三强并列。Google 标注 Argon 并列第一,这准确,但这项基准并未把 Argon 与对手区分开。
Fairwind Program 是什么?
Google 于 2026 年 9 月 2 日推出的面向防御方的项目,也是 Argon 最早的访问路径。获批的网络防御者现在可以申请使用不带网络安全护栏的 Argon(Google Cloud 上列为 Gemini 4 Argon Cyber Permissive)。
有 Gemini 4 Argon 的模型卡吗?
有。Google 在 2026 年 10 月 13 日的全面开放公告中链接了 Gemini 4 Argon 模型卡。9 月 30 日首次发布时尚无模型卡。
现在应该把生产负载迁移到 Gemini 4 Argon 吗?
先测试再决定。它已有稳定的模型 ID 和公开价格,但首 token 延迟较长,高思考档位下 token 用量也更大。请在 low、medium、high 三档下跑自己的评测,并按 12 月的价格做预算。
Argon 与 Gemini 3.8 是什么关系?
Argon 是首个 Gemini 4 模型,定位高于 Gemini 3.8 Flash。Gemini 3.8 Flash 仍是更便宜、更快的高并发选择;Argon 适合最难的推理、编码与智能体任务。
我现在可以通过 Gemini API 使用 Gemini 4 Argon 吗?
可以。2026 年 9 月 30 日发布时答案是否定的:模型页没有 Argon 条目,访问只通过 Fairwind Program 进行。自 2026 年 10 月 13 日全面开放起,Argon 已作为 gemini-4-argon 出现在 Gemini API 付费层,定价页也有对应条目。API 不提供免费层。
1M token 输出上限是什么,为什么重要?
它是 Argon 单次响应可生成的最大 token 数,相比此前 Gemini 版本的 64K 上限大幅提高。更大的输出预算意味着长周期工作可以用更少的轮次完成。更新(2026 年 10 月 30 日):输入、思考与输出共享 1,048,576 token 的窗口,默认输出上限为 65,536 token,要超过 64K 需要开启后台执行并把 max_output_tokens 设得更高。
Gemini 4 Argon 的价格是多少?
2026 年 11 月 30 日前:每百万输入 token 2.00 美元、每百万输出 token 10.00 美元;2026 年 12 月 1 日起为 4.00 美元和 20.00 美元。缓存输入每百万 token 0.10 美元(12 月 1 日起 0.20 美元)。更新(2026 年 10 月 30 日):这些价格现在已出现在官方 Gemini API 定价页上,9 月 30 日时只存在于公告中。
Google 公布了哪些基准结果?
DeepSWE v1.1 为 77.9%(称刷新最高水平)、AutomationBench 为 51.3%(称排名第一)、LVBench 为 91.7%、Vals Index 上处于领先位置、CWE-bench v1 为 68% 并列第一,以及 Gray Swan 间接提示注入上领先的鲁棒性表现。以上均为厂商自报。更新(2026 年 10 月 30 日):Artificial Analysis 随后给出独立评分,Intelligence Index v5.0 为 50 分,在 57 个模型中排第 13。
Argon 什么时候通用可用?
已经可用。Google 在 2026 年 9 月 30 日公布了开放顺序(可信测试者,然后是付费 API 客户与 Google AI 订阅用户,再到所有人),但没有给出后续阶段的日期。2026 年 10 月 13 日全面开放。
Google 内部用 Argon 做了什么?
报告的内部工作包括:C/C++ 转 Rust 的迁移替换了 32K 行 SIMD 代码;Fuchsia Zircon 内核迁移超过 800K 行;内存优化释放 300 TiB,估计可优化空间为 500 TiB 至 1 PiB;量子优化结果报告为比已发表基线提升 40%。这些都是未公布方法论的内部结果。
有 Gemini 4 Argon 的模型卡或系统卡吗?
现在有了。截至 2026 年 9 月 30 日还没有,也没有针对 Argon 的评测。更新(2026 年 10 月 30 日):Google 在 2026 年 10 月 13 日的全面开放公告中链接了 Gemini 4 Argon 模型卡。
现在应该把生产负载迁移到 Argon 吗?
先测试再决定。9 月时答案是否定的,因为没有公开模型 ID、速率限制和模型卡。更新(2026 年 10 月 30 日):Argon 现在有稳定的模型 ID 和公开价格,但首 token 延迟较长,高思考档位下 token 用量也更大,请在 low、medium、high 三档下跑自己的评测,并按 12 月的价格做预算。
来源
来源核对日期:2026 年 10 月 30 日(发布时来源首次核对于 2026 年 9 月 30 日)。
- Gemini 4 Argon 全面开放公告,Google 官方博客,2026 年 10 月 13 日
- What’s new in Gemini 4 Argon,Gemini API 文档
- Gemini 4 Argon 开发者指南,Google AI Studio
- Gemini API 定价
- Gemini Enterprise Agent Platform 定价,Google Cloud
- Gemini 4 Argon 模型页,Artificial Analysis
- Gemini 4 Argon 发布分析,Artificial Analysis
- Google makes Gemini 4 Argon broadly available,VentureBeat
- Introducing Gemini 4 Argon,Google 官方博客,2026 年 9 月 30 日
- Fairwind Program,Google DeepMind
- Google 的 Fairwind Program,Google 官方博客,2026 年 9 月 2 日
- Gemini API 模型文档
- 前沿安全框架,Google DeepMind
- CodeMender 发布,Google DeepMind
- @GoogleDeepMind 发布帖、输出上限后续帖、@Google 发布帖,以及 @sundarpichai 说明帖
延伸阅读:Gemini 3.8 Flash 完整指南、Gemini 3.8 Live 与 Extended Thinking 指南、Codex Security Cloud 与 Daybreak Blue 指南,以及GPT-6.1 Sol 基准与定价指南。