Get the latest on AI, LLMs & developer tools
New MCP servers, model updates, and guides like this one — delivered weekly.
对大多数团队来说,先从 Langfuse 开始。它有 MIT 许可的核心、免费自托管、OTLP 接入、数据集、LLM-as-judge 和 CI Action,托管版 Core 计划每月 $29。如果你基于 LangChain 或 LangGraph 开发,选 LangSmith;评测驱动发布流程,选 Braintrust;想要没有功能限制的开源方案,选 Phoenix;如果 Datadog 或 Splunk 已经在跑你的监控,就用它们。Promptfoo 适合在 CI 中做提示词回归测试和红队测试。
市场在 2026 年也发生了变化:Langfuse 加入了 ClickHouse,Helicone 易主并进入维护模式,Cisco 完成了对 Galileo 的收购, OpenAI 同意收购 Promptfoo。这让基于 OpenTelemetry 的可移植插桩比一年前更有价值。
视频:Langfuse 官方演示,涵盖 Agent 追踪、评测、实验和提示词管理,能直观展示这一类工具的整体能力(由 Langfuse YouTube 频道发布)。
快速推荐
| 使用场景 | 推荐 | 原因 |
|---|---|---|
| 综合最佳(大多数团队) | Langfuse | MIT 许可的核心、可自托管或用云端、支持 OTLP 接入、数据集、LLM-as-judge 和 CI Action。有免费档,Core 计划 $29。 |
| 基于 LangChain 或 LangGraph 开发 | LangSmith | 与框架集成最紧密,有离线与在线评测,Studio 可调试 Agent。Plus 每席位 $39。 |
| 评测优先的团队 | Braintrust | 评分器、数据集和在线打分是产品核心。Pro $249,托管服务,企业版可本地部署。 |
| 无功能限制的最佳开源方案 | Arize Phoenix | 可免费自托管且无功能限制(Elastic License 2.0),基于 OpenTelemetry 和 OpenInference。 |
| 最佳低预算云服务 | Opik | 仓库为 Apache-2.0,免费云档含 25k span,Pro 每月 $19。 |
| 已经在用 Datadog | Datadog LLM Observability | 只对 LLM span 计费,追踪数据与 APM、RUM 放在一起。 |
| 最适合调试 Agent | Laminar | Agent 追踪、可从缓存重放的 Debugger,以及针对轨迹的评测。Apache-2.0。 |
| 最适合 CI 提示词测试与红队测试 | Promptfoo | 本地运行的 MIT CLI,YAML 配置,支持 GitHub Actions。不是追踪后端。 |
总对比表
每个单元格都来自厂商自己的定价页或文档页,抓取于 2026 年 11 月 11 日。各厂商的计量单位不同(trace、units、span、GB、分数、请求), 所以请用你自己的流量去对照每一行,而不是只看标题价格。许可证信息读取自各 GitHub 仓库或厂商页面。
| 工具 | 价格(截至 2026 年 11 月 11 日) | 保留期 | 自托管 | 开源 | 亮点 |
|---|---|---|---|---|---|
| LangSmith | Developer $0(1 席位,每月 5k 基础 trace);Plus 每席位每月 $39(10k 基础 trace);Enterprise 定制 | 基础 trace 14 天,扩展 trace 180 天 | 仅 Enterprise(hybrid 或自托管) | 否(SDK 为 MIT) | LangChain/LangGraph 深度集成,Studio |
| Langfuse | Hobby $0(50k units,2 用户);Core $29;Pro $199;Enterprise $2,499;超额 $8/100k units | 30 天 / 90 天 / 3 年 | 是,免费 | 是(MIT 核心) | 开源且评测闭环完整 |
| Braintrust | Starter $0(1 GB,10k 分数);Pro $249(5 GB,50k 分数);Enterprise 定制 | 14 天 / 30 天 | Enterprise(本地部署或托管) | 否 | 评测优先的工作流 |
| Arize Phoenix / AX | Phoenix 免费;AX Free $0(25k span);AX Pro $50(50k span);Enterprise 定制 | AX 15 天 / 30 天 | Phoenix 免费;AX 自托管需 Enterprise | Phoenix 是(ELv2) | OpenInference,无功能限制的开源版 |
| W&B Weave | Free $0(1 GB 摄取);Pro 起价 $60(1.5 GB,超额 $0.10/MB);Enterprise 超额 $0.20/MB | 页面未说明 | Enterprise 专属部署或自管 | SDK 为 Apache-2.0 | 与 W&B 模型追踪打通 |
| Helicone | Hobby $0(10k 请求);Pro $79;Team $799;Enterprise 定制 | 7 天 / 1 个月 / 3 个月 | Enterprise 本地部署 | 仓库 Apache-2.0 | 代理式日志(维护模式) |
| Datadog LLM Observability | Free $0(40k LLM span);Pro $160(100k LLM span);超出按需计费 | 15 天(可加购 30/60/90 天) | 否(SaaS) | 否 | 只按 LLM span 计费,并入 APM |
| Galileo(现为 Splunk Agent Observability) | 起价每月 $100 / 120 万 span,按年计费 | 可购买延长保留期 | Observability Cloud 或自托管 | 否 | Luna 评估模型与护栏 |
| Opik(Comet) | OSS $0;Free Cloud $0(25k span);Pro $19(100k span,额外 $5/100k);Enterprise 定制 | 60 天 | 是,免费 | 是(Apache-2.0) | 最便宜的付费云档 |
| Laminar | Free $0(1 GB);Starter $30(3 GB);Pro $150(10 GB);Enterprise 定制 | 7 天 / 30 天 / 6 个月 | 是(开源),Enterprise 可本地部署 | 是(Apache-2.0) | Agent Debugger 与重放 |
| Promptfoo | Community $0;Enterprise 与 On-Premise 定制 | 本地结果 | 本地运行或自托管 | 是(MIT) | CI 评测与红队测试 |
2026 年发生了什么变化
11 款工具中有 4 款今年换了东家或状态有变,了解这些之后,整个对比会读出不同的意味。
- Langfuse 在 2026 年 1 月 16 日宣布加入 ClickHouse。公告称没有计划更改许可证,自托管仍是一等路径,Langfuse Cloud 保持现状运行。公告没有涉及定价。
- Helicone 被 Mintlify 收购,后者表示 Helicone 将以维护模式继续运行(提供安全更新、缺陷修复和新模型),并协助客户迁移。Helicone 自己的定价页现在有一条横幅,称其属于 Experiential Labs,没有更多细节。
- Galileo 在 Cisco 完成收购后更名为 Splunk Agent Observability。它原来的定价网址已重定向到 Splunk 的定价页。
- Promptfoo 在 2026 年 3 月 9 日表示已同意被 OpenAI 收购(需满足常规交割条件),并表示将继续开源。在我抓取的来源中无法确认交割日期。
- Weights & Biases 的 Weave 定价现在位于 CoreWeave Forge 页面,旧的 wandb.ai 定价网址会重定向到那里。
实际含义(这是我们的推断,不是厂商表述)是:当 OpenTelemetry exporter 能解决问题时,不要把应用代码与某一家厂商的 SDK 绑定。如果你还通过代理路由模型流量,请参阅我们的 最佳 LLM API 网关汇总, 因为有些网关会记录请求,与这一类工具的部分功能重叠。
LangSmith
LangSmith 是 LangChain 的追踪、评测和 Agent 部署平台。当你的 Agent 使用 LangChain 或 LangGraph 构建时,它是自然的选择, 因为开启追踪只是一个开关,而不是一个项目。
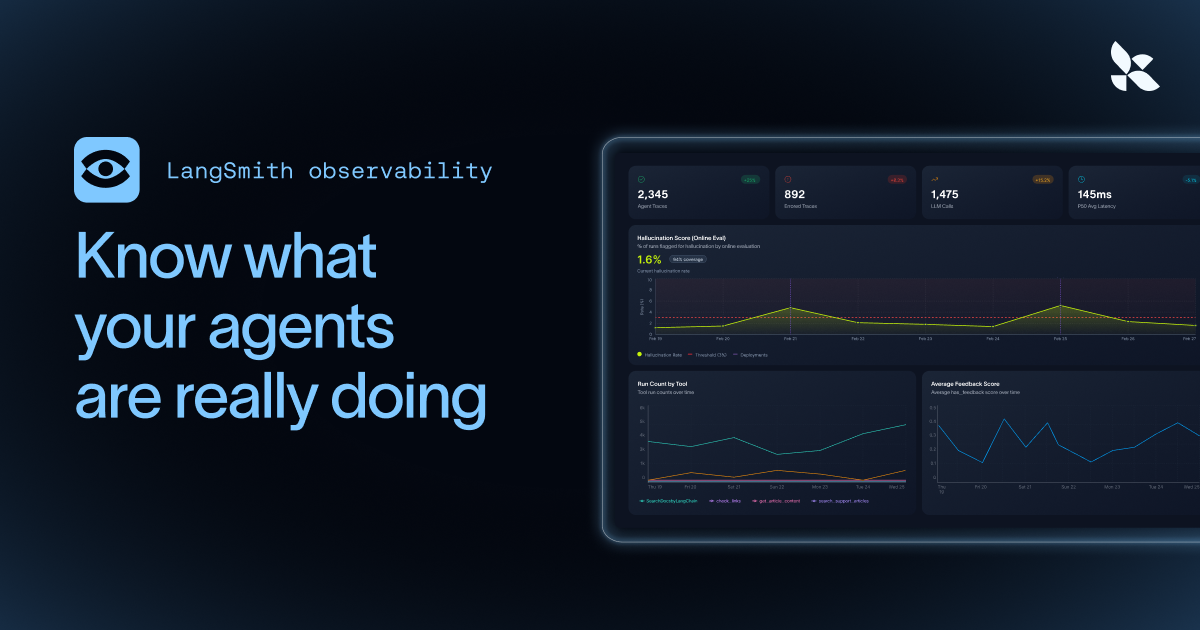
价格(截至 2026 年 11 月 11 日):Developer 为每席位 $0,含 1 个席位和每月 5k 基础 trace。Plus 为每席位每月 $39,席位不限, 含 10k 基础 trace。Enterprise 为定制价。超出包含额度的 trace 按用量付费,但定价页没有公布每 1k trace 的单价,因此请用厂商的计算器或报价来做预算。 基础 trace 保留 14 天数据,扩展 trace 保留 180 天。自托管和 hybrid(SaaS 控制平面加自托管数据平面)部署仅列在 Enterprise 下,托管云运行在美国或欧盟。
优势。评测覆盖面广:由人工整理用例、生产 trace 或合成数据构建的数据集,用于回归测试的离线评测,带过滤和采样率的在线评测, LLM-as-judge(包括无需参考答案的在线 judge)、人工审核、代码规则和成对比较。Studio 提供交互式环境来调试 Agent。 OpenTelemetry 通过带 x-api-key 请求头的 /otel 端点接入,langsmith[otel] 扩展可以让 trace 只发送到你自己的 OTel 端点。 关于私有云部署,我们另有一篇 LangSmith BYOC on AWS 架构指南(英文)。
劣势。按席位计价会随团队增长,页面上没有公开 trace 单价,自托管需要 Enterprise 合同。通过 OTel 的摄取是异步的, 文档警告说,如果某个 span 的父 span 始终没有到达,子 span 最终会被丢弃且不报错。最适合:希望在同一平台内完成追踪、评测和部署的 LangChain 与 LangGraph 团队。
视频:LangChain 官方对 LangSmith 的概览,涵盖 Agent 可观测性、评测和部署。
Langfuse
Langfuse 是大多数团队首先想到的开源选项。它覆盖追踪、提示词管理、数据集、实验和评估器,在云端和自有基础设施上的运行方式相同。 其仓库标注为 MIT 许可,而 LICENSE 文件注明软件的部分内容采用不同的许可,如果你打算再分发,请仔细阅读。
价格(截至 2026 年 11 月 11 日):Hobby 免费,每月 50k units、30 天数据访问、2 个用户。Core 每月 $29,含 100k units、90 天、用户不限。 Pro 每月 $199,含 100k units 和三年数据访问。Enterprise 每月 $2,499。Pro 还有可选的 Teams 附加包,每月 $300。超额为每 100k units $8, 之后阶梯下降为 $7(1M 到 10M)、$6.50(10M 到 50M)和 $6(50M 及以上)。数据保留管理仅限 Pro 和 Enterprise。自托管免费;定价页指向单独的自托管页面了解详情。
优势。评测文档列出了作用于线上 trace 的 LLM-as-a-judge、可复用的数据集、用于比较提示词/模型/代码变更的实验、标注队列、代码评估器, 以及衡量人工与 AI 标注一致性的分数分析。langfuse/experiment-action GitHub Action 会在 pull request 上运行实验, 并在分数低于阈值时抛出 RegressionError。OpenTelemetry 接入位于 /api/public/otel,文档称旧的摄取端点已弃用,推荐使用 OTLP。 区域包括 EU、US、日本和 HIPAA 云。
# Send OpenTelemetry traces from one app to Langfuse and a second backend
# via an OpenTelemetry Collector (pattern documented by LangSmith and Langfuse).
export OTEL_EXPORTER_OTLP_ENDPOINT="https://us.cloud.langfuse.com/api/public/otel"
export OTEL_EXPORTER_OTLP_HEADERS="Authorization=Basic ${AUTH_STRING},x-langfuse-ingestion-version=4"

# AUTH_STRING = base64 of "pk-lf-...:sk-lf-..."
echo -n "pk-lf-...:sk-lf-..." | base64劣势。Langfuse 仅接受 HTTP 上的 OTLP,不支持 gRPC。按文档所述,如果没有 x-langfuse-ingestion-version: 4 请求头, 直接发送的 OTel 数据最多可能需要十分钟才会出现。按 units 计价意味着每个请求产生大量 observation 的话痨型 Agent 会很快消耗额度。 ClickHouse 收购在纸面上是稳定的,但公告没有涉及定价。最适合:想要一个开放、可自托管、追踪与评测闭环完整的默认方案的团队。
Braintrust
Braintrust 把自己定位为以评测为核心的 Agent 可观测性平台:追踪生产环境、打分,并在用户遇到之前发现回归。它是托管产品, 定价页仅在 Enterprise 下列出本地部署或托管部署。
价格(截至 2026 年 11 月 11 日):Starter 为 $0,含 1 GB 处理数据、10k 分数、14 天保留期,用户、项目、数据集和实验不限。 Pro 每月 $249,含 5 GB、50k 分数和 30 天保留期。数据超额在 Starter 为每 GB $4,Pro 为每 GB $3;分数超额分别为每 1,000 个 $2.50 和 $1.50。 Pro 增加自定义图表和环境,以及不限数量的人工审核分数;Starter 每个项目允许一个。Pro 超出包含的 30 天后,保留期为每 GB 每月 $0.50。 符合条件的初创公司可免费使用 Pro 6 到 12 个月。Enterprise 增加自定义 RBAC 和高级支持。
优势。评分器可由 autoevals、LLM-as-judge 或自定义代码构建,在线打分异步评估生产 trace,不影响延迟。数据集保存输入和可选的预期输出, 文档描述了从代码或 UI 运行实验以及在 CI/CD 中运行。OpenTelemetry 通过 api.braintrust.dev/otel 的 OTLP/HTTP 接入,使用 Bearer 密钥和x-bt-parent 请求头,并提供 EU 和 BYOC 数据平面网址。劣势。分数是计量单位,大量在线打分可能主导账单; 基础档 14 天和 30 天的保留期,与 Langfuse Pro 的三年相比很短。它没有被列为开源。最适合:以评测分数作为发布门禁并想要成熟托管工作流的团队。
Arize Phoenix 与 Arize AX
Phoenix 是 Arize 及其社区的开源追踪与评测工具。文档称它基于 OpenTelemetry,并使用 OpenInference 做插桩, 对框架、模型提供商和语言(包括 Python、TypeScript 和 Java)提供自动插桩。Arize AX 是基于相同开放标准构建的托管平台。
价格(截至 2026 年 11 月 11 日):根据自托管文档,Phoenix 可免费自托管,没有功能限制、许可费或用量限制。仓库 LICENSE 为 Elastic License 2.0, 属于源码可见而非 OSI 开源,请对照你的使用场景检查。AX Free 为 $0,含 25k span、1 GB 摄取和 15 天保留期。 AX Pro 每月 $50,含 50k span、10 GB 和 30 天。AX Enterprise 为定制价,也是唯一列出自托管的计划。三个 AX 计划的用户和评测都不限量。定价页没有描述超额计费。
优势。评估器可以是基于 LLM 的、基于代码的或人工标注,Phoenix 还能导入 Ragas、DeepEval 和 Cleanlab 的评估器。 它还提供提示词管理、playground、span 重放、数据集和实验。部署方式包括 Docker、Kubernetes、Helm,以及 Railway、Render、Cloud Run 和 Azure 的一键模板。劣势。AX Pro 仅 50k span 偏小,ELv2 许可证禁止把 Phoenix 作为托管服务提供给他人。最适合:想要无功能限制的开源工具的团队,尤其是做 RAG 与检索评测。 如果你要调试检索质量,我们的 向量数据库对比 覆盖了问题的另一半。
Weights & Biases Weave
Weave 是 W&B 用于追踪和评测 LLM 应用的工具包。Python SDK 在 GitHub 上为 Apache-2.0。定价和文档已迁移到 CoreWeave 旗下站点: wandb.ai/site/pricing 重定向到 CoreWeave Forge 定价页,Weave 文档重定向到 docs.coreweave.com。
价格(截至 2026 年 11 月 11 日):Free 为 $0,含 1 GB Weave 数据摄取、5 GB 存储和最多 5 个模型席位。Pro 每月 $60 起, 含 1.5 GB 摄取、100 GB 存储和最多 10 个席位,超出包含摄取量的部分为每 MB $0.10。Enterprise 为定制价,超额为每 MB $0.20, 提供专属或自管部署以及自带存储桶选项。页面称 Pro 面向员工少于 50 人的早期团队。学术研究免费。页面没有说明 trace 的保留期。
优势。OpenTelemetry 通过 trace.wandb.ai/otel/v1/traces 的 protobuf 端点接入,使用 wandb-api-key 请求头; Python SDK 附带本地小模型评分器(毒性、偏见、幻觉、上下文相关性、连贯性、流畅度、综合信任分,以及通过 Presidio 的 PII 检测)。 如果你的团队已经在 W&B 里追踪模型训练,把实验和 LLM trace 放在同一个工作区确实方便。劣势。摄取按 MB 计费,比按 trace 计价更难预测, 本地评分器仅限 Python,而且我无法从抓取的页面确认数据集和 CI 的细节。最适合:已在使用 W&B 的机器学习团队。
Helicone
Helicone 最初是一个记录 LLM 请求的代理:你把兼容 OpenAI 的客户端指向它的 AI Gateway,请求就会出现在仪表盘中,并带有模型回退和统一计费。 仓库在 GitHub 上为 Apache-2.0。
价格(截至 2026 年 11 月 11 日):Hobby 免费,含 10,000 个请求、7 天保留期和 1 个席位。Pro 每月 $79,席位不限,保留期 1 个月。 Team 每月 $799,含 5 个组织、3 个月保留期、SOC-2 和 HIPAA 合规。Enterprise 为定制价,列出本地部署和 SAML SSO。每个档位都包含 1 GB 存储。
需要注意的是所有权。Mintlify 宣布收购了 Helicone,并表示产品将以维护模式继续运行,提供安全更新、缺陷修复和新模型, 并帮助客户迁移到其他平台。Helicone 的定价页现在称其属于 Experiential Labs,细节待公布。我没有找到关于长期路线图或自托管承诺的公开声明。 快速入门文档描述的是代理集成,没有提到 OpenTelemetry。最适合:今天就想要请求日志的现有用户;新项目我们会选择仍在积极开发的替代品。 如果你想要的是网关功能,请看 网关汇总。
Datadog LLM Observability
Datadog 的产品会跟踪每个请求经过的提示词、检索步骤、工具调用和 Agent 决策,使用与其 APM 栈其余部分相同的 tracer。 自动插桩覆盖 OpenAI、Anthropic、Gemini、Vertex AI、Bedrock、LangChain、CrewAI、Pydantic、LiteLLM 和 Strands Agents,SDK 支持 Python、Node.js 和 Java。
价格(截至 2026 年 11 月 11 日,来自产品页):Free 为 $0,最多 40K 个 LLM span,保留 15 天。Pro 每月 $160,最多 100K 个 LLM span, 超出部分按需计费。只对 LLM span 计费,即对 LLM 提供商的一次调用;tool、workflow、agent、embedding 和 retrieval span 免费。 保留期附加包可将 trace 延长到 30、60 或 90 天。评测没有单独收费,但评测所发起的任何 LLM 调用都计入 LLM span。 我无法获取定价页上的详细费率表,所以预算前请与 Datadog 确认。
优势。内置和自定义评估器、离线与在线评测、人工审核、对幻觉、提示注入和 PII 的检测、来自生产 trace 的数据集,以及用于比较提示词和模型的实验。 Agent 运行可与 APM 服务、基础设施和 RUM 会话关联,并有针对延迟、成本和质量的监控。自定义框架和其他语言可通过 OpenTelemetry 或 HTTP API 插桩。劣势。仅提供 SaaS,如果你不是 Datadog 客户则价值最低,默认保留期较短。最适合:希望 LLM 遥测数据与现有基础设施告警放在一起的团队。
Galileo(Splunk Agent Observability)
Galileo 构建了面向 Agent 的评测和护栏。Splunk 的收购页面称 Cisco 已完成对 Galileo 的收购,Galileo 现为 Splunk Agent Observability, 帮助团队评估并改进 Agent 行为、跟踪用量和成本,并对全部流量应用实时护栏。媒体报道把公告日期定为 2026 年 4 月 9 日, 并称 Luna-2 是 Galileo 用于常开评测的小语言模型系列。galileo.ai/pricing 现已重定向到 Splunk 的定价页。
价格(截至 2026 年 11 月 11 日):Splunk 页面列出 Agent Observability 起价为每月 $100 / 120 万 span,按年计费, 每年包含 5 亿 Luna token 和 5 次 Luna 微调运行,可购买延长保留期,可用于 Observability Cloud 和自托管部署。 页面没有点名提到 Galileo,也没有说明旧免费档和现有 Galileo 合同会如何处理。优势:为评测和护栏专门构建的小模型,以及 Splunk 与 Cisco 对企业落地的支持。劣势:按年计费、前 Galileo 用户的迁移路径不明确,并且在我抓取的页面中没有 OpenTelemetry 文档。最适合:以 Splunk Observability Cloud 为标准的企业。
Opik(Comet)
Opik 是 Comet 的开源 LLM 评测与追踪平台。仓库为 Apache-2.0 且非常活跃,定价页显示自托管时 span 不限量。
价格(截至 2026 年 11 月 11 日):Open Source 为 $0 自托管,span 和保留期不限。Free Cloud 为 $0,每月 25k span、60 天保留期、最多 10 名团队成员。 Pro Cloud 每月 $19,含 100k span、最多 50 名团队成员,额外 span 每 100k $5,延长保留期(60 到 400 天)每 100k span $29。 Enterprise 为定制价,增加 SSO、SLA 和合规认证。
优势。本汇总中最便宜的付费云入口。评测文档描述了带自然语言断言并由 LLM judge 检查的 Test Suites、30 多个预置指标(如幻觉、相关性和连贯性)、 并排的实验追踪和标注队列。OpenTelemetry 通过 /api/v1/private/otel 的 OTLP/HTTP 接入。劣势。gRPC exporter 会导致错误, 没有根 span 的 trace 不会出现在 Traces 标签页中,我也没有从抓取的页面确认 pytest 或在线评测规则。最适合:想要一个开放、便宜且有托管档的小团队。
Laminar
Laminar 是面向 Agent 的开源可观测性平台。其文档列出了对 AI SDK、Claude Agent SDK、LangChain 和 Browser Use 的追踪,仓库为 Apache-2.0。
价格(截至 2026 年 11 月 11 日):Free 为 $0,含 1 GB 数据、7 天保留期、1 个项目和 1 个席位,无超额计费。Starter 每月 $30,含 3 GB, 超额每 GB $2,保留 30 天。Pro 每月 $150,含 10 GB,超额每 GB $1.50,保留 6 个月。Starter 及以上项目和席位不限。Enterprise 增加本地部署。 计费按数据量,适合 trace 很长的 Agent,但与按 span 计价不同。
优势。Laminar 后端接受 gRPC 上的 OTLP,这也是推荐路径,地址为 api.lmnr.ai:8443。其评测文档描述了在本地或 CI 中运行的 evaluate()、 在隔离的环境副本中运行你的 Agent 并对结果和轨迹打分的 Agent 评测、由生产 trace 构建的数据集,以及一个 Debugger: 它会记录一次运行,从缓存重放到被测试的位置,并用评测验证修复。劣势。项目较新,社区规模比 Langfuse 或 Phoenix 小,免费档仅保留 7 天。最适合:调试长时间运行或由浏览器驱动的 Agent 的团队。需要插桩的框架请参阅我们的 Agent 框架汇总。
Promptfoo
Promptfoo 与其他工具不同:它是用于运行评测和红队测试的 CLI 与库,并且完全在本地运行。文档称评测在你的机器上运行,直接与模型提供商通信。 仓库为 MIT 许可。
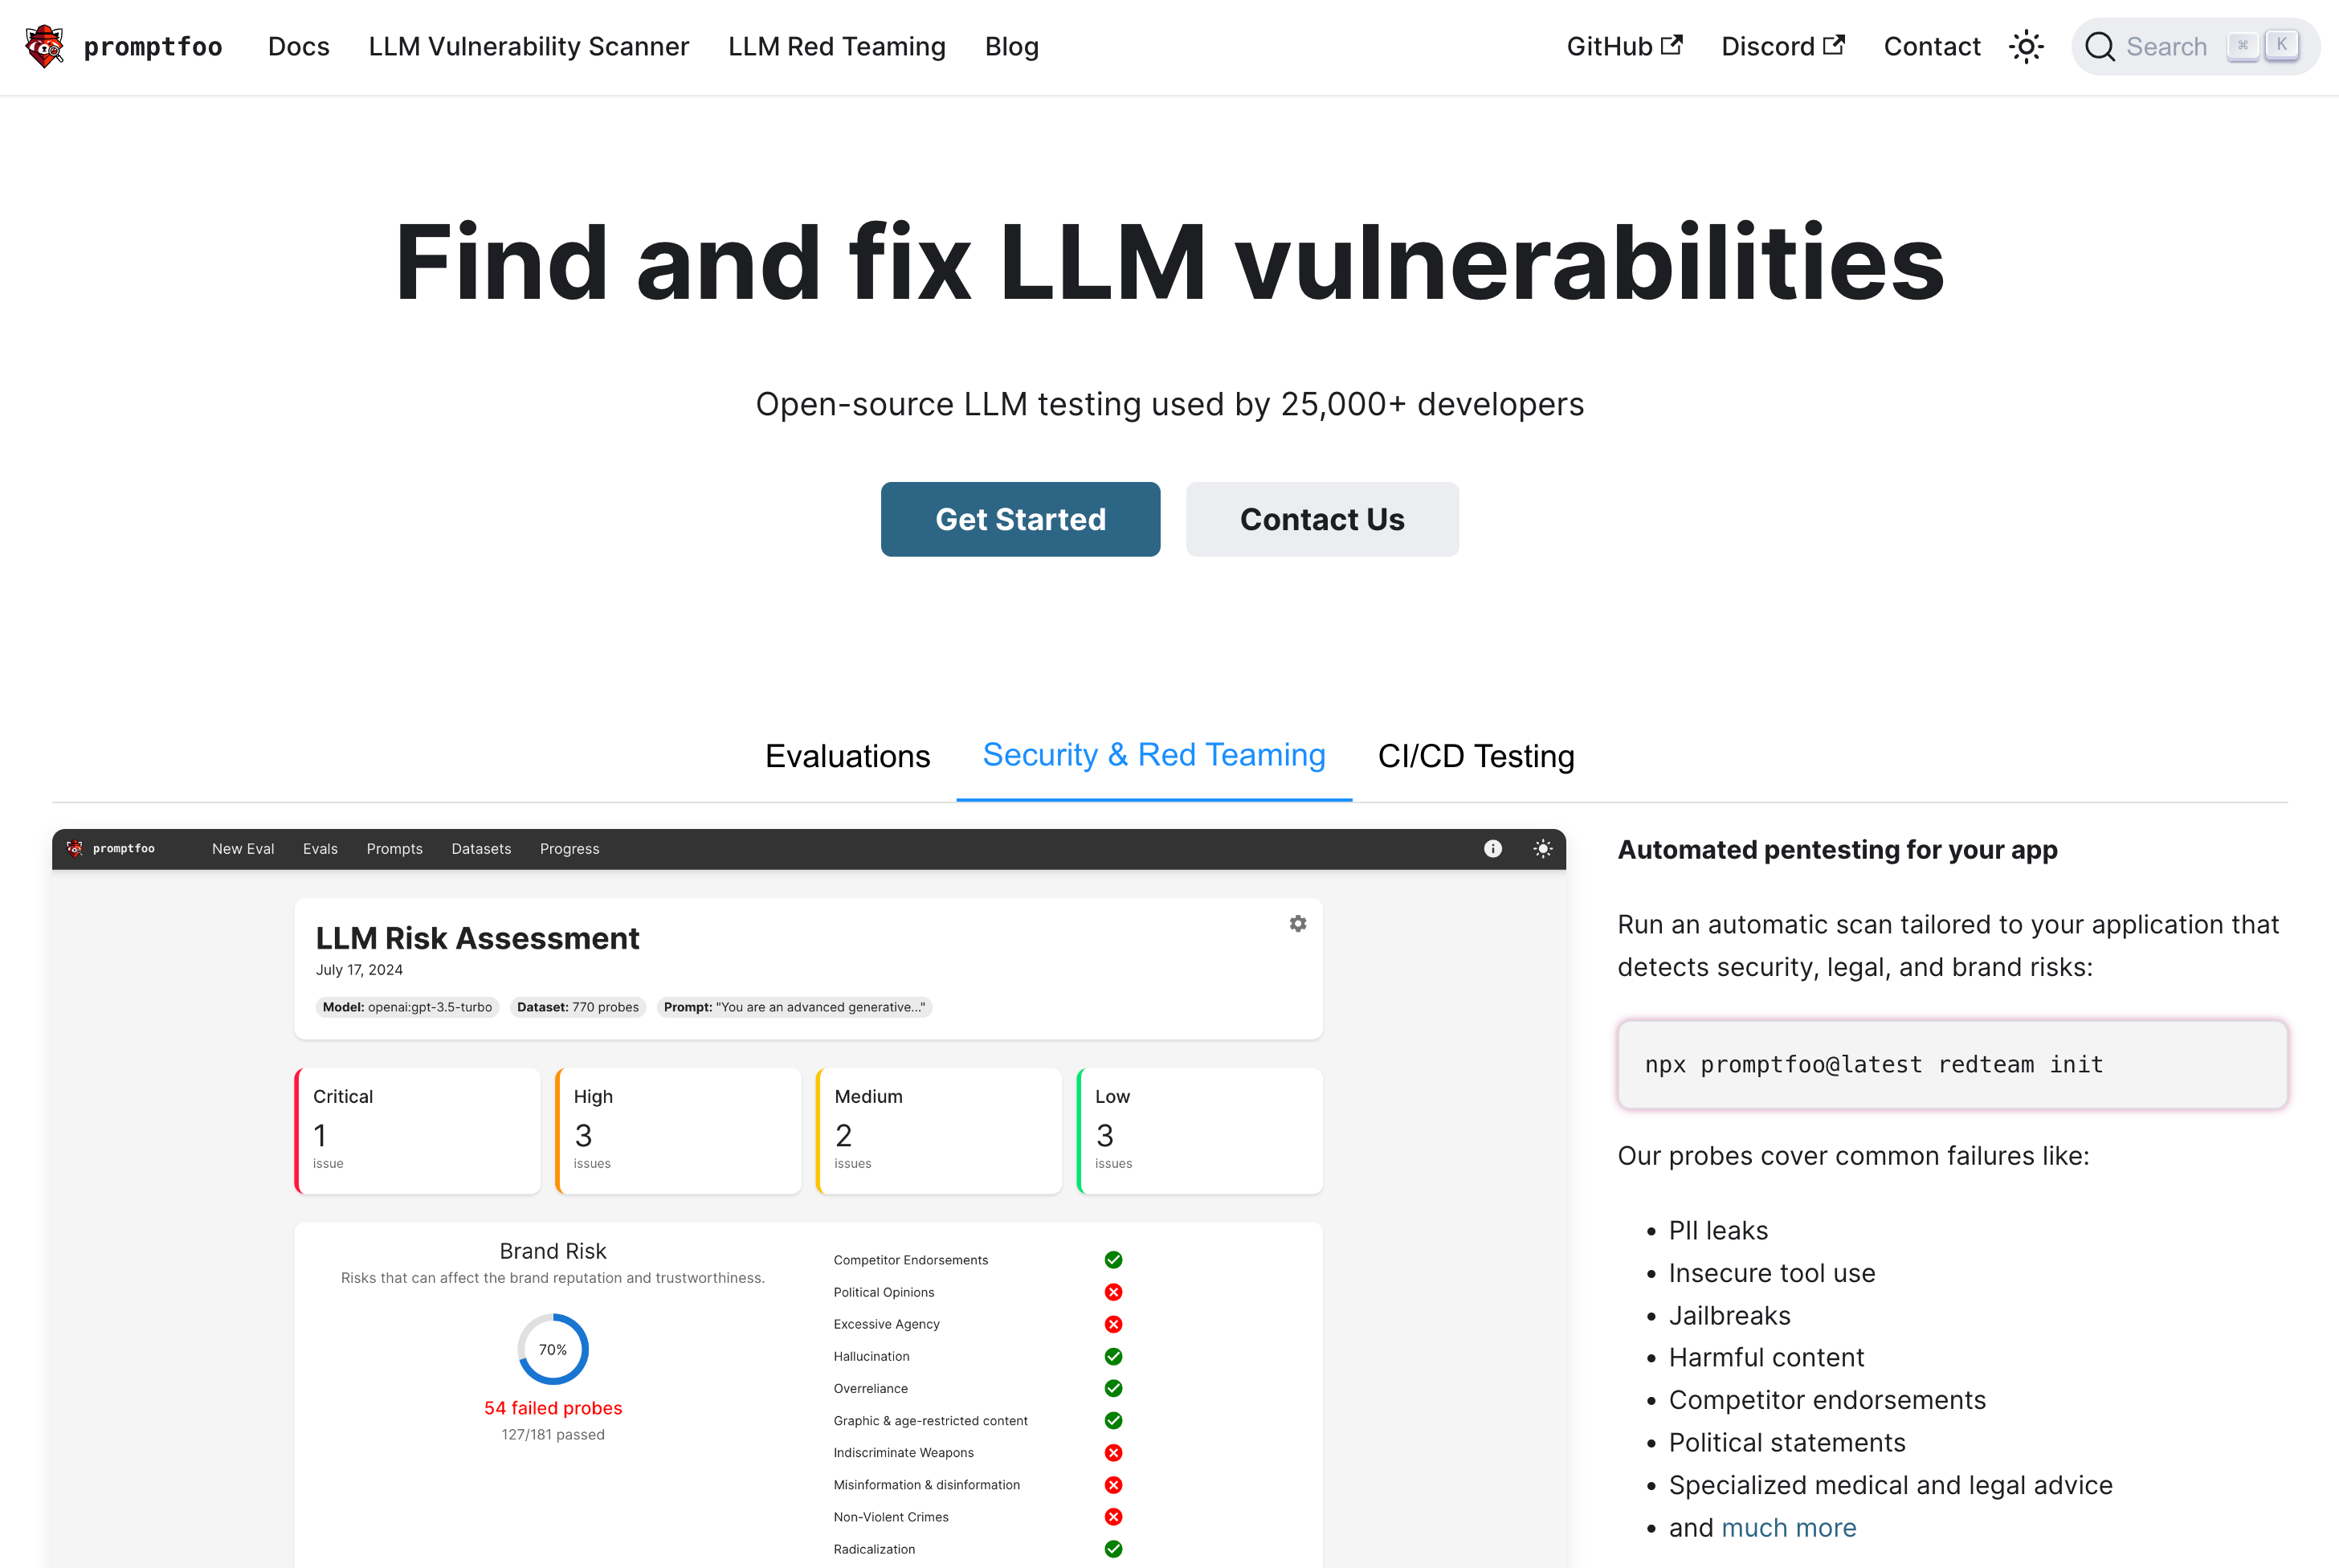
价格(截至 2026 年 11 月 11 日):Community 永久免费,包含全部评测功能、全部提供商、自托管或本地运行、漏洞扫描, 以及每月上限 10k 探测的红队测试。Enterprise 为定制价,增加团队共享、持续监控、SSO、API 访问和托管云。On-Premise 为定制价,增加在你自己的基础设施上部署和专用 runner。 2026 年 3 月 9 日,Promptfoo 表示已同意被 OpenAI 收购,交易需满足常规交割条件,并表示 Promptfoo 将继续开源。我们没有确认交割日期。
# promptfooconfig.yaml (pattern from the Promptfoo getting-started docs)
description: Automatic response evaluation using LLM rubric scoring
prompts:
  - file://prompts.txt
providers:
  - openai:gpt-6-sol
defaultTest:
  assert:
    - type: llm-rubric
      value: Do not mention that you are an AI or chat assistant
tests:
  - vars:
      name: Bob
      question: Can you help me find a specific product on your website?
用 npx promptfoo@latest eval 运行,用 npx promptfoo@latest view 查看结果;结果也可以输出为 JSON、YAML、HTML 或电子表格。 对于 CI,文档给出了一个 GitHub Actions 工作流,运行评测并在失败数大于零时让任务失败:
name: LLM Eval
on:
  pull_request:
    paths: ['prompts/**', 'promptfooconfig.yaml']
jobs:
  evaluate:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with: { node-version: '24' }
      - run: npx promptfoo@latest eval -c promptfooconfig.yaml -o results.json
        env:
          OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
      - run: |
          FAILURES=$(jq '.results.stats.failures' results.json)
if [ "$FAILURES" -gt 0 ]; then exit 1; fi劣势。它不是追踪后端,所以生产可见性仍需要上面的某个工具。最适合:在 CI 中对 Agent 和 RAG 应用做提示词回归测试与安全测试。 它与会修改提示词的编码 Agent 搭配效果很好,请看我们的 最佳 AI 编码 Agent 指南(英文)。
OpenTelemetry 支持对比
OpenTelemetry(OTel)是让插桩保持可移植的实用方式。这份名单中的大多数工具现在都接受 OTLP,但传输方式、认证和属性约定各不相同, 这些细节决定了 trace 能否干净地显示出来。Langfuse 和 Opik 只接受 HTTP。Laminar 推荐 gRPC。LangSmith 会把 langsmith.* 和 gen_ai.* 属性映射到它的 run 字段, 而 Langfuse 让自己的 langfuse.* 属性优先于通用的 GenAI 约定。
| 工具 | 文档所述(截至 2026 年 11 月 11 日) |
|---|---|
| LangSmith | OTLP/HTTP,路径 /otel;使用 x-api-key 请求头;langsmith[otel] SDK 开关;也可导出到其他后端 |
| Langfuse | OTLP/HTTP,路径 /api/public/otel(JSON 或 protobuf);不支持 gRPC;Basic 认证;需发送 x-langfuse-ingestion-version: 4 |
| Braintrust | OTLP/HTTP,api.braintrust.dev/otel;Bearer 密钥加 x-bt-parent;提供 EU 和 BYOC 数据平面 |
| Arize Phoenix | 基于 OpenTelemetry,使用 OpenInference 插桩;接受 OTLP traces |
| W&B Weave | OTLP protobuf,trace.wandb.ai/otel/v1/traces;wandb-api-key 请求头;专属和自管主机 |
| Helicone | 代理或 AI Gateway 集成;快速入门页面未提及 OpenTelemetry |
| Datadog | Datadog SDK 支持 Python、Node.js、Java;自定义技术栈可用 OpenTelemetry 或 HTTP API |
| Galileo / Splunk | 在我抓取的页面中没有文档说明;请查阅 Splunk 文档 |
| Opik | 仅支持 OTLP/HTTP;gRPC exporter 会报错;需设置 opik.project_name 资源属性 |
| Laminar | OTLP over gRPC(推荐),api.lmnr.ai:8443,自托管端口 8001 |
| Promptfoo | 不是追踪后端;评测在本地运行 |
LangSmith 和 Langfuse 文档中有一个值得借鉴的做法:通过 OpenTelemetry Collector 做扇出,让同一个应用在迁移期间把相同的 span 发送到两个后端。 在 collector 中过滤 span 时要保留根 span;Langfuse 和 Opik 都警告说,没有根 span 的 trace 会损坏或消失。
评测功能对比
“评测”涵盖四项工作:给线上 trace 打分、发布前在数据集上运行、收集人工标签,以及 CI 门禁。下表记录了各厂商文档页所述内容; “未涉及”表示我抓取的页面没有提到,并不表示该功能不存在。
| 工具 | LLM-as-judge / 在线评测 | 数据集 | CI | 人工及其他 |
|---|---|---|---|---|
| LangSmith | 支持,离线与在线 | 来自 trace、合成数据、人工整理的数据集 | 我抓取的评测页面未涉及 | 人工审核、代码规则、成对比较 |
| Langfuse | 支持,作用于线上 trace | 可复用的数据集与实验 | langfuse/experiment-action 在分数低于阈值时让 PR 失败 | 标注队列、代码评估器 |
| Braintrust | 支持,在线打分异步运行 | 带预期输出的数据集 | 文档位于 Run in CI/CD | 人工审核分数、autoevals |
| Phoenix | 支持,并可导入 Ragas、DeepEval | 数据集与实验 | 通过 SDK 实验 | 人工标注、代码检查 |
| Weave | 支持(scorers、本地小模型评分器) | 抓取页面未涉及 | 抓取页面未涉及 | 毒性、偏见、PII 的本地评分器 |
| Helicone | 抓取页面未涉及 | 未涉及 | 未涉及 | 会话与日志 |
| Datadog | 支持,内置与自定义 | 来自生产 trace 的数据集、实验 | 抓取页面未涉及 | 人工审核与标注 |
| Galileo / Splunk | Luna-2 小模型用于常开评测(Splunk 表述) | 抓取页面未涉及 | 未涉及 | 实时护栏 |
| Opik | 带自然语言断言的 Test Suites | 数据集与 30+ 指标 | 抓取页面未涉及 pytest | 标注队列 |
| Laminar | 支持,通过 evaluate() | 来自生产 trace 的数据集 | 本地或 CI | Agent 轨迹评分 |
| Promptfoo | llm-rubric 断言 | YAML 测试用例 | GitHub Action、质量门禁 | 红队测试 |
如果你的 Agent 还有长期记忆,请单独评估召回质量; Agent 记忆工具汇总 介绍了相关选项。关于云厂商把评测作为平台功能推出的例子,请看我们的 Gemini Enterprise Agent 评测指南(英文)。
基准与独立数据
目前没有中立的公开基准可以给这些平台排名。追踪开销、摄取延迟和评测准确率取决于你的 SDK、采样、负载大小和 judge 模型,而厂商并不公布可比的数字。 我们没有运行自己的基准,也不发布任何性能分数。我们能核实的是文档记载的行为,例如 Langfuse 提到没有 ingestion-version 请求头时,直接发送的 OTel 数据最多会延迟十分钟, 以及 LangSmith 提到摄取是异步的。GitHub 活跃度在 2026 年 11 月 12 日给出了一个粗略的维护信号:Langfuse 约 37.3k 星,Opik 约 23.4k,Promptfoo 约 27.1k, Phoenix 约 12.3k,Helicone 约 6.3k,Laminar 约 3.5k,Weave 约 1.1k。星标衡量的是关注度而非质量,请仅作背景参考。
如何选择
| 如果你…… | 推荐 | 说明 |
|---|---|---|
| 你用 LangChain 或 LangGraph 并希望零摩擦 | LangSmith | 原生追踪和 Studio;按席位计价,注意席位数量。 |
| 需要自托管但不想签企业合同 | Langfuse、Phoenix、Opik 或 Laminar | 四者都提供免费的自托管路径。 |
| 评测决定发布门禁 | Braintrust 或 Promptfoo | 评分器、数据集和 CI 是主要工作流。 |
| 你已经在用 Datadog 或 Splunk | Datadog LLM Observability 或 Splunk Agent Observability | 同一厂商,共享告警和 APM 上下文。 |
| Agent 运行数分钟并在中途失败 | Laminar 或 LangSmith | 重放和 Studio 有助于调试长轨迹。 |
| 想要最便宜的托管档 | Opik Pro $19、Arize AX Pro $50 | 对比 span 额度,而不只是价格。 |
| 想避开处于变动中的厂商 | OTLP 加 Phoenix、Langfuse 或 Opik | OpenTelemetry 让你的插桩可移植。 |
| 只需要提示词回归测试 | Promptfoo | 一个 YAML 文件加一个 CI 任务,无需运行后端。 |
合理的落地分三步。第一步,在一个服务上用 OTel 或工具自带的 SDK 做插桩,确认完整的 trace(包括工具调用)能显示出来。第二步, 把 20 到 50 个真实的生产失败案例做成数据集,写两到三个评估器,其中至少一个是确定性的。第三步,加入 CI 门禁和带采样的在线 judge, 并在信任 judge 分数之前先对照人工标签检查。如果你还自托管网关做路由, OmniRoute 配置指南(英文) 和 Vercel AI Gateway 指南(英文) 展示了日志应挂在哪里。Agent 本身的托管请看 最佳 AI Agent 托管平台。
评估方法
我们在 2026 年 11 月 11 日抓取了各厂商的定价页、文档和仓库,每个价格、限额和许可证都使用第一方来源。当页面没有说明某项内容时, 我们明确写出这一点,而不是自行填补空白。收购相关事实在能抓取到的情况下来自公司自己的文章,否则来自媒体报道,并已相应标注。 本排名没有付费推广、联盟链接或赞助。价格经常变动,承诺之前请到厂商页面确认。
常见问题
2026 年最好的 LLM 可观测性工具是什么?
没有唯一的赢家。对大多数团队来说,Langfuse 是最稳妥的默认选择:核心为 MIT 许可,可免费自托管,覆盖追踪、数据集、LLM-as-judge 和 CI。如果你基于 LangChain 或 LangGraph 开发,LangSmith 最合适。Braintrust 适合评测优先的团队。Phoenix、Opik 和 Laminar 是不错的开源替代品;如果你已经在用 Datadog 或 Splunk,则可以沿用它们。
Langfuse 和 LangSmith 该选哪个?
如果你的技术栈是 LangChain 或 LangGraph 并想要最紧密的集成,选 LangSmith;Plus 每席位每月 $39,自托管仅限 Enterprise(截至 2026 年 11 月 11 日)。如果你想要开源、免费自托管、付费云计划不限用户数以及按用量计价,选 Langfuse:Core 每月 $29,Pro 每月 $199。
哪些工具是开源且可免费自托管的?
Langfuse(MIT 核心)、Arize Phoenix(Elastic License 2.0,免费且无功能限制)、Opik(Apache-2.0)、Laminar(Apache-2.0)和 Promptfoo(MIT)都提供免费的自托管或本地路径。Weave 的 SDK 是 Apache-2.0,但其托管后端是 W&B 与 CoreWeave 的产品。LangSmith 和 Braintrust 把自托管列在 Enterprise 下。
这些工具支持 OpenTelemetry 吗?
大多数支持。LangSmith、Langfuse、Braintrust、Weave、Opik 和 Laminar 都有文档化的 OTLP 接入端点,Phoenix 则基于 OpenTelemetry 并使用 OpenInference。注意传输细节:Langfuse 和 Opik 接受 HTTP 上的 OTLP 而非 gRPC,Laminar 则推荐 gRPC。Helicone 使用代理式集成,其快速入门页面未提及 OpenTelemetry。
2026 年 Helicone、Galileo 和 Promptfoo 发生了什么?
Helicone 在 2026 年 3 月宣布被 Mintlify 收购并表示将以维护模式运行,其定价页面现在写着它属于 Experiential Labs。Cisco 已完成对 Galileo 的收购,Galileo 现为 Splunk Agent Observability。OpenAI 在 2026 年 3 月 9 日宣布同意收购 Promptfoo,后者表示将继续开源。Langfuse 在 2026 年 1 月 16 日加入 ClickHouse,并表示许可证和自托管不变。
小团队使用 LLM 可观测性要花多少钱?
你可以从 $0 起步:Langfuse Hobby、LangSmith Developer、Braintrust Starter、Arize AX Free、Opik Free Cloud、Laminar Free 或 Datadog 的免费档。截至 2026 年 11 月 11 日,最便宜的付费入口是每月 $19 的 Opik Pro 和每月 $29 的 Langfuse Core。要留意各家的计量单位不同:trace、span、GB 数据、分数或请求。
已经有追踪了,还需要单独的评测工具吗?
通常不需要。Langfuse、LangSmith、Braintrust、Phoenix、Datadog、Opik 和 Laminar 都把追踪与数据集、评估器结合在一起。Promptfoo 是例外,它没有追踪后端,只做评测和红队测试,适合与其他任一工具搭配,作为 CI 门禁。
可以避免厂商锁定吗?
尽可能用 OpenTelemetry 以及 gen_ai 或 OpenInference 约定做插桩,并保持数据集可导出。由于 2026 年有多款工具换了东家,可移植的插桩是务实的对冲手段。这是我们的推断,不是厂商的保证。
LLM-as-judge 可靠到可以用于生产门禁吗?
它有用,但存在偏差和噪声。包括 Langfuse 在内的厂商提供分数分析,用来衡量人工与 AI 标注之间的一致性,这是正确的做法。把任何 judge 用作发布门禁前,先用人工标注的样本校准,并与确定性的代码检查结合使用。
来源
除特别注明外,均抓取于 2026 年 11 月 11 日。
- LangSmith pricing
- LangSmith OpenTelemetry docs
- LangSmith evaluation docs
- LangSmith observability page
- Langfuse pricing
- Langfuse OpenTelemetry docs
- Langfuse evaluation overview
- Langfuse joins ClickHouse (Jan 16, 2026)
- Langfuse repository and LICENSE
- Braintrust pricing
- Braintrust OpenTelemetry docs
- Braintrust evaluate docs
- Arize pricing
- Phoenix docs
- Phoenix self-hosting docs
- Phoenix repository and LICENSE (Elastic License 2.0)
- W&B Weave pricing (CoreWeave Forge)
- Weave OpenTelemetry docs
- Weave local scorers docs
- Weave repository
- Helicone pricing
- Helicone quick start
- Mintlify acquires Helicone
- Helicone repository
- Datadog LLM Observability product page
- Splunk pricing (Agent Observability)
- Splunk: Cisco completes Galileo acquisition
- Opik pricing (Comet)
- Opik OpenTelemetry docs
- Opik evaluation docs
- Opik repository
- Laminar pricing
- Laminar docs overview
- Laminar OpenTelemetry docs
- Laminar repository
- Promptfoo pricing
- Promptfoo getting started
- Promptfoo CI/CD docs
- Promptfoo joining OpenAI (Mar 9, 2026)
- Promptfoo repository
- Langfuse walkthrough video (Langfuse YouTube)
- LangSmith overview video (LangChain YouTube)