Get the latest on AI, LLMs & developer tools
New MCP servers, model updates, and guides like this one — delivered weekly.
AI 电话 Agent 由三层叠加而成:一个能把实时通话交给软件的电话号码,一个听说都足够快、让人感觉像真人的模型, 以及几个让它能做点实事(比如预约)的工具。2026 年,这三样你既可以买现成的托管产品,也可以一个下午自己拼起来。 本指南先选路线,再用真实代码、真实号码、预约工具、成本模型,端到端构建其中一条,并说明拨打任何电话之前必须了解的规则。
简短回答
如果本周就要试点,用 Vapi 或 Retell。如果你会写代码、想走最短路径,就基于 OpenAI Realtime 加 Twilio Media Streams 构建,这也是下文要搭的路线。如果想自由替换语音和语言模型厂商, 就用 LiveKit Agents 或 Pipecat,配合 Twilio SIP 或 WebSocket 连接。按 2026 年 11 月 11 日的标价, 自建语音到语音路线的下限大约是呼入每分钟 $0.028 到 $0.061(我们的算术,详见成本一节), 而托管平台公布的示例在每分钟 $0.048 到 $0.129 之间。按 FCC 2024 年的裁定,用 AI 语音给消费者外呼有同意要求, 所以先搞定同意,再选模型。
OpenAI Devs 宣布 Realtime API 达到生产可用,并推出语音到语音模型 gpt-realtime,新增能力中包括 SIP 电话呼叫。
— @OpenAIDevs 2025 年 8 月 28 日
该选哪种技术栈?
现实中有三条路线,区别在于音频流水线归谁、要写多少代码。如果你还在挑平台,我们的 语音 AI Agent 平台对比(英文) 对托管选项做了排名, LiveKit Agents vs Pipecat(英文) 则深入讲第 2 条路线。
| 路线 | 工具 | 你要构建什么 | 电话号码 | 公布的每分钟成本 | 适用场景 |
|---|---|---|---|---|---|
| 1. 无代码平台 | Vapi 或 Retell | 一段提示词、一个声音,外加给工具用的 webhook。以控制台为主,SDK 可选。 | 免费 Vapi 号码(仅呼入),或导入 Twilio、Telnyx、DIDWW 号码。Retell 定价页提供 Retell 自有电话服务或自带 Twilio、Telnyx。 | Vapi:定价示例为每分钟 $0.082 到 $0.129。Retell:示例为每分钟 $0.11,页面区间 $0.07 到 $0.31。 | 本周就要上线试点,或者通话流程每周都在改、非工程师也要编辑。 |
| 2. 开源代码 | LiveKit Agents 或 Pipecat,配合 Twilio SIP 或 Media Streams | 一个 Python(或 Node)Agent worker,加上 trunk 和 dispatch 配置。STT、LLM、TTS 厂商自己选。 | 把 Twilio 号码指向 LiveKit SIP trunk,或指向一个打开 WebSocket 连接 Pipecat 机器人的 TwiML Bin。 | LiveKit Cloud 默认配置估算每分钟 $0.0479。Pipecat Cloud 托管起价每分钟 $0.01。自托管:只付算力。 | 想自由替换模型和厂商、掌控整条流水线,或要跑在自己的云上。 |
| 3. 语音到语音 API | OpenAI Realtime + Twilio Media Streams(或 OpenAI SIP) | 一个小服务器:一条 TwiML 路由、一个 WebSocket 转发、你的工具处理函数。 | 一个语音号码,webhook 返回带 Stream 的 TwiML;或把 SIP trunk 指向 OpenAI。 | gpt-realtime-2.1 语音 token 下限每分钟 $0.048(mini 为 $0.015),外加 Twilio 呼入 $0.0129。我们按标价算出。 | 你会写代码、希望模型只用一家厂商,并且想要来电者到模型之间最短的链路。 |
按目标快速选择:
| 目标 | 选择 | 原因 |
|---|---|---|
| 最快拿到可用号码,不写代码 | Vapi 或 Retell | Vapi 的快速入门会创建一个助手、分配一个免费美国号码,几分钟内就能打电话测试。免费 Vapi 号码只支持呼入;外呼需要导入 Twilio、Telnyx 或 DIDWW 号码。 |
| 控制力最强、开源 | LiveKit Agents 或 Pipecat,配合 Twilio SIP | LiveKit 把通话建模为通过 trunk 和 dispatch rule 加入房间的 SIP 参与者。Pipecat 提供 Twilio WebSocket 指南,覆盖呼入和外呼。 |
| 开发者最省事 | OpenAI Realtime + Twilio Media Streams | 只需一个 WebSocket 转发:Twilio 发来 mu-law 音频,OpenAI 回传音频。下文代码约 200 行(含工具)。 |
| 服务器上不转发音频 | OpenAI Realtime SIP | 把 SIP trunk 指向 OpenAI,用 webhook 接听电话,再挂一个 WebSocket 处理工具和监控。 |
| 文档可查的最低每分钟成本 | 基于 gpt-realtime-2.1-mini 自建(呼入每分钟下限 $0.028,我们的算术) | 托管平台自己的页面显示 $0.048(LiveKit Cloud 估算)到 $0.129(Vapi 示例)。自建下限没有计入上下文重复计费,请以自己的通话实测为准。 |
AI 电话是如何工作的
一通电话以电话网络连接的形式到达,由 Twilio 这样的运营商终结。软件通过两种方式接入这条连接。 通过 WebSocket,Twilio 把通话音频以 base64 的 mu-law 帧转发给你的服务器,并播放你回传的任何音频。 通过 SIP,运营商的 trunk 把通话投递到某个 SIP 端点(OpenAI、LiveKit 或某个平台),由它当作一个会话处理。 无论哪种方式,模型听到的都是 8 kHz 的电话音频,这也是直接接受 mu-law 的语音到语音模型用起来很方便的原因:不用转码。

经典流水线串联三个服务:语音转文字、语言模型、文字转语音。它允许混用不同厂商,我们的 语音转文字指南(英文)和 文字转语音指南(英文) 覆盖了各个环节。像 gpt-realtime 这样的语音到语音模型把整条链压缩成一个 WebSocket, 所以第 3 条路线是构建最短的。我们详细构建这一条,再说明另外两条有何不同。
构建:OpenAI Realtime + Twilio Media Streams
下面的服务器接听 Twilio 来电,播报一段告知语,打开双向 Media Stream,并把音频转发给 OpenAI 的 Realtime API。 它是 Twilio 官方 Node 教程,加上构建一个能预约的电话 Agent 所需的改动。每处改动都在注释里标为 ADAPTED。 你需要 Node 18 或更高版本(这是我们的假设,教程没有说明)、一个有 Realtime 权限的 OpenAI API 密钥,以及一个 Twilio 账号。
同一架构的第三方演示(Twilio 加 OpenAI Realtime,用 NestJS 而不是 Fastify)。并非 OpenAI 或 Twilio 出品。
第 1 步:创建项目并安装依赖
mkdir ai-phone-agent && cd ai-phone-agent
npm init -y; npm pkg set type="module"
npm install fastify ws dotenv @fastify/formbody @fastify/websocket twilio
fastify 提供 webhook 和 WebSocket 路由,ws 是连接 OpenAI 的客户端,twilio 只在后面的外呼和录音脚本里用到。
第 2 步:添加环境变量
OPENAI_API_KEY="sk-..."
# only needed for outbound calls and recording
TWILIO_ACCOUNT_SID="AC..."
TWILIO_API_KEY="SK..."
TWILIO_API_SECRET="..."
TWILIO_NUMBER="+1..."
PUBLIC_HOST="your-tunnel-host.example"   # no scheme, no trailing slash
把它们放进 .env 文件,并且不要提交到版本控制。只接听呼入电话时,只需要 OPENAI_API_KEY。
第 3 步:编写服务器
保存为 index.js。有四个关键部分:/incoming-call 路由返回启动双向流的 TwiML,session.update 消息设置 mu-law 音频和服务端语音活动检测,media 处理函数双向转发音频,response.done 处理函数运行你的工具。
// index.js  (Fastify + ws). Based on Twilio's "Build an AI Voice Assistant with
// Twilio Voice, OpenAI's Realtime API, and Node.js" tutorial.
// ADAPTED: model name, tools, greeting, barge-in (clear), string concatenation
// instead of template literals, and the booking handlers are ours.
import Fastify from 'fastify';
import WebSocket from 'ws';
import dotenv from 'dotenv';
import fastifyFormBody from '@fastify/formbody';
import fastifyWs from '@fastify/websocket';

dotenv.config();
const { OPENAI_API_KEY } = process.env;
if (!OPENAI_API_KEY) {
    console.error('Missing OPENAI_API_KEY in .env');
    process.exit(1);
}

const MODEL = 'gpt-realtime-2.1';   // ADAPTED (the Twilio tutorial uses 'gpt-realtime')
const VOICE = 'alloy';
const PORT = process.env.PORT || 5050;
const SYSTEM_MESSAGE =
    'You are the phone assistant for Example Dental. Keep answers to one or two short sentences. ' +
    'You can check open appointment slots and book one. Always read back the date, time and name ' +
    'before you call book_appointment. If you are unsure, offer to have a human call back.';

// ADAPTED: toy in-memory calendar, replace with your real scheduling API
const SLOTS = {
    '2026-11-16': ['09:00', '10:30', '14:00'],
    '2026-11-17': ['11:00', '15:30'],
};
const bookings = [];

const TOOLS = [
    {
        type: 'function',
        name: 'check_availability',
        description: 'List open appointment times for a date (YYYY-MM-DD).',
        parameters: {
            type: 'object',
            properties: { date: { type: 'string', description: 'Date as YYYY-MM-DD' } },
            required: ['date'],
        },
    },
    {
        type: 'function',
        name: 'book_appointment',
        description: 'Book one open slot after the caller has confirmed date, time and name.',
        parameters: {
            type: 'object',
            properties: {
                date: { type: 'string', description: 'Date as YYYY-MM-DD' },
                time: { type: 'string', description: 'Time as HH:MM, 24-hour' },
                name: { type: 'string', description: 'Caller full name' },
            },
            required: ['date', 'time', 'name'],
        },
    },
];

function runTool(name, args) {
    if (name === 'check_availability') {
        return { date: args.date, open: SLOTS[args.date] || [] };
    }
    if (name === 'book_appointment') {
        const open = SLOTS[args.date] || [];
        if (!open.includes(args.time)) return { ok: false, error: 'That slot is not available.' };
        SLOTS[args.date] = open.filter((t) => t !== args.time);
        bookings.push({ date: args.date, time: args.time, name: args.name });
        return { ok: true, confirmation: 'BK-' + bookings.length };
    }
    return { ok: false, error: 'Unknown tool ' + name };
}

const LOG_EVENT_TYPES = ['error', 'response.done', 'input_audio_buffer.speech_started', 'session.updated'];

const fastify = Fastify();
fastify.register(fastifyFormBody);
fastify.register(fastifyWs);

fastify.get('/', async (request, reply) => {
    reply.send({ message: 'Twilio Media Stream Server is running!' });
});

// Twilio calls this when the number rings. TwiML: disclose, then open a bidirectional stream.
fastify.all('/incoming-call', async (request, reply) => {
    const twiml =
        '<?xml version="1.0" encoding="UTF-8"?>' +
        '<Response>' +
        '<Say>This call is handled by an AI assistant and may be recorded.</Say>' +   // ADAPTED
        '<Connect><Stream url="wss://' + request.headers.host + '/media-stream" /></Connect>' +
        '</Response>';
    reply.type('text/xml').send(twiml);
});

fastify.register(async (fastify) => {
    fastify.get('/media-stream', { websocket: true }, (connection, req) => {
        console.log('Twilio connected');
        let streamSid = null;
        let greeted = false;

        const openAiWs = new WebSocket('wss://api.openai.com/v1/realtime?model=' + MODEL, {
            headers: { Authorization: 'Bearer ' + OPENAI_API_KEY },
        });

        const sendSessionUpdate = () => {
            openAiWs.send(JSON.stringify({
                type: 'session.update',
                session: {
                    type: 'realtime',
                    model: MODEL,
                    output_modalities: ['audio'],
                    audio: {
                        input: { format: { type: 'audio/pcmu' }, turn_detection: { type: 'server_vad' } },
                        output: { format: { type: 'audio/pcmu' }, voice: VOICE },
                    },
                    instructions: SYSTEM_MESSAGE,
                    tools: TOOLS,            // ADAPTED
                    tool_choice: 'auto',     // ADAPTED
                },
            }));
        };

        openAiWs.on('open', () => setTimeout(sendSessionUpdate, 250));

        openAiWs.on('message', (data) => {
            try {
                const evt = JSON.parse(data);
                if (LOG_EVENT_TYPES.includes(evt.type)) console.log('OpenAI event:', evt.type);

                // ADAPTED: speak first, once, after the session config is applied
                if (evt.type === 'session.updated' && !greeted) {
                    greeted = true;
                    openAiWs.send(JSON.stringify({
                        type: 'response.create',
                        response: { instructions: 'Greet the caller in one sentence and ask how you can help.' },
                    }));
                }

                // model audio -> caller
                if (evt.type === 'response.output_audio.delta' && evt.delta) {
                    connection.send(JSON.stringify({
                        event: 'media',
                        streamSid: streamSid,
                        media: { payload: evt.delta },
                    }));
                }

                // ADAPTED barge-in: caller started talking, flush audio Twilio has buffered
                if (evt.type === 'input_audio_buffer.speech_started' && streamSid) {
                    connection.send(JSON.stringify({ event: 'clear', streamSid: streamSid }));
                }

                // ADAPTED function calling, following OpenAI's Realtime function-calling flow
                if (evt.type === 'response.done') {
                    const output = (evt.response && evt.response.output) || [];
                    for (const item of output) {
                        if (item.type !== 'function_call') continue;
                        const args = JSON.parse(item.arguments || '{}');
                        const result = runTool(item.name, args);
                        openAiWs.send(JSON.stringify({
                            type: 'conversation.item.create',
                            item: {
                                type: 'function_call_output',
                                call_id: item.call_id,
                                output: JSON.stringify(result),
                            },
                        }));
                        openAiWs.send(JSON.stringify({ type: 'response.create' }));
                    }
                }
            } catch (error) {
                console.error('Error processing OpenAI message:', error);
            }
        });

        // caller audio -> model
        connection.on('message', (message) => {
            try {
                const data = JSON.parse(message);
                if (data.event === 'start') {
                    streamSid = data.start.streamSid;
                    console.log('Stream started', streamSid);
                } else if (data.event === 'media') {
                    if (openAiWs.readyState === WebSocket.OPEN) {
                        openAiWs.send(JSON.stringify({ type: 'input_audio_buffer.append', audio: data.media.payload }));
                    }
                }
            } catch (error) {
                console.error('Error parsing Twilio message:', error);
            }
        });

        connection.on('close', () => {
            if (openAiWs.readyState === WebSocket.OPEN) openAiWs.close();
            console.log('Twilio disconnected');
        });
        openAiWs.on('error', (error) => console.error('OpenAI WebSocket error:', error));
    });
});

fastify.listen({ port: PORT, host: '0.0.0.0' }, (err) => {
    if (err) {
        console.error(err);
        process.exit(1);
    }
    console.log('Server is listening on port ' + PORT);
});
有两个细节值得了解。第一,输入输出都用 audio/pcmu,意味着 Twilio 的 mu-law 帧原样送到 OpenAI 再原样回来, 而且 media.payload 必须是不带文件头字节的原始音频;Twilio 提醒,带文件头字节会导致流播放异常。 第二,Twilio 的 clear 消息会清空 Twilio 已缓冲的全部音频,这就是来电者打断时 Agent 能立刻停下的原因。 基础教程没有包含打断处理,所以 input_audio_buffer.speech_started 的处理是我们加的。 它没有告诉 OpenAI 来电者实际听到了多少,所以模型可能以为自己说得比来电者听到的更多; OpenAI 文档里有专门的 truncate 事件来处理这一点,为保持示例简短,我们没有加入。
第 4 步:运行并对外暴露
node index.js
# 在第二个终端里,用任意隧道暴露 5050 端口,例如:
ngrok http 5050
隧道会给你一个公网 https:// 主机。Twilio 的 webhook 会请求它, TwiML 则根据请求的 host 头构造 wss:// 地址,让流连到同一台服务器。
电话号码配置
- 购买号码。在 Twilio 控制台购买一个支持语音的本地号码。Twilio 标价本地号码每月 $1.15(2026 年 11 月 11 日)。
- 把号码指向你的服务器。打开该号码,找到语音配置部分,把 A call comes in 设为 webhook,地址为你的隧道 URL 加
/incoming-call,方法为 HTTP POST。 - 打电话测试。用你的手机拨打这个号码。你应该先听到告知语,再听到问候,Node 控制台应记录
Stream started和 OpenAI 事件。 - 隧道重启后重新粘贴 URL。免费隧道通常会更换域名,所以每次都要更新 webhook。
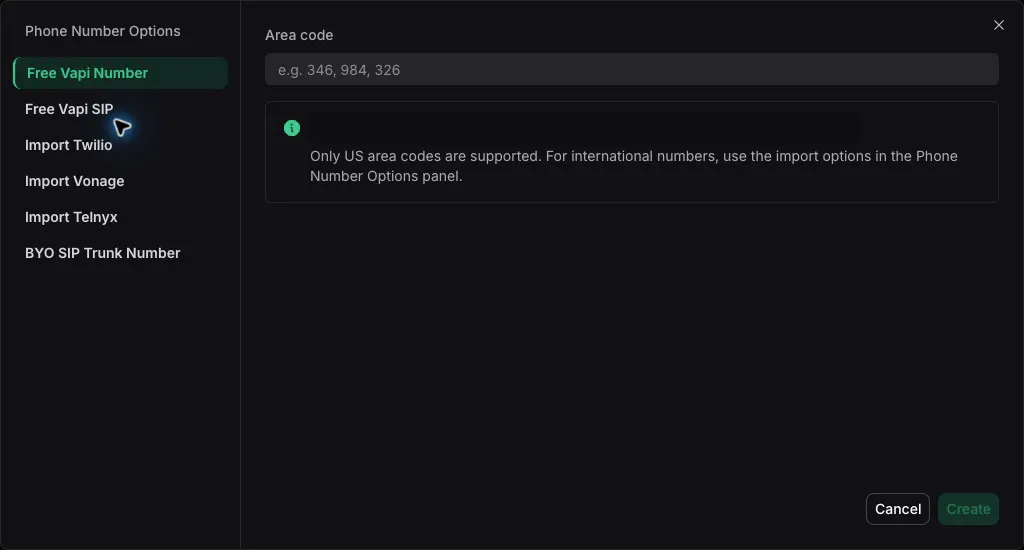
在托管平台上这一步更短。Vapi 让你选一个区号就能创建免费美国号码,不过免费号码只支持呼入; 外呼则要导入 Twilio、Telnyx 或 DIDWW 号码。
SIP 替代方案:不需要转发服务器
如果你不想自己转发音频,OpenAI 可以直接接收 SIP 呼叫。你把服务商的 trunk(文档用 Twilio 做示例)指向 OpenAI, 来电时收到 webhook,再通过 API 调用接听。音频此后直接在运营商和 OpenAI 之间流动, 你的代码只通过挂在通话上的 WebSocket 处理工具和监控。
# 1) platform.openai.com > Project > Webhooks: create a webhook for incoming calls.
# 2) Point your SIP trunk at: sip:[email protected];transport=tls
#    (EU data residency: sip-eu.api.openai.com, India: sip-in.api.openai.com)
# 3) OpenAI POSTs a realtime.call.incoming event to your webhook with data.call_id.
# 4) Accept it (this is the curl from OpenAI's Realtime SIP guide):
curl -X POST "https://api.openai.com/v1/realtime/calls/$CALL_ID/accept" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
        "type": "realtime",
        "model": "gpt-realtime-2.1",
        "instructions": "You are Alex, a friendly concierge for Example Corp."
      }'
# 5) Attach to the live call for tools and monitoring:
#    wss://api.openai.com/v1/realtime?call_id=$CALL_ID
函数调用:预约
只会聊天的电话 Agent 只是玩具。有用的 Agent 会读日历、创建工单或查订单。在 OpenAI Realtime 里, 你在会话中声明函数,模型在对话中途请求调用,你再回传结果。上面的服务器已经实现了两个工具:check_availability 和 book_appointment。事件流程如下:
// 1) You declare tools in session.update (see TOOLS above).
// 2) Caller: "Can I come in Monday the 16th?"  -> model emits, inside response.done:
{
  "type": "response.done",
  "response": {
    "output": [{
      "type": "function_call",
      "name": "check_availability",
      "call_id": "call_abc123",
      "arguments": "{\"date\":\"2026-11-16\"}"
    }]
  }
}
// 3) You run the tool and answer with a function_call_output item, then ask for a response:
{ "type": "conversation.item.create",
  "item": { "type": "function_call_output", "call_id": "call_abc123",
            "output": "{\"date\":\"2026-11-16\",\"open\":[\"09:00\",\"10:30\",\"14:00\"]}" } }
{ "type": "response.create" }
// 4) The model speaks the options to the caller.
// Shapes follow OpenAI's Realtime conversations guide; ids and values are illustrative.
电话场景下的设计原则:让提示词要求在调用预约之前复述日期、时间和姓名;返回模型能直接说出口的简短结果; 时段已被占用时返回一句简单的错误文本,让模型改推荐别的时段;每个工具都要快,因为工具运行时来电者听到的是沉默。 对于涉及资金或修改记录的操作,要在你自己的代码里加确认步骤,不要只靠提示词。
托管平台用的是同样的思路,只是通过 webhook。在 Vapi 上,你的服务器收到工具调用后必须返回 HTTP 200, 并带一个以 toolCallId 为键的 results 数组,成功输出放在 result 下的扁平字符串里, 失败信息放在 error 下;Vapi 文档说任何非 200 状态码都会被完全忽略。在 Retell 上,自定义函数有 URL、方法和参数, 超时可在 1 到 600 秒之间配置(默认 120)。如果 Agent 需要更宽的工具面, MCP 服务器清单(英文) 展示了模型侧工具层能触达什么。
外呼与录音
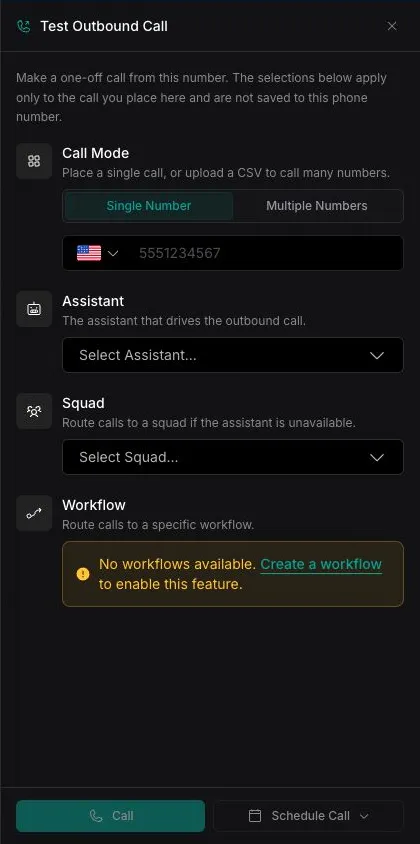
外呼用的是同一台服务器。不是等待来电,而是让 Twilio 创建一通呼叫,其 TwiML 会打开流。 只对已经同意的号码运行(见合规一节)。
// dial.js  -  place an outbound call that opens the same media stream
// Based on Twilio's Create Call example (API key auth); ADAPTED to inline TwiML with a Stream.
// Run: node dial.js +15551234567
import 'dotenv/config';
import twilio from 'twilio';

const client = twilio(process.env.TWILIO_API_KEY, process.env.TWILIO_API_SECRET, {
    accountSid: process.env.TWILIO_ACCOUNT_SID,
});

const twiml =
    '<Response>' +
    '<Say>Hello, this is an automated assistant from Example Dental calling about your appointment. This call may be recorded.</Say>' +
    '<Connect><Stream url="wss://' + process.env.PUBLIC_HOST + '/media-stream" /></Connect>' +
    '</Response>';

const call = await client.calls.create({
    from: process.env.TWILIO_NUMBER,
    to: process.argv[2],
    twiml: twiml,
});
console.log('Call SID:', call.sid);
Twilio 也可以通过 Recordings API 对进行中的通话录音。双声道录音把来电者和 Agent 放在不同声道,便于质量复盘。
// record.js  -  start a dual-channel recording on a live call
// From Twilio's Recordings API docs (example SID and URL are placeholders).
const recording = await client
    .calls('CAXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXXX')
    .recordings.create({
        recordingChannels: 'dual',
        recordingStatusCallback: 'https://myapp.com/recording-events',
        recordingStatusCallbackEvent: ['in-progress completed'],
    });
Twilio 自己的文档要求开发者遵守录音同意方面的法律并寻求法律顾问意见,所以请在问候语里告知录音, 并让这句告知保存在音频里。示例中的问候语已经这样做了。
另外两条路线简述
路线 1:Vapi 或 Retell(无代码)
两者都提供控制台来设置提示词、声音和工具,再绑定号码。Vapi 的快速入门也有 TypeScript SDK; 下面的片段是它创建助手的调用,除注释外未作改动。
// Vapi: create an assistant (from Vapi's phone quickstart; bun add @vapi-ai/server-sdk)
import { VapiClient } from '@vapi-ai/server-sdk';

const vapi = new VapiClient({ token: process.env.VAPI_API_KEY! });

const assistant = await vapi.assistants.create({
  name: 'Customer Support Assistant',
  model: {
    provider: 'openai',
    model: 'gpt-6-luna',
    reasoningEffort: 'none',
    messages: [{ role: 'system', content: 'You are Alex, a customer service voice assistant for TechSolutions.' }]
  },
  voice: { provider: '11labs', voiceId: 'cgSgspJ2msm6clMCkdW9' },
  firstMessage: 'Hi there, this is Alex from TechSolutions customer support. How can I help you today?'
});

// Your tool server must answer HTTP 200 with this shape, even on failure:
// { "results": [ { "toolCallId": "<id from Vapi>", "result": "<flat string>" } ] }
// On failure use "error" instead of "result".
代价是价格透明度。Vapi 每分钟收 $0.05 托管费,再加你选的各家厂商,Retell 的定价页列出 $0.07 到 $0.31 的区间。 两个页面都没有给出延迟实测数据,所以承诺之前请先用自己的通话测试。
路线 2:LiveKit Agents 或 Pipecat
LiveKit 的电话文档描述的是:来电者通过 trunk 和 dispatch rule 作为 SIP 参与者加入房间,房间里有 Agent worker。 Pipecat 的 Twilio 指南使用一个 TwiML Bin,打开到你机器人的 WebSocket,机器人可以在隧道后本地运行,或部署在 Pipecat Cloud:
# Pipecat + Twilio dial-in, commands from Pipecat's Twilio WebSocket guide
ngrok http 7860          # expose the local bot server
uv sync                  # install dependencies
uv run bot.py -t twilio  # run the bot with the Twilio transport
想要在一个产品里同时拥有媒体服务器和一流 SIP 栈,就选 LiveKit;想要可替换服务的 Python 流水线,就选 Pipecat。 上面提到的对比文章讲了其中的取舍。
Stream 出品的 OpenAI Realtime API 电话呼叫快速入门,是第 3 条路线的另一个第三方讲解。
延迟优化建议
本文没有做延迟基准测试,我们查看的厂商页面也没有公布端到端数字。下面这些建议来自各组件的工作方式, 请当作需要自己测量的做法,而不是保证有效的提升。
- 跳过流水线。语音到语音模型省掉了独立 STT、LLM、TTS 流水线所需的两次网络跳转。
- 全程保持 mu-law。示例两个方向都设为
audio/pcmu,不做重采样或重新编码。 - 干净地打断。
speech_started一触发就向 Twilio 发送clear,否则来电者会听到过期音频。 - 让转发服务靠近运营商和模型。部署在靠近你的 Twilio 边缘节点和 OpenAI 端点的区域;数据驻留有要求时使用 OpenAI 的区域 SIP 主机。
- 能去掉转发就去掉。OpenAI SIP 让运营商直接和模型通话。
- 工具要快,提示词要短。慢的数据库调用就是死寂。能缓存的缓存,长查询改成一句「我帮您查一下」。
- 提示词要求简短。每轮一两句短话既更快也更便宜,因为 gpt-realtime-2.1 的输出音频价格是输入的两倍。
- 把服务器放在 CPU 稳定的机器上。连到笔记本的隧道只适合测试;生产环境用小型 VPS 或容器。我们的 GPU 云指南(英文)只在你自托管模型时才有用。
每分钟成本
电话成本分两层:运营商和模型。下面所有费率都读取自 2026 年 11 月 11 日的厂商页面;做预算前请重新计算。
| 项目 | 费率 | 来源 |
|---|---|---|
| Twilio 呼入,本地号码 | 每分钟 $0.0085 | Twilio 语音定价,美国 |
| Twilio 外呼,美国和加拿大 | 每分钟 $0.0140 | Twilio 语音定价,美国 |
| Twilio Media Streams | 每分钟 $0.0044 | Twilio 语音定价,智能服务 |
| Twilio 本地号码租金 | 每月 $1.15 | Twilio 语音定价,美国 |
| gpt-realtime-2.1 音频 token | 输入 $32.00、输出 $64.00 / 百万 | OpenAI API 定价 |
| gpt-realtime-2.1-mini 音频 token | 输入 $10.00、输出 $20.00 / 百万 | OpenAI API 定价 |
| gpt-live-1 语音会话 | 每分钟 $0.05,按秒计费 | OpenAI API 定价 |
| 用户音频 token | 每 100 毫秒 1 个 token | OpenAI 语音延迟与成本指南 |
| 助手音频 token | 每 50 毫秒 1 个 token | OpenAI 语音延迟与成本指南 |
我们的模型:以一分钟通话为例,来电者说 30 秒,Agent 说 30 秒。音频 token 是用户每 100 毫秒 1 个、 助手每 50 毫秒 1 个,所以是 300 个输入和 600 个输出 token。再加上 Twilio 的语音费率,以及 Media Streams 的 $0.0044。 最后一列假设每月 1,000 分钟、一个 $1.15 的号码。
| 场景 | OpenAI 音频每分钟 | Twilio 每分钟 | 合计每分钟 | 每月 1,000 分钟 |
|---|---|---|---|---|
| gpt-realtime-2.1 + Twilio,呼入 | 300 x $32 + 600 x $64,每百万 = $0.0480 | $0.0129 | $0.0609 | $62.05 |
| gpt-realtime-2.1 + Twilio,外呼 | $0.0480 | $0.0184 | $0.0664 | $67.55 |
| gpt-realtime-2.1-mini + Twilio,呼入 | 300 x $10 + 600 x $20,每百万 = $0.0150 | $0.0129 | $0.0279 | $29.05 |
| gpt-realtime-2.1-mini + Twilio,外呼 | $0.0150 | $0.0184 | $0.0334 | $34.55 |
这些都是下限,原因有两个。如果把来电者整整 60 秒(包括静音)都算作输入,gpt-realtime-2.1 的数字会从 $0.0480 升到 $0.0576(mini 从 $0.0150 升到 $0.0180)。而且模型每次回答都会重新读取对话,所以长通话的成本高于这个算术; OpenAI 的成本指南讲了缓存输入和上下文。请在真实通话里记录 response.done 中的用量字段,用你自己的数字替换我们的假设。 OpenAI 还单独列出了 GPT-Live 语音产品,每分钟 $0.05、按秒计费,后端成本另计,这是另一种计价模型,不能和 token 计费直接比较。
托管路线的公布数字,取自各厂商的定价页:
| 平台 | 公布的每分钟价格 | 页面显示的构成 |
|---|---|---|
| Vapi(定价页示例) | 每分钟 $0.082 到 $0.129 | $0.05 托管费 + Deepgram $0.0095 到 $0.0099 + OpenAI $0.0077 到 $0.0452 + ElevenLabs $0.0146 到 $0.0238;Vapi 电话传输费显示为 $0 |
| Retell(示例) | 每分钟 $0.11 | LLM $0.04 + Retell 语音基础设施 $0.055 + TTS $0.015 + 电话 $0.00;页面区间 $0.07 到 $0.31 |
| LiveKit Cloud(计算器默认值) | 每分钟 $0.0479 | Agent 会话 $0.0100、电话 $0.0100、LLM $0.0014、STT $0.0075,合计 $0.0479(剩余 $0.0190 为 TTS,是我们用减法得出);Build 档含一个免费电话号码,Ship 档起价每月 $50 |
| Pipecat Cloud(仅托管) | 起价每分钟 $0.01 | Agent 托管档位每分钟 $0.01、$0.02、$0.03;STT、LLM、TTS 和电话另计 |
结论:自建路线在纸面上可以低于托管平台,但你要为工程时间、监控和通话质量调优付出代价。 托管平台把编排、控制台和通话日志打包在一起。选哪个,取决于这些你本来要自己写多少。
合规说明
以下不构成法律意见。这只是对公开来源的总结,帮助你知道该向律师问哪些问题。各国各州规则不同, 电话营销、催收和医疗还有各自的额外要求。
| 情形 | 来源怎么说 | 实际做法 |
|---|---|---|
| 用 AI 语音外呼消费者 | FCC 24-17(2024 年 2 月):TCPA 的「人工或预录语音」涵盖生成人类语音的 AI,因此除紧急情况或豁免外,需要被叫方事先明确同意。 | 按号码收集并保存同意记录,尊重退订,并请律师确认你适用的豁免(如有)。 |
| 录音 | Twilio 表示录音必须遵守同意法规,例如加州隐私侵犯法及其他地区的类似法律,并建议咨询法律顾问。 | 在通话开头告知录音,并让这句告知保留在录音里。 |
| 呼入你的号码 | FCC 的裁定针对你主动发起的呼叫。录音和隐私规则对呼入电话依然适用。 | 把录音告知和数据保留当作必做项,并就你所在的州咨询律师。 |
| 告知来电者对方是 AI | 本文没有研究各州的 AI 披露法规。 | 无论如何都要在开场白里说明;这也能管理来电者的预期。 |
FCC 这项裁定范围很窄但很重要。2024 年 2 月,委员会确认生成人类语音的 AI 技术属于《电话消费者保护法》(TCPA)下的「人工或预录语音」。 裁定文本还重申了一条规则:此类消息必须在开头说明发起呼叫的责任企业的身份,这是外呼话术应以「谁在打电话」开头的另一个理由。 同意、来电身份和退订处理应当写进设计,而不是事后补救。
我们的实用默认做法:第一句话就说明来电者是 AI 且通话可能被录音,按号码保存同意记录,对「停止」立即响应, 避免在允许时段之外拨打(请查你所在辖区),转录文本只保留必要的时间,并且在被问到时绝不让 Agent 声称自己是真人。 对于与电话 Agent 并行的网页浏览或数据收集类 Agent,我们的 浏览器基础设施指南(英文)覆盖了网页那一侧。
故障排查
| 现象 | 可能原因 | 解决办法 |
|---|---|---|
| 来电者听到杂音或乱码 | 音频格式不匹配,或负载里带了文件头字节 | OpenAI 输入输出两个方向都用 audio/pcmu,发送原始 mu-law 8000 Hz 的 base64。Twilio 提醒:media.payload 里带文件头字节会导致流播放异常。 |
| 来电者什么也听不到 | streamSid 仍为 null,或 WebSocket 地址不可达 | 记录 start 事件,确认 wss:// 主机是你的公网隧道,并且 TwiML 里的 Stream URL 以 /media-stream 结尾。 |
| Agent 抢着说话 | 来电者开口后,缓冲音频仍在播放 | 收到 input_audio_buffer.speech_started 时向 Twilio 发送 clear 消息,如上面的代码所示。 |
| 工具没有触发 | 工具没写进 session.update,或忽略了 function_call 项 | 确认 tools 在会话配置里,并在 response.done 里扫描 type 为 function_call 的项。 |
| 通话接通几秒后掉线 | OpenAI WebSocket 报错(密钥、模型权限或限流) | 记录 OpenAI 的 error 事件类型;教程的 LOG_EVENT_TYPES 列表包含 error。 |
| webhook 到不了你的电脑 | 隧道重启后,Twilio webhook 仍指向旧地址 | 每次重启后,把新的隧道 URL 重新粘贴到号码的 A CALL COMES IN 字段(免费隧道会更换域名)。 |
如果你想加入记忆,让 Agent 记住回访的来电者,请看我们的 向量数据库指南; 如果想给自己的编程 Agent 做语音界面而不是电话线路,请看 Antigravity 语音模式指南(英文)。
评估方法
我们在 2026 年 11 月 11 日阅读了来源列表中的厂商文档和定价页,并把服务器代码改编自 Twilio 官方 Node 教程和 OpenAI 的 Realtime 指南。 我们用 Node 对代码做了语法检查,但本文没有用它拨打真实电话,所以请把示例当作通过语法检查的起点,在信任它之前先打一通试用电话。 成本数字是在明示假设下对标价做的算术,不是账单。我们没有测量延迟、准确率或通话质量,厂商页面没有公布数字的地方我们都明确说明。 第三方视频只作为演示链接,不作为正文任何论断的证据。
常见问题
2026 年构建 AI 电话 Agent 最简单的方法是什么?
用托管平台。Vapi 的快速入门会创建一个助手、分配一个免费美国号码,几分钟内就能打电话测试,Retell 也有类似的控制台流程。代价是按分钟收取的平台费:Vapi 定价示例合计每分钟 $0.082 到 $0.129,Retell 的示例为每分钟 $0.11(截至 2026 年 11 月 11 日)。如果你能写一个小服务器,OpenAI Realtime 配合 Twilio Media Streams 是代码量最短的路线。
能直接把 OpenAI Realtime API 接到电话号码上吗?
可以,有两种方式。Twilio Media Streams:你的服务器用 TwiML 响应 Twilio 的 webhook,打开双向 WebSocket,然后在 Twilio 和 OpenAI 之间转发 mu-law 音频。或者 SIP:把 SIP trunk 指向 sip:[email protected],收到 realtime.call.incoming webhook 后用 call_id 接听,再挂一个 WebSocket 监控通话并运行工具。OpenAI 的 SIP 指南把 Twilio 列为示例中继服务商。
一通 AI 电话每分钟要多少钱?
按 2026 年 11 月 11 日的标价:Twilio 美国本地号码呼入每分钟 $0.0085、外呼每分钟 $0.0140,再加 Media Streams 每分钟 $0.0044,合计呼入 $0.0129、外呼 $0.0184。再加 OpenAI 音频 token:一分钟里来电者说 30 秒、Agent 说 30 秒,约 300 个输入和 600 个输出音频 token,gpt-realtime-2.1 约 $0.048,gpt-realtime-2.1-mini 约 $0.015。也就是呼入每分钟下限约 $0.061 或 $0.028。实际账单会更高,因为每次回答都会重新读取对话上下文,请在自己的通话里读取 response.done 中的用量。
运行 AI 电话 Agent 一定需要服务器吗?
只有代码路线需要。Vapi 和 Retell 托管整条流水线,只在调用工具时请求你的 webhook。用 OpenAI Realtime 加 Twilio Media Streams 时,你要运行一个小型 WebSocket 转发服务,它需要公网地址(测试用隧道即可,生产用 VPS 或容器)。用 LiveKit 或 Pipecat 时,你运行一个 Agent worker,或部署到它们的云服务。
用 AI 语音给人打电话合法吗?
以下不构成法律意见。FCC 在 2024 年 2 月的声明性裁定(FCC 24-17)中确认,TCPA 对「人工或预录语音」的限制涵盖生成人类语音的现有 AI 技术,因此使用这类技术的呼叫需要被叫方事先明确同意,除非属于紧急目的或有豁免。请保存书面同意记录、尊重退订,并让律师审核任何外呼活动。
必须告知来电者通话被录音,或对方是 AI 吗?
录音同意取决于通话双方所在地的法律。Twilio 的录音文档要求遵守加州隐私侵犯法等同意类法规,并建议咨询法律顾问。本文没有研究各州的 AI 披露法规,但在通话第一句话里同时说明这两点是最稳妥的默认做法,而且没有成本。
怎样让 Agent 预约或查询信息?
把函数声明为工具。在 OpenAI Realtime 里,把函数加进 session.tools,监听 response.done 里 type 为 function_call 的输出项,用其 arguments 运行你的代码,再用相同的 call_id 回传一个 function_call_output 项,最后发送 response.create 让模型把结果说出来。在 Vapi 里,你的服务器返回 HTTP 200,并带一个以 toolCallId 为键的 results 数组。在 Retell 里,你配置自定义函数的 URL、方法、参数以及 1 到 600 秒的超时。
怎样降低电话 Agent 的延迟?
用语音到语音模型,避免音频在独立的 STT、LLM、TTS 服务间多次跳转;全程保持 mu-law 8 kHz,不做转码;把转发服务部署在靠近 Twilio 和 OpenAI 的地方;来电者一打断就发送 clear 消息;让工具调用快、提示词短;并把稳定的指令和工具定义放在提示词最前面,以便适用缓存输入价格。我们没有自己测量延迟,本文中的任何厂商数字都不是我们的实测。
该选 LiveKit Agents 还是 Pipecat?
两者都是实时语音的开源框架。LiveKit 自带媒体服务器和一流的 SIP 栈(trunk、dispatch rule、SIP 参与者),并出售托管 Agent 和电话号码的云服务。Pipecat 是 Python 流水线框架,带 Twilio WebSocket 传输,并有 Pipecat Cloud 托管。我们的对比文章有更深入的分析。
本指南的价格和代码有多新?
价格取自 2026 年 11 月 11 日抓取的 Twilio、OpenAI、Vapi、Retell、LiveKit 和 Pipecat 页面。服务器代码改编自 Twilio 官方 Node 教程和 OpenAI 的 Realtime 文档,我们做的每处改动都标有 ADAPTED。我们做了语法检查,但本文没有用真实电话号码跑过,请在依赖它之前先用试用号码测试。
来源
除特别说明外,所有页面均抓取于 2026 年 11 月 11 日。
- Twilio:用 Twilio Voice、OpenAI Realtime API 和 Node.js 构建 AI 语音助手
- OpenAI:Realtime API 与 SIP
- OpenAI:Realtime 对话(函数调用事件)以及语音延迟与成本
- OpenAI:API 定价(gpt-realtime-2.1、gpt-realtime-2.1-mini、gpt-live-1)
- Twilio:语音定价,美国
- Twilio:Media Streams和TwiML Stream
- Twilio:Call 资源(创建呼叫)和Recording 资源
- FCC:确认 TCPA 适用于生成人类语音的 AI 技术和FCC 24-17 声明性裁定全文
- Vapi:电话快速入门、自定义工具和定价
- Retell:自定义函数和定价
- LiveKit:电话和定价
- Pipecat:Twilio WebSocket 电话指南和Pipecat Cloud 定价
- OpenAI Devs 在 X 上:Realtime API 结束测试、gpt-realtime 与 SIP(2025 年 8 月 28 日)
- YouTube:Build an AI Phone Agent in 20 Minutes和Stream:OpenAI Realtime API 电话呼叫快速入门(第三方演示)