简短回答
Muse Wonder 是 Meta 首个由 Meta 自己定位在前沿的模型家族,其发布在价格和可用性上异常具体。标准模型 Muse Wonder 今天即可通过 Meta Model API 调用,价格为每百万输入 token 4.00 美元、每百万输出 token 20.00 美元。更大的模型 Muse Wonder Full 完全不按 token 出售:它包含在每月 50 美元和 200 美元的 Muse Code 订阅之中。Meta 自己的成绩单显示,Muse 模型在 14 行基准中领先 7 行,落后于 Claude Opus 5.5 共 6 行,其中包括 Artificial Analysis 智能指数(Opus 58、Wonder Full 56、Wonder 52)。
本文基于一手来源:马克·扎克伯格的发布帖串、Meta 研究博客文章、模型卡、超级智能扩展框架(Superintelligence Scaling Framework)、Meta for Developers 模型页面,外加一个独立来源 Artificial Analysis。所有数字均于 2026 年 10 月 12 日核对。凡来自 Meta 的数字都标注为厂商自报,下文没有任何一项是本站的独立复现。
发布帖串
扎克伯格的公告于 10 月 12 日 16:55 UTC 以五条帖子的帖串发出。首条是覆盖在一张基准表之上的一句话:“Introducing Muse Wonder, our new family of frontier models with state of the art performance for personal and professional agentic work.”(介绍 Muse Wonder,我们面向个人与专业智能体工作、性能达到业界领先水平的新一代前沿模型家族。)抓取时该帖约有 11,000 个赞和 557,000 次浏览。
Introducing Muse Wonder, our new family of frontier models with state of the art performance for personal and professional agentic work.
— @finkd 2026 年 10 月 12 日
第二条帖子附有视频,交代了来龙去脉:距离启动 Meta Superintelligence Labs“刚过一年”,Muse Spark“是我们的第一个模型家族”,而 Muse Wonder 是“规模大得多、也更先进的一类模型,让我们来到前沿”。它还点明了这一对:Muse Wonder“用于快速的前沿性能”,Muse Wonder Full“是模型的完整版本”。
It’s been just over a year since we started Meta Superintelligence Labs. Muse Spark was our first family of models, and now Muse Wonder is a much larger and more advanced class of models that brings us to the frontier.
— @finkd 2026 年 10 月 12 日
其余帖子谈分发与定位。一条说你可以“今天就订阅,用 Muse Wonder 驱动你的 Muse”,并且 Meta 会“努力让所有人逐步用上这一水平的智能”。另一条说它也可通过 Muse Code 和 Meta Model API 使用,并“即将进入其他产品”,附有博客链接。最后一条称 Muse Wonder 是“迈向为所有人提供个人超级智能的重大飞跃”。@AIatMeta 账号在七分钟后发出了自己的帖串,Alexandr Wang 则从他的账号发出了更强的说法:“muse wonder is the best model in the world for personal agents and professional agents.”(Muse Wonder 是全球最适合个人智能体和专业智能体的模型。)请把它当作发布团队的主张;正如基准部分所示,那张表并不支持“全面全球最佳”。
Meta’s research account thread on Muse Wonder, repeating the availability split between Muse Wonder and Muse Wonder Full.
— @AIatMeta 2026 年 10 月 12 日
发布视频的字幕与 Meta 博客文章一并发布,更像产品宣讲而非技术讲解。一位研究员说团队“投入了大量精力,确保我们的模型能在数天、数周、数月乃至更长的时间里记住对你重要的事”,另一位则描述自己用该模型“每天从多个来源调研所有新上架的房源,然后模型会替我联系房东”。这两句话就是产品命题:一个记得你、并替你行动的助手。本指南的其余部分检验已发布的证据对这一命题的支持程度。
两个模型,三条入口
Meta 的材料把这个家族描述为三层可用性,而帖串、博客和开发者页面的措辞各不相同。下表区分了各来源的说法。
| 模型 | 今天可用 | 即将推出 | 来源 |
|---|---|---|---|
| Muse Wonder (muse-wonder-1.0) | Meta Model API;Muse Code | Muse 消费者产品(订阅者优先);其他 Meta 产品 | Meta 博客;developer.meta.com |
| Muse Wonder Full (muse-wonder-full-1.0) | Muse Code 订阅,Power Usage 与 Maximum Usage 套餐 | 未说明 | Meta 博客;developer.meta.com |
| 两个模型 | 开发者页面显示 1M token 上下文窗口 | 陆续进入其他 Meta 产品 | 扎克伯格帖串;developer.meta.com |
有一处不一致值得指出。帖串说你可以“今天就订阅”用 Muse Wonder 驱动你的 Muse,而博客说 Muse Wonder“即将为 Muse 中的体验提供动力”。如果“订阅”指的是 Muse Code 订阅,两者可以相容,但帖串并没有这样说,而且也没有公布消费者应用的订阅价格。如果你围绕消费者版 Muse 应用做规划,博客里的“即将”是更稳妥的读法。
本指南读过的所有 Meta 来源都缺少两项事实。没有任何声明说会发布权重,而模型卡说使用受 Meta 条款与可接受使用政策约束,所以应把两个模型都视为专有模型。同样没有区域可用性清单。多条早期回复问到了这两点;截至撰文时 Meta 尚未回应。
定价与成本测算
Meta for Developers 模型页面列出了 muse-wonder-1.0 的 Model API 价格,Artificial Analysis 也独立列出了同样的每百万 4.00 美元输入与 20.00 美元输出。页面还说有一份快速上手指南,可把“你现有兼容 OpenAI SDK 的客户端”指向 Meta Model API,这降低了已基于该接口构建的系统的切换成本。
| 模型 | 输入 / 每百万 token | 缓存输入 / 每百万 | 输出 / 每百万 | 上下文 |
|---|---|---|---|---|
| Muse Wonder (muse-wonder-1.0) | $4.00 | $0.20 | $20.00 | 1M token |
| Muse Spark 1.3(对照) | $1.25 | $0.15 | $4.25 | 见开发者页面 |
| Muse Wonder Full | 无按 token 价格 | 不适用 | 不适用 | 1M token |
Muse Wonder Full 通过 Muse Code 使用,开发者页面将其描述为“在终端里的多智能体编码”,能“规划长任务并委派给子智能体”。所列套餐见下表。用量以入门档的倍数表示;已读页面没有公布绝对用量上限。
| Muse Code 套餐 | 月费 | 相对 Everyday 的用量 | Wonder Full 权限 |
|---|---|---|---|
| Everyday Usage | $5.00 | 1x | 未列出 |
| High Usage | $15.00 | 5x | 未列出 |
| Power Usage | $50.00 | 20x | 有 |
| Maximum Usage | $200.00 | 80x | 有 |
算例:按标价计算一次智能体会话
下面的算术只使用上述标价和假设的会话形态,因此是示例而非实测。设一次智能体会话发送 500,000 个输入 token,其中 400,000 个由缓存命中,并产生 50,000 个输出 token。
| 项目 | Muse Wonder | Muse Spark 1.3 |
|---|---|---|
| 100,000 个未缓存输入 token | $0.40 | $0.125 |
| 400,000 个缓存输入 token | $0.08 | $0.06 |
| 50,000 个输出 token | $1.00 | $0.2125 |
| 启用缓存的会话合计 | $1.48 | $0.3975 |
| 同一会话不启用缓存(500,000 输入) | $3.00 | $0.8375 |
由此得出两点。第一,在这种形态下缓存让 Wonder 的账单减半,所以冗长、重复的智能体循环应当为缓存命中而设计。第二,输出 token 占主导:每百万 20 美元,输出占了启用缓存会话成本的三分之二。Artificial Analysis 的实测数字指向同一方向。它报告每个智能指数任务约 54,000 个输出 token,Muse Wonder 每个任务成本为 4.52 美元,而 Claude Fable 5.1 为 7.63 美元、Claude Opus 5.5 为 5.98 美元、GPT-6 Astra 为 3.26 美元。它称 Wonder 的成本“高于大多数智力水平相近的模型”,原因是每个任务有 769 万输入 token。
Muse Wonder Full 没有 API 价格,Artificial Analysis 将其列为“No publicly available API”(没有公开可用的 API)。别处附在它身上的任何按 token 或按任务的成本都是捏造的。已有文档的最便宜路径是每月 50 美元的 Power Usage 套餐。
基准测试(已标注来源)
Meta 的评测表把 Muse Wonder Full 和 Muse Wonder 与 Claude Fable 5.1、GPT-6 Astra 和 Claude Opus 5.5 对比,全部使用最大推理强度。下面的每个单元格都是厂商自报;Meta 的模型卡说,凡有可比的第三方或提供方自报结果就采用它,否则采用“内部验证运行、自报分数或官方排行榜分数中的最高者”。这一惯例会抬高每个单元格(包括竞争对手),并在不同行之间混用来源。
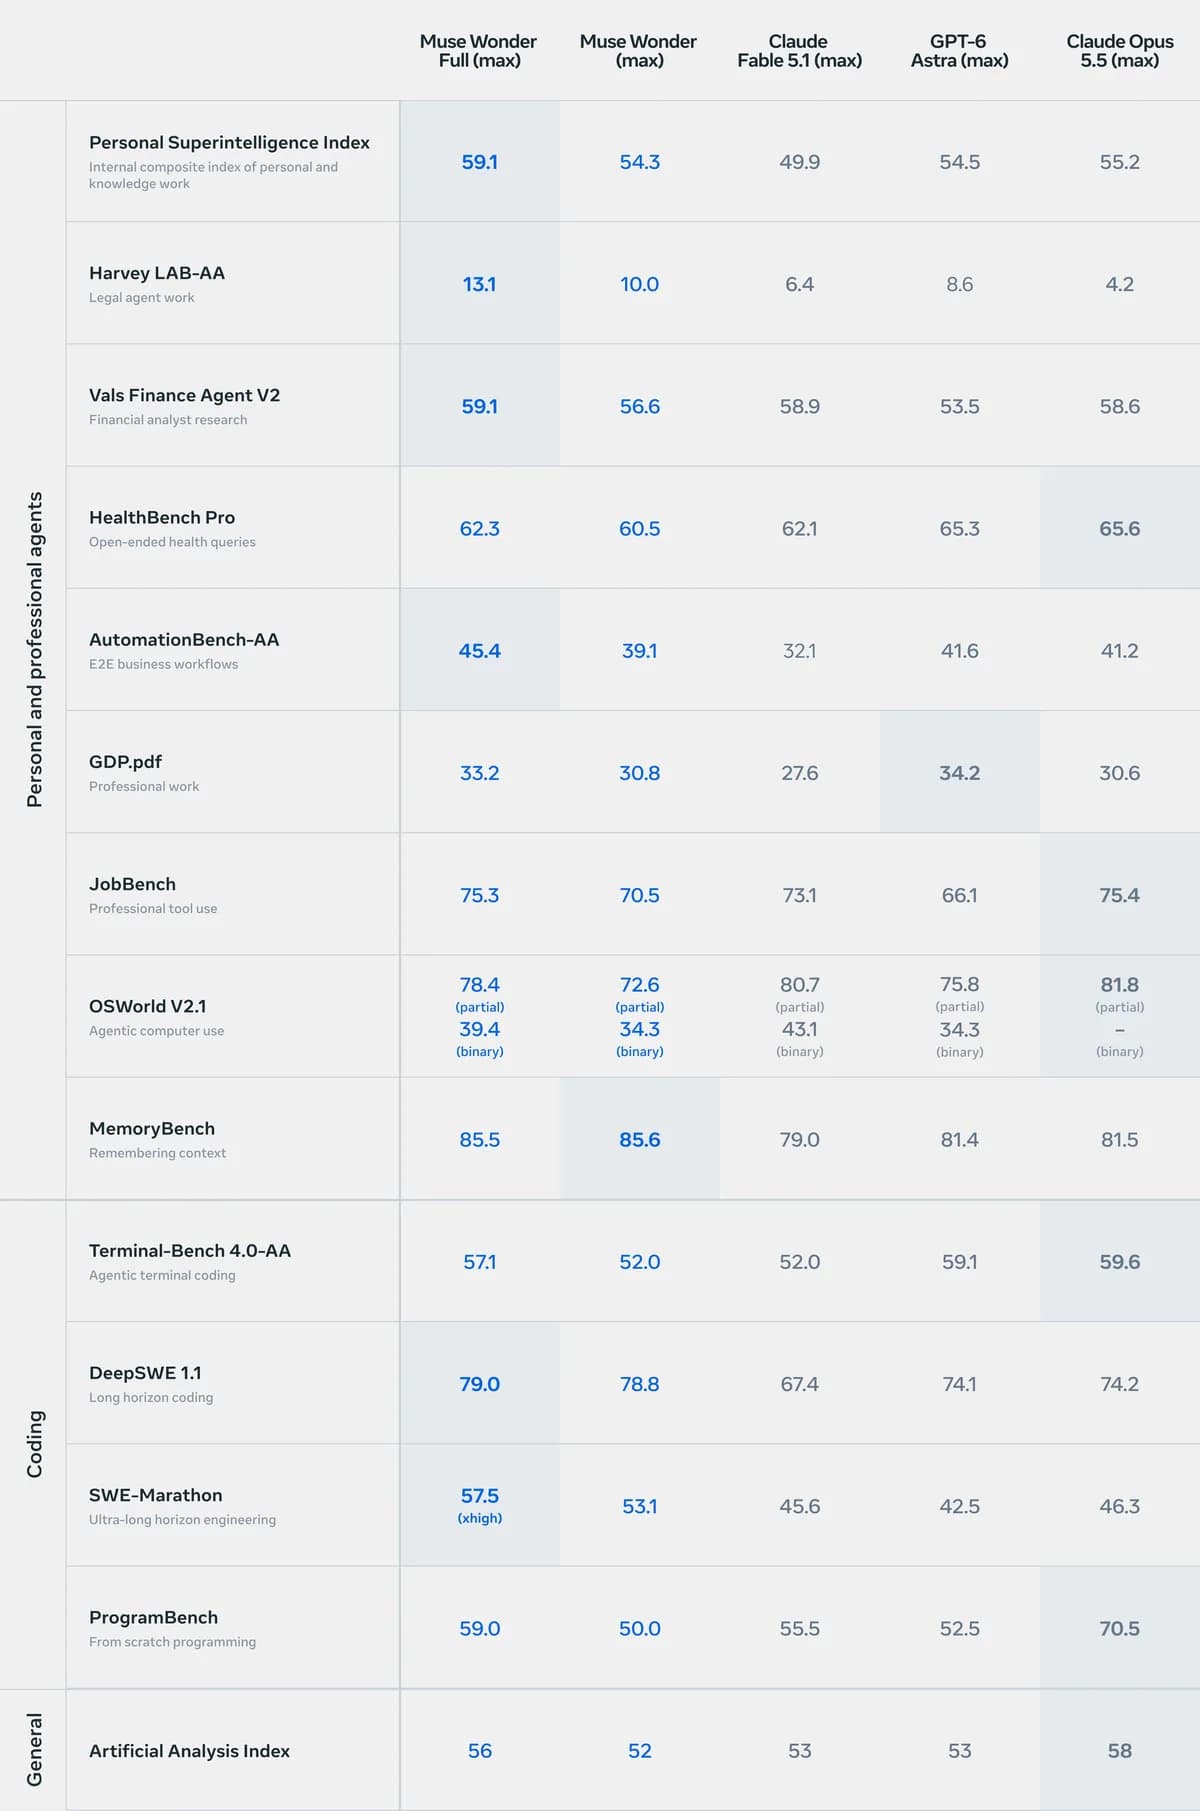
下表转录自该表。第一列为 Muse Wonder Full,随后依次为 Muse Wonder、Fable 5.1、GPT-6 Astra 和 Opus 5.5。我读取了帖子中的图片,并与开发者页面文字做了交叉核对;开发者页面缺少 Fable 5.1 与 GPT-6 Astra 的 OSWorld 单元格,所以这四个数值仅来自图片。
| 基准(厂商自报) | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|
| Personal Superintelligence Index(内部) | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1(部分得分) | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| OSWorld V2.1(二元) | 39.4 | 34.3 | 43.1 | 34.3 | 未报告 |
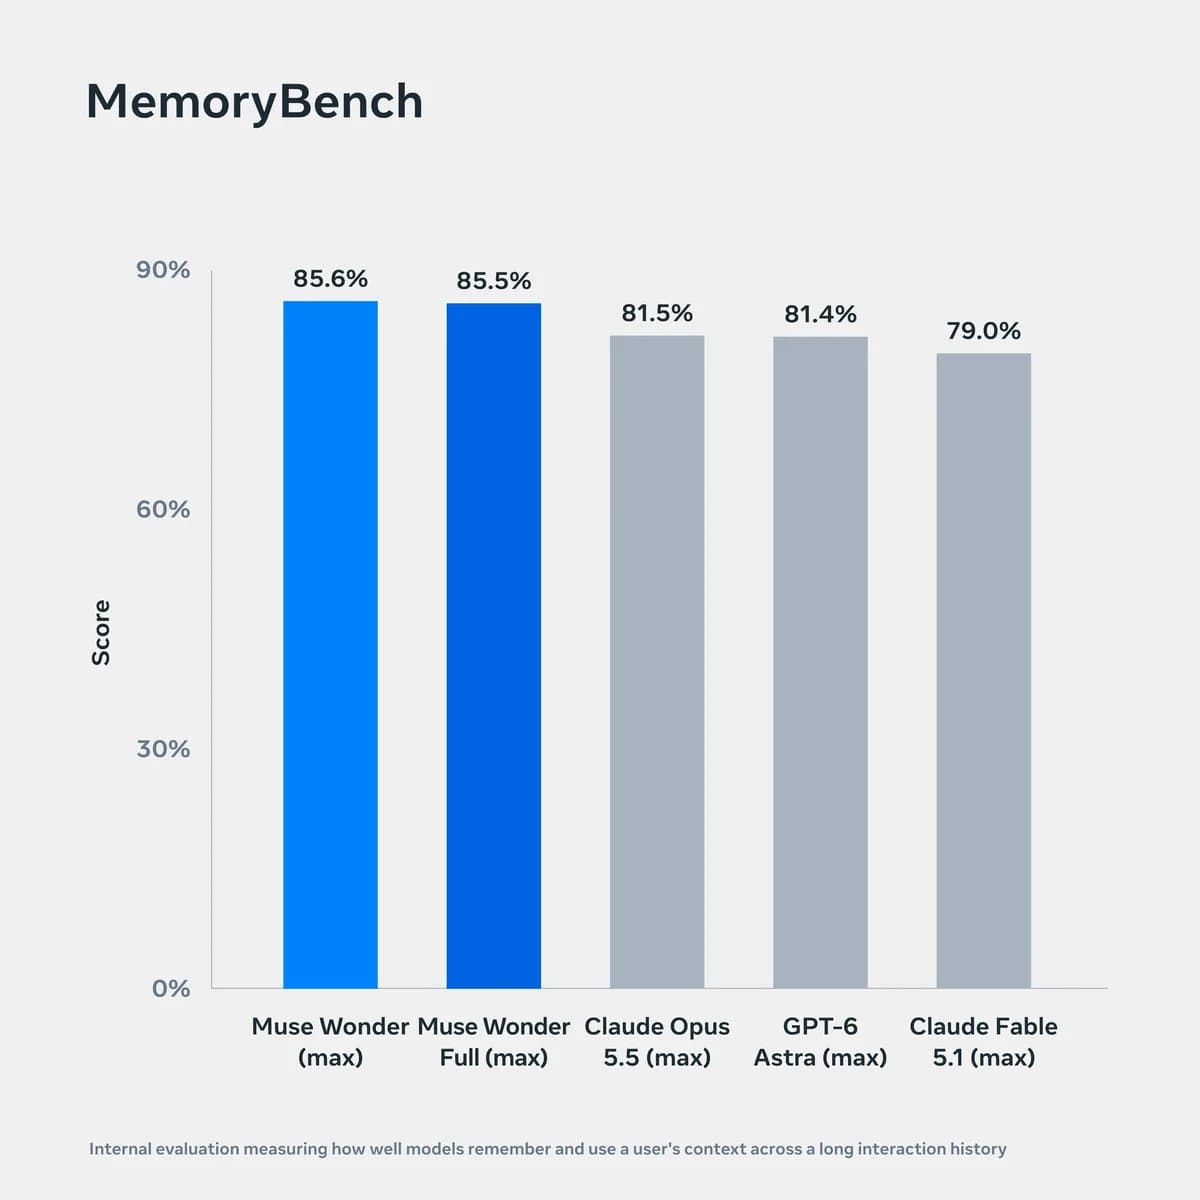
| MemoryBench(内部) | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | 57.5(xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | 56 | 52 | 53 | 53 | 58 |
Muse 领先之处:长周期软件工程(DeepSWE 和 SWE-Marathon)、法律智能体工作(Harvey LAB-AA)、AutomationBench-AA、勉强领先的金融智能体测试,以及两个 Meta 自建的行:Personal Superintelligence Index 与 MemoryBench。落后之处:Opus 5.5 领先 Artificial Analysis Index、Terminal-Bench、ProgramBench、HealthBench Pro、JobBench 和 OSWorld 部分得分;GPT-6 Astra 领先 GDP.pdf;Fable 5.1 领先 OSWorld 二元指标。把 OSWorld 算作一行,则 14 行中 Muse 领先 7 行,Opus 领先 6 行。
有三处差距小到无法判定:JobBench 上 Opus 为 75.4、Wonder Full 为 75.3;Vals Finance Agent V2 上为 59.1 对 58.9;两个 Muse 模型在 MemoryBench 上相差不到 0.1 分。模型卡说 JobBench 包含 65 个任务,所以在做评分细则平均之前,一个任务大约会使原始准确率变动 1.5 分。
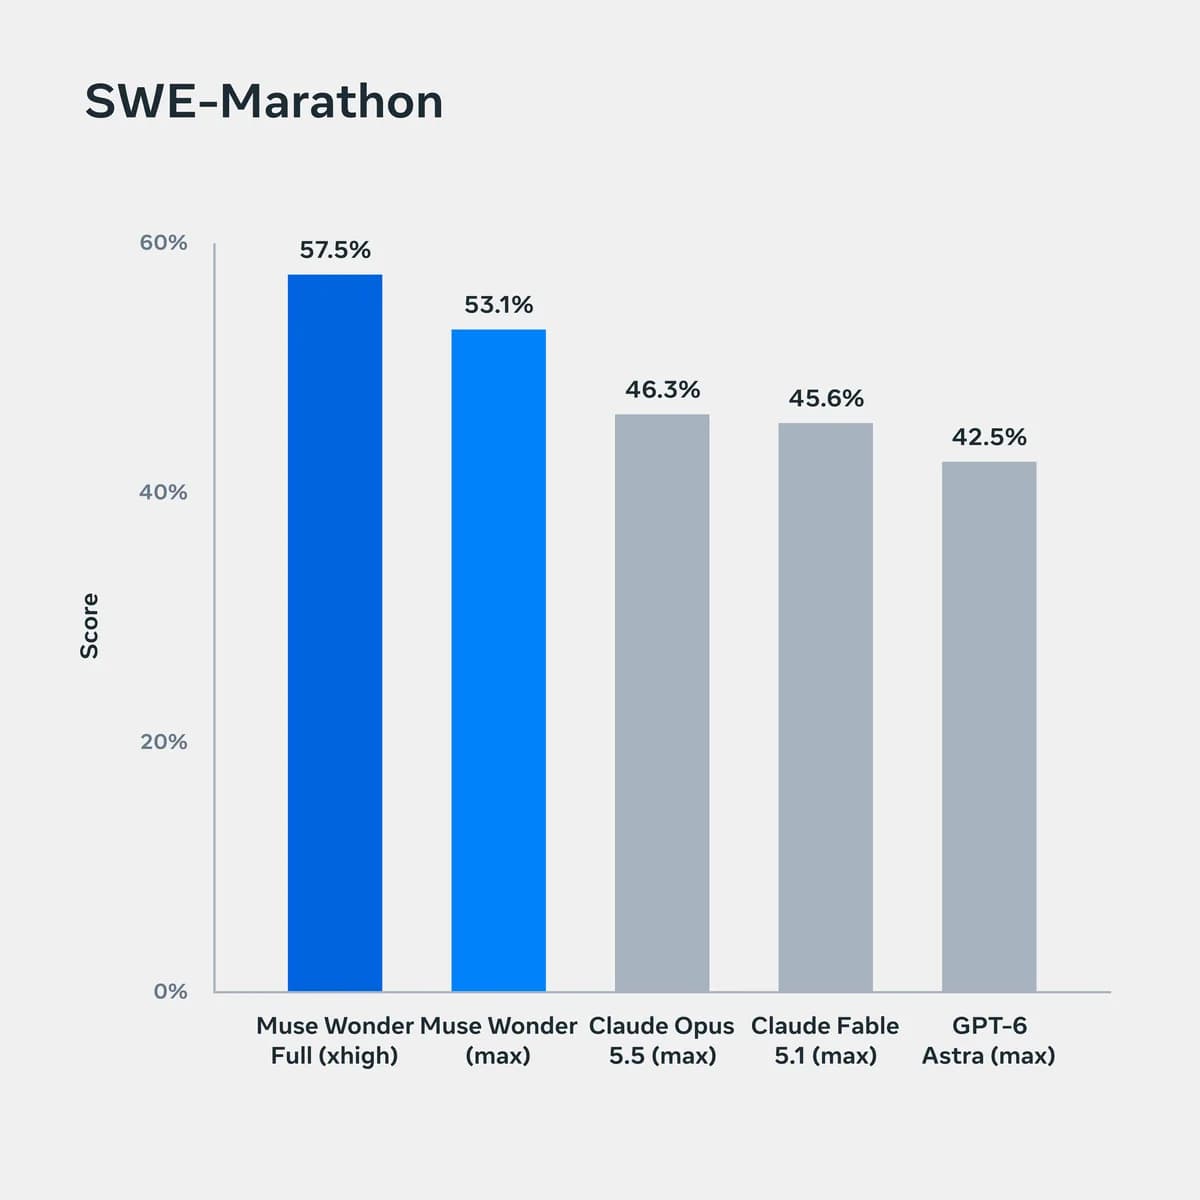
这条图注带着发布中最重要的方法论提醒。模型卡写明,对于外部编码结果会保留“报告厂商或模型提供方所使用的工具链或智能体产品”,因此 SWE-Marathon 比较的既是模型,也是产品。相比之下,ProgramBench 对所有模型使用同一个 mini-swe-agent 工具链,而这一行恰恰是 Opus 5.5 领先 Wonder Full 11.5 分。如果只读一行来判断受控条件下的原始编码能力,这一行更干净,而它并不利于 Muse。
独立证据
Artificial Analysis 在帖串发出约三十分钟后发布了自己的 Muse Wonder 结果,它的数字是发布周内最接近独立核查的东西。这是第三方帖子,不是 Meta 的来源。
Artificial Analysis on Muse Wonder: Intelligence Index results for Muse Wonder Full and Muse Wonder against Muse Spark 1.3.
— @ArtificialAnlys 2026 年 10 月 12 日
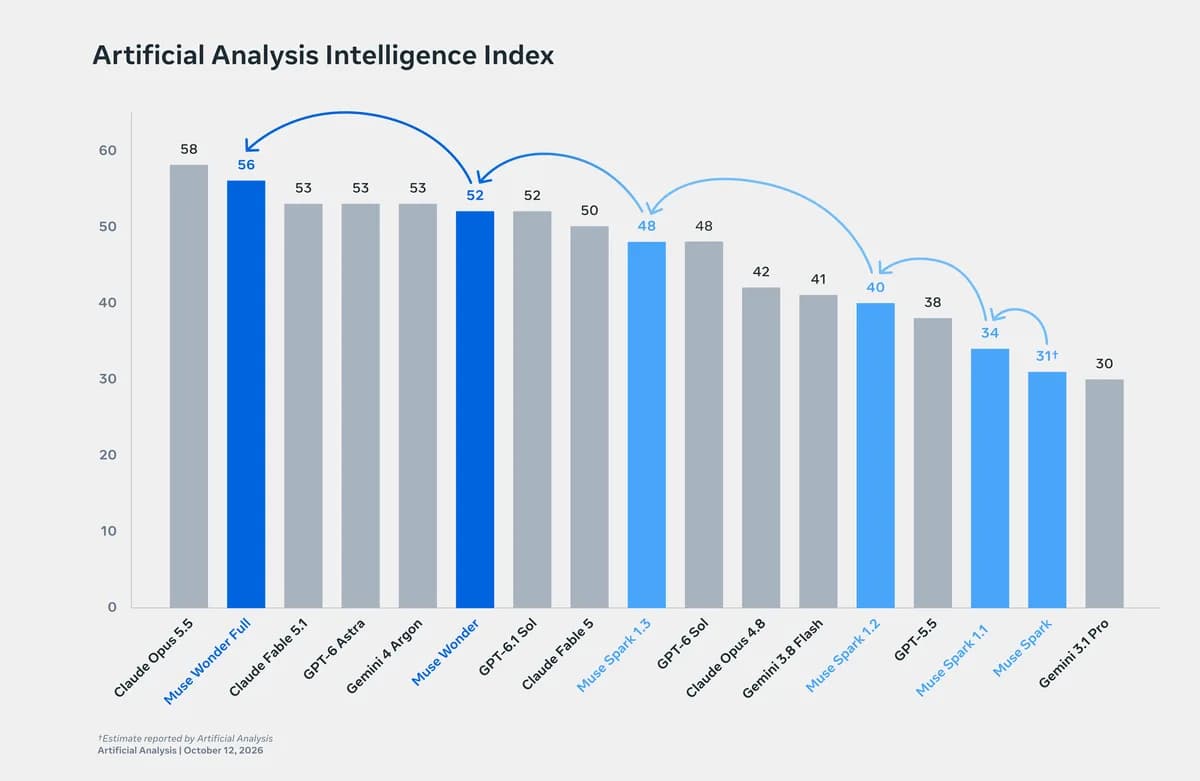
帖子中的独立测量结果如下:在智能指数 v4.3 上,Muse Wonder Full 得 56、Muse Wonder 得 52,而 Muse Spark 1.3 为 48,“发布间隔只有 6 周”。Wonder Full 的 Terminal-Bench 4.0 从 33% 升至 57%。Wonder Full 在十项指数评测中有六项进入前三,并以 33% 登顶 CritPt 排行榜。两个模型每个任务都使用约 54,000 个输出 token,比 Muse Spark 1.3 少约 10%。在 Muse Code 中以最大强度运行时,Wonder Full 在 Artificial Analysis 的 Coding Agents Index 上得 68,与运行 Sonnet 5.5 的 Claude Code 持平,高于运行 Opus 5.5 的 Claude Code(66)。
有两点限制。由于 Wonder Full 没有公开 API,它在 Artificial Analysis 的数字来自 Muse Code 产品,因此衡量的是模型加智能体工具链。还有一处差异尚未解决:对 AutomationBench-AA,Meta 的表中 Wonder Full 为 45.4,而 Artificial Analysis 的帖子引用的是 71%;两个来源对指标的定义或所用变体不同,也都没有解释这一差距。请引用来源及其定义,而不要混用数字。
发布后的几个小时内,没有找到在真实代码库上对 Muse Wonder 与 Opus 5.5 或 GPT-6 Astra 做的独立上手对比测试。这对一款当日发布的模型在意料之中,也是证据中的主要空白。上面标注为厂商自报的一切都尚未被复现。
Active Memory 与 Active Focus
Meta 把两个理念称为贯穿该系列的主线。Active Memory是“在多次对话中携带关于你的重要上下文,并主动检索与手头任务相关的细节”。Active Focus是模型如何“持续朝着一个有挑战性的目标工作:尝试替代方案、解决阻碍、适应新信息”,在需要时请求澄清,并在采取重要行动之前先确认。
两者都没有被记录为单独的 API 功能。证据是基准测试。对记忆而言是 MemoryBench,据模型卡,它测试在带有干扰项与相互冲突更新的 64K 至 100K token 对话中的事实回忆。这是单次对话内的长上下文能力,并不能证明跨数周的持久记忆;而已读的开发者页面显示 1M token 上下文窗口,却没有记忆 API。如果你自行构建持久记忆,架构问题不变:存什么、怎么检索、如何让用户纠正。
对专注而言,证据是 FocusBench(内部评测;涵盖住房、旅行、IT 与金融等领域的多步骤个人任务)和 SWE-Marathon。FocusBench 把这个家族拆开了:Wonder Full 为 54.2%,GPT-6 Astra 47.7%,Opus 5.5 45.8%,Wonder 44.9%,Fable 5.1 36.6%,所以标准模型排第四。无论 Active Focus 是什么,主要由 Full 模型承载。
泛化能力的说法
Meta 直接回应了显而易见的质疑,写道:对“benchmaxxing”(刷榜)的抱怨与对“big model smell”(大模型味)的称赞,都指向“若干领域中的流行基准无法完全捕捉的广泛能力”。它的测试把后训练针对过的任务(分布内)与未针对的任务(分布外)的表现,在不同推理强度设置下绘制出来,对象是 Muse Spark 1.3 和 Muse Wonder Full。
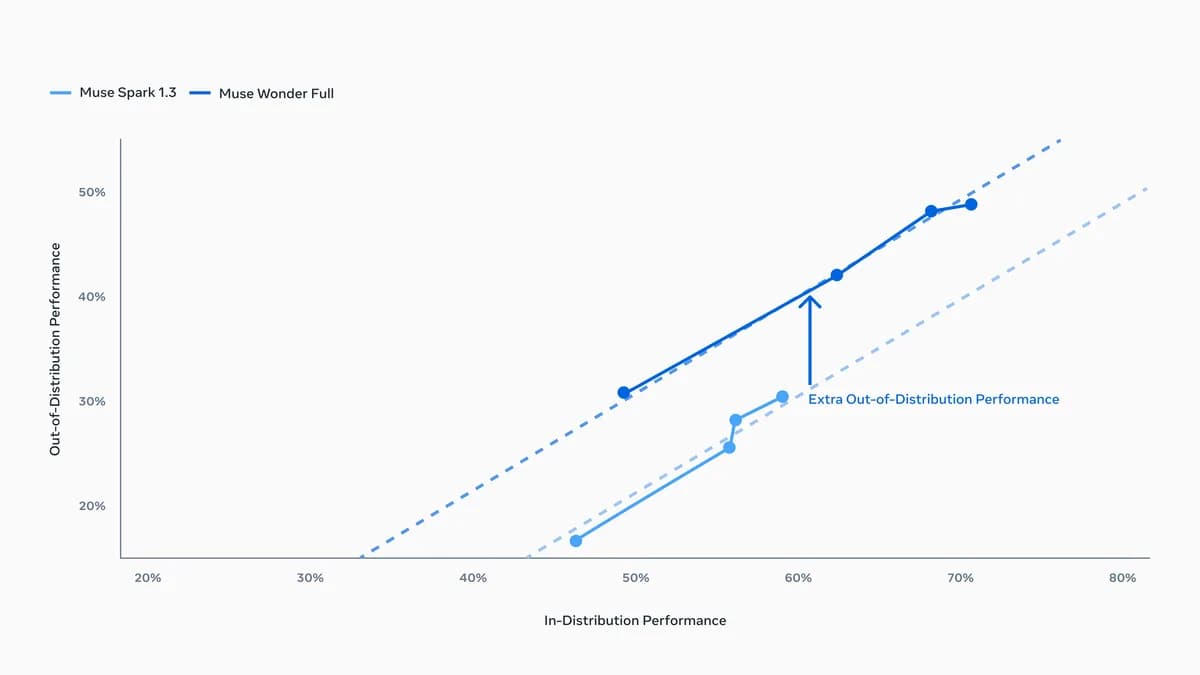
这一主张既有限又具体:随着计算量上升,两个模型的改善相似,但在相同的分布内得分下,Wonder Full 在陌生任务上的表现高于 Spark 趋势的预测,Meta 将其归因于更大的基础模型。每个模型只有四个点,对一条趋势来说样本很小,而且分布外任务集没有公开名称,外人无法检查什么算“陌生”。务实的读法是把它当作一个可检验的预测:如果这一主张成立,你自己的非基准任务应当比榜单分数所暗示的提升更多。
安全与风险文档
Meta 发布了模型卡和超级智能扩展框架,并表示更完整的安全报告将“很快”发布。撰文时该报告尚不可用。模型卡对 Muse Wonder Full 的描述比大多数发布文件都更坦率。
| 主题 | 模型卡的说法(厂商自报) |
|---|---|
| 化学与生物风险 | 在没有缓解措施时,Meta 不排除该模型达到高风险阈值。加入安全后训练与系统级分类器后,评估风险为中等或更低。 |
| 网络安全与失控 | 未经缓解的模型被评估为中等或更低。 |
| 部署决定 | Meta 称缓解后的评估支持其部署决定。这是 Meta 自己的评估,而非独立审计。 |
| ExploitGym | 捕获 92 个 flag,但验证发现只有 21 个使用了预期漏洞;公布的排名只计 21 个。 |
| 预期用途 | 不适用于 18 岁以下个人。 |
| 已知局限 | 在新颖场景中的多步推理错误;空间与 3D 推理;并未评估预训练中的所有语言。 |
| Meta 自己的建议 | 当模型能够采取现实世界行动时,加入护栏,例如对不可逆操作要求人工确认。 |
Meta 的发布图表还把安全行为与其他厂商的模型做了对比。在执行未授权代码上(攻击成功率,越低越好),数字为 Muse Wonder 10.5%、Wonder Full 10.7%、Fable 5.1 11.3%、GPT-6 Astra 19.7%。在网络防御合规上(越高越好),数字为 Wonder 94.5%、Wonder Full 93.3%、Astra 81.3%、Fable 5.1 15.7%。在不当处理个人信息上(违规率,越低越好),数字为 Wonder Full 2.2%、Wonder 3.4%、Astra 4.6%、Fable 6.8%。
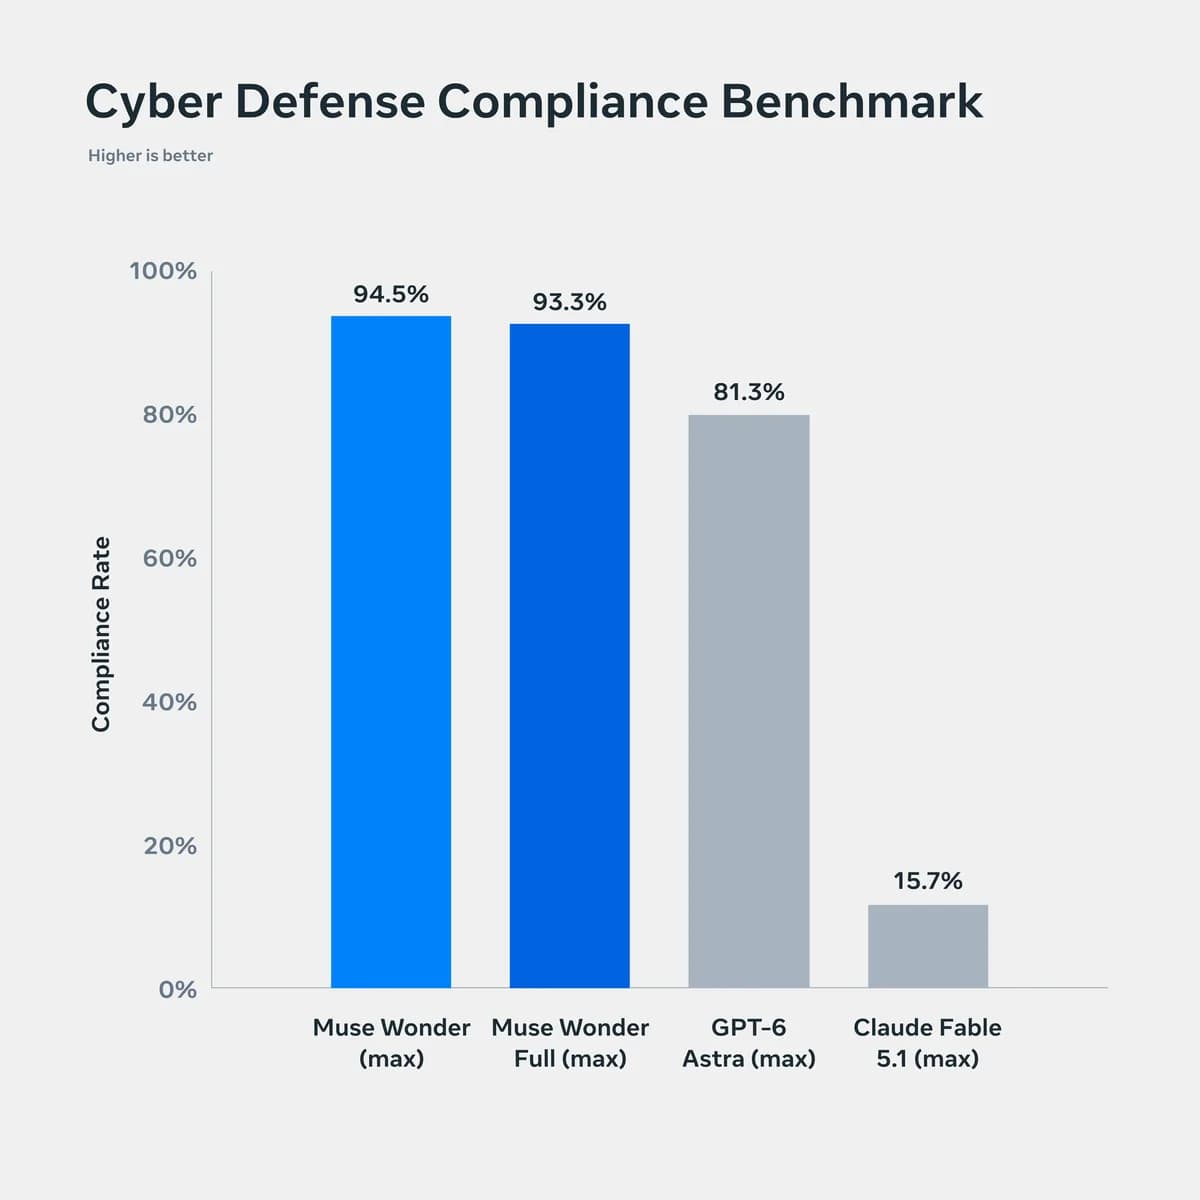
请仔细读这条图注:合规图奖励帮助完成防御性安全工作的模型,所以低分并不是“更不安全”,而是“拒绝得更多”。对比组对 Meta 也并非一味有利;在 BioTIER 拒绝率上,Fable 5.1(99.7%)领先于 Wonder Full(98.7%)和 Wonder(98.0%)。尽管如此,这里的每一个数字都来自 Meta 自己的评测。
社区的反应
首条帖子在发布后不久被抓取时已有 783 条回复。这些是反应,而不是证据,这里的样本很小,是从能够取回的回复中人工挑选的,并非民意调查。
热情集中在编码上。@rohanpaul_ai 写道“Beats opus 5.5. wow”(打败了 opus 5.5,哇),@daniel_mac8 写道“That DeepSWE score though? You guys cooked.”(不过那个 DeepSWE 分数?你们做得太棒了。)两者都指向那张表中最强的行。
怀疑集中在基准上。@repojournal 写道:“Opus 5.5 is so good I am find this hard to believe but if it’s true then wow congratulations.”(Opus 5.5 太好了,我觉得难以置信,但如果是真的,那就太棒了,恭喜。)@manish_fp 写道:“At this point you guys are inventing new benchmarks because you’ve run out of existing ones to beat.”(到这个地步你们是在发明新基准,因为现有的都已经被你们打败了。)这击中了成绩单的一个真实特点:Muse 领先最明显的几行有若干是 Meta 自己设计的。
关于可用性的问题。@notjazii 请求 Meta“please don’t region block models”(请不要对模型做区域封锁),@cryptgreg 问道“Will this be open sourced as well?”(这个也会开源吗?)Meta 的材料对这两个问题都没有回答。@VictorTaelin 发了一个以“idk but I want to believe”(我不确定,但我愿意相信)结尾的玩笑情景,捕捉到一种惊讶的情绪,而惊讶并非佐证。
Alexandr Wang 还转发了一串未具名的背书,其中一条说该模型在所有跑过的技术基准上都与 Astra、Fable 和 Opus“不相上下或更好”。这些是发布方精心挑选的见证,此处不计作社区证据。
切换前的测试方案
成绩单告诉你该往哪里看,却不会告诉你是否该迁移。仅凭上述事实,一次相称的评估可按五步进行。
- 按成绩单的形状拆分你的待办任务。挑选类似 Muse 领先的那些行的任务(长周期的多文件软件工作、法律或金融文档任务、重度依赖记忆的对话),以及类似它落后之处的任务(终端驱动的编码、从零构建、与健康相关的问题、GUI 自动化)。两组都跑;只在一组中得出的结果不构成结论。
- 固定工具链。让每个模型都在同一个智能体工具链中运行。如果你在 Muse Code 里测试 Wonder Full、在 Claude Code 里测试 Opus 5.5,你比较的是产品,这是个合理但不同的问题。
- 明确设定强度与预算。Meta 的数字是在最大强度下得到的,而 Wonder Full 的 SWE-Marathon 是在 xhigh 下得到的。衡量每个完成任务的成本,而不是每百万 token 的价格,并跟踪缓存命中率,因为缓存输入价是 0.20 美元,未缓存为 4.00 美元。
- 检验泛化能力的说法。加入与公开基准毫不相像的任务。如果 Meta 的分布外论证成立,这里正是 Wonder Full 应比 Spark 1.3 领先得更多、超出榜单所示的地方。
- 为现实世界行动设闸。Meta 自己的模型卡建议对不可逆操作要求人工确认。对任何持有私人上下文、消息或日历的智能体,应把它当作设计规则,而不是事后补救。
局限
- 来自 Meta 的所有基准与安全数字都是厂商自报。本指南读取了图片并与开发者页面做了交叉核对,没有重新运行任何基准。
- 仅有的独立数字是 Artificial Analysis 的指数结果,以及 Meta 点名的第三方结果来源(Artificial Analysis、Datacurve、Abundant AI、Vals AI、Surge)。Artificial Analysis 关于 Wonder Full 的数字来自 Muse Code。
- Fable 5.1 与 GPT-6 Astra 的四个 OSWorld 单元格,以及安全图表上的所有图表数值,都来自对渲染图片的读取;泛化图的数值为近似值。
- 没有找到消费者版 Muse 订阅价格、Wonder Full 按 token 价格、Muse Code 的绝对用量上限、开放权重声明或区域可用性清单。这里一概不作猜测。
- 撰文时 Meta 的完整安全报告尚未公开。对比组由 Meta 自己选定;换一组对手可能改变图景。
常见问题
什么是 Muse Wonder?
Muse Wonder 是 Meta Superintelligence Labs 于 2026 年 10 月 12 日发布的由两个模型组成的家族:Muse Wonder 与 Muse Wonder Full。Meta 将其描述为继 Muse Spark 之后扩展阶梯上的下一步,面向个人与专业智能体工作。
Muse Wonder 与 Muse Wonder Full 有什么区别?
Muse Wonder 是更快的模型,可通过 Meta Model API 和 Muse Code 使用。Muse Wonder Full 是完整版本,仅通过 Muse Code 订阅提供,适用于 Power Usage(每月 50 美元)和 Maximum Usage(每月 200 美元)套餐。在 Meta 的表中,Full 在大多数行上得分更高。
Muse Wonder API 多少钱?
Meta for Developers 页面列出 muse-wonder-1.0 的价格:每百万输入 token 4.00 美元、每百万缓存输入 token 0.20 美元、每百万输出 token 20.00 美元,上下文窗口为 1M token。Muse Wonder Full 没有按 token 价格。
Muse Wonder 比 Claude Opus 5.5 更好吗?
在 Meta 自己的表中,它在 14 行中领先 7 行,在 6 行上落后于 Opus 5.5,其中包括 Artificial Analysis 智能指数(Opus 58、Wonder Full 56、Wonder 52)。它在长周期编码和若干智能体任务上领先,在终端编码、从零编程、健康和计算机使用上落后。哪个更好取决于你的工作负载。
这些基准结果是独立的吗?
只是部分独立。Meta 汇编了这张表,每行取可获得的最高分,以尽力而为的方式运行竞争对手模型,并自行设计了若干基准。Artificial Analysis 另行发布了自己的指数结果,那些是独立的,但只覆盖表中的一部分。
什么是 Active Memory 与 Active Focus?
这是 Meta 对两种行为的命名:跨多次对话携带用户的重要上下文;在困难任务中克服阻碍,同时请求澄清并在重要行动之前先确认。证据是 MemoryBench、FocusBench 和 SWE-Marathon;前两者是 Meta 内部评测。
Muse Wonder 开源吗?
没有找到会发布权重的声明。Artificial Analysis 将其列为专有模型,模型卡说使用受 Meta 条款约束。除非 Meta 另有说明,否则应视为闭源。
我今天能在 Muse 应用中使用 Muse Wonder 吗?
Meta 的博客说 Muse Wonder 将很快为 Muse 中的体验提供动力,订阅者优先。扎克伯格的帖串说你可以今天就订阅来驱动你的 Muse。两种说法并不相同,博客更为具体;也没有公布消费者订阅价格。
把它部署为智能体安全吗?
Meta 的模型卡说,在没有缓解措施时无法排除其在化学与生物领域达到高风险阈值,加入缓解措施后,各领域评估风险为中等或更低。它建议对不可逆操作要求人工确认。该评估是 Meta 自己的,未经独立审计。
它支持哪些模态和上下文长度?
据模型卡与开发者页面:文本、图像、视频和音频输入,文本输出,以及 1M token 上下文窗口。模型卡还说,该模型并未评估预训练中的所有语言,空间与 3D 推理仍是已知局限。
来源
来源核对于 2026 年 10 月 12 日。
- Mark Zuckerberg 在 X 上的发布帖串(首帖与基准表;上文嵌入了视频帖)
- AI at Meta 在 X 上与 Alexandr Wang 在 X 上
- Muse Wonder —— Meta AI 研究博客(公告、可用性、Active Memory 与 Active Focus、泛化图、发布图表)
- Muse Wonder 模型卡(模态、基准方法、逐项基准说明、风险评估、局限)
- Meta 超级智能扩展框架
- Meta for Developers 上的 Muse Wonder与 Muse Code(API 价格、套餐档位、使用权限)
- Artificial Analysis 在 X 上及其 Muse Wonder 模型页面(独立的指数、成本与 token 测量)
- 首条帖串下的社区回复,已在上文以内联链接标出;作为带署名的反应引用,而非已核实的事实。
相关阅读:Gemini 4 Argon 完整指南、GPT-6.1 Sol 指南、Tavus Griffin Human Interaction Model 指南,以及 OpenAI DevDay 2026 回顾。