Tavus 于 2026 年 10 月 1 日发布 Griffin,称其为首个 Human Interaction Model(HIM),也是首个通过实时视频图灵测试的模型。在一项实时研究中,54 名参与者中有 26 人(48%)在一分钟视频通话后认为对方是真人;而在 Tavus 此前的一整套技术上,41 人中只有 1 人(2.4%)这样认为。Griffin 是一个全双工、视频到视频的统一系统,它观察、聆听、决定何时回应,并同时生成语音和视频——而不是串联彼此独立的语音、语言与数字人模型。
被测的版本 Griffin-Lite 是一个研究预览版,仅向少数受信任的测试者开放。它尚未上架 Tavus 平台,也没有公开的模型标识、端点、价格或模型卡。本文基于一手资料构建:Griffin 官方页面、X 上的九条发布线程、NVIDIA 的 VideoFDB 基准页面及其论文,以及 Tavus 的定价页面。所有数字核对于 2026 年 10 月 1–2 日。
Tavus 发布了什么
Tavus 是一家总部位于旧金山的公司,销售对话式视频——「PAL」,你可以与其面对面交谈的 AI——建立在三款已发布的模型之上:Phoenix(实时面部渲染)、Raven(感知)和 Sparrow(轮次管理)。Griffin 把这些工作合并为一个模型。Tavus 把旧方法描述为中继:一个模型转写你的语音,一个大语言模型生成回复,其他系统把回复变回声音和面孔,「每一次交接都会增加延迟,并丢掉下一个系统从未看到的信息,比如你的语气或镜头里的内容」。
这次发布以 @tavus 账号在 2026 年 10 月 1 日 16:59 UTC 发出的九条线程帖子呈现。第一条帖子直接给出了主张。
Introducing Griffin, the first model to pass the video Turing test. 48% of people who talked to it live thought it was a real human. Previous systems have had a pass rate under 3%. It is #1 on NVIDIA’s benchmark for full-duplex AI video. It’s the first Human Interaction Model (HIM).
— @tavus 2026 年 10 月 1 日
另外两条帖子勾勒了命题与诚实。一条描述让机器「在我们所在之处与我们相遇」,并给出例子——一个能察觉学生听不懂的老师、一个养老陪伴者——描述的是开放式对话而非脚本化的数字人。序列中最后一条对发布策略异常坦率:因为 Griffin「可能被误认为是真人」,Tavus 说它「在公开发布前需要经过安全考量」。研究帖由联合创始人兼 CEO Hassaan Raza 与研究主管 Ioannis Patras 署名。
什么是 Human Interaction Model
Tavus 把 Human Interaction Model 定义为「一类旨在理解并生成面对面的实时人类交互的新型模型」。其核心思想是 HIM 在说话的同时聆听,并关注表情和停顿,而不只是文字。这与一个会说话的「数字人」——对文本作出反应来驱动一张脸——是截然不同的目标。
这一类别在实践中重要的原因在于架构。传统智能体是回合制的:它等你停下来,转写、推理,然后开口。真实对话不是回合制的。人们会在句子中途给予回应(「mm-hm」),会笑早半拍,会打断,也会把沉默解读为思考或继续的邀请。一个把停顿当作话轮结束的模型,无论它的脸多么出色,都无法参与这些信号。
发布视频里有什么
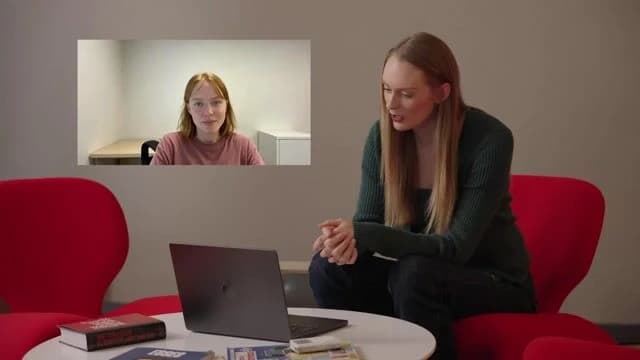
首条推文附带一段 108 秒的视频,值得在任何数字之前先看一遍,因为它定下基调。视频里,一个男子在视频通话中与另一端的女子交谈;她留着齐肩棕色头发,背景是素净的浅色墙面,一个小画中画显示着他。镜头在他屏幕、他的面部,以及两位正在观看并大笑的同事的较宽画面之间切换。字幕承载着对话:「Have you thought any more about」「you know, show them what it looks like」「Do you think they’ll believe」「It’s like the line between」「of the simulation」。最后一帧是 Tavus 字标和那句「the human computing company」。
那条收尾字幕就是整个论证的浓缩。通话中的女子——也就是生成的数字人——说话时会打手势,在恰当的时刻微笑,并保持眼神交流;观看的人类则报以笑声和难以置信。画面里没有任何东西表明她是生成的。这既是 Tavus 的论点,也是其批评者的论点。
线程随后展示了五段简短演示。第一段是「Simon Says」游戏:要玩这个游戏,Griffin 必须听出这句话、观察玩家的手,并移动自己的手——同时进行。Tavus 强调它「生成的是整个画面,而不只是一张脸」。
Watch Brittney and Mars try to trip Griffin up at Simon Says. To play, it has to listen for “Simon says,” watch their hands and move its own, all at the same time. It generates the whole frame, not just a face.
— @tavus 2026 年 10 月 1 日
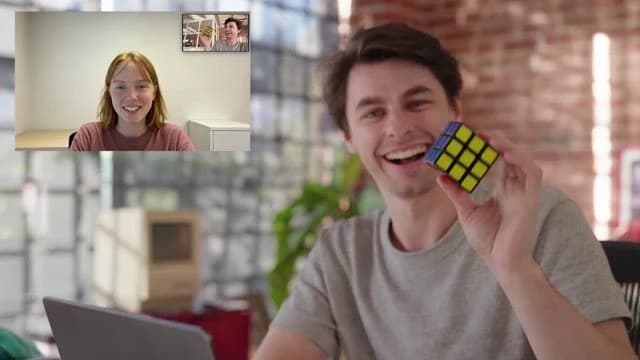
演示还在继续:一段在 Griffin 陪伴下讲述的故事,一场有人解魔方时 Griffin 从旁观察他手中魔方的辅导,以及一项焊接任务——Griffin 追踪时间并在下一步该做时开口,而不是等对方安静下来才说话。
Aria solves a Rubik’s cube while Griffin coaches him from what it sees in his hands, and when he goes quiet to think, it waits. Its perception is always on, so it acts without being asked.
— @tavus 2026 年 10 月 1 日
全双工的定义
全双工是这一主张的技术核心。Tavus 描述 Griffin 以「规律的亚秒级间隔」决定是保持安静、用点头示意、给予回应,还是接过话轮——依据它听到的和它看到的,而不是把一次停顿当作话轮的结束。官方页面把这一循环概括为「听、决定、行动」,在聆听和说话的同时每秒多次重新评估。
由此产生四个后果,而它们正是那些演示想要展示的:
- 它可以在你还在说话时就「mm-hm」,而不是等到出现尴尬的沉默。
- 它可以不留下级联在交接处产生的那种尴尬停顿就作答。
- 你一插话它就停下,而不是把句子说完。
- 它可以对你看到的东西作出反应——举起的一个物体、一个面部表情——并把它纳入回复。
Tavus 自己的示意图带有一条值得复述的免责声明:「本图中的时机仅作示意,并非从真实会话中测量得出。」这种坦率是有用的指引,因为下文那些基准分数才是真正被测量过的数字。
While Mars is still telling Griffin about a boring date, it laughs, nods and asks questions instead of waiting for her to stop. That’s full duplex: listening, watching and talking at the same time, the way people actually talk.
— @tavus 2026 年 10 月 1 日
Griffin 如何工作
Tavus 把 Griffin 拆分为两个引擎,这一拆分解释了它为何能在句子中途作出反应。
1. 持续对话建模。这个引擎摄取人的音频和视频,并在持续感知的同时输出「表现控制」——时机、姿态、表情、手势。Tavus 强调感知「在 PAL 说话时也从不停止」,因此一个在句子中途做出的决定(一次停顿、一次移开视线、一个微笑)会在同一个亚秒小回合内体现在声音和面孔上。
2. 视听生成。它把这些控制转化为语音和视频。在语音侧,Griffin 使用一个快速自回归扩散 Transformer,以一个编码的说话人前缀为条件;Tavus 称它可以从约 10 秒的音频中克隆音色,并输出「小至 10 毫秒」的音频包。其底层是 Tavec,一个卷积自编码器,把 48 kHz 音频映射为紧凑的连续潜表示——每帧 40 个值、每秒 100 帧、没有码本——并使用完全因果的解码器,使音频在一帧存在的瞬间即可流式输出。在视频侧,Tavus 通过三个阶段(分布匹配蒸馏、借助教师强制转换为自回归、再用 Self-Forcing 训练)把一个大型、双向、多步扩散模型蒸馏成少步自回归生成器,使长滚动不漂移。它「以 320 毫秒的令牌块实时生成 720p 视频,一次一个潜变量」,其中一个潜变量是 25 fps 下的八帧。
其中最具决策相关性的后果是延迟。Tavus 报告「真正的音到视频延迟」——从一段音频到达,到视频显示出它的效果——在 H100 GPU 上为 0.43 秒,它称这是次快方法的一半。这个数字正是一个点头能及时到位、让人感觉像点头而不是延迟模仿的原因。
视频图灵测试详解
这项研究产生了 48% 这一标题结果,而它的方法比那个数字更重要。参与者通过一个独立研究平台招募,并被告知将被匹配另一位参与者,进行一分钟视频通话,聊聊他们今年期待什么。他们的对象实际上是一个运行 Griffin-Lite 的 PAL,实时生成她的面孔、声音和回应。只有在调查结束时,他们才被问到是否曾想过对方可能不是真人;随后每位参与者都被告知对方是 AI。对比臂使用相同的协议,针对 Phoenix-4.5 搭配 Sparrow-2 和 Raven-1。
| 研究细节 | Griffin-Lite | Phoenix-4.5(此前) |
|---|---|---|
| 参与者 | 54 | 41 |
| 认为对方是真人 | 26(48%) | 1(2.4%) |
| 「认为是真人」置信度 | 79% | — |
| 「认为是 AI」置信度 | 81% | — |
| 产生怀疑的时间 | 前 20 秒内 | — |
| 「显得自然」(满分 7) | 5.4 | — |
| 「显得可信」(满分 7) | 5.6 | — |
| 「愿意再次交谈」(满分 7) | 5.8 | — |
| 「交谈流畅」(满分 7) | 4.9 | — |
有两个细节比通过率更重要。第一,两组都很有把握——说「真人」的人平均置信度 79%,说「AI」的人平均 81%,这正是研究希望看到的:没有人在猜。第二,超过一半的参与者表示这一可能性在通话中从未出现在脑海里,而这个群体几乎都后来认为对方是真人;那些确实起疑的人往往是在前 20 秒内。最后这一行是报告中最令人不安的结果,也应当左右你如何阅读安全部分。
这项研究也有真实的局限:它样本小(n=54)、时长短(一分钟)、且由 Tavus 自己进行。参与者被告知他们将见到另一位参与者,这预先让他们期待一个人;同时没有一组与真人交谈的对照,因此没有在同一协议下真人被判定为「真人」的频率基线。一分钟的通话不是一次客服会话、一小时的辅导或一场求职面试。
NVIDIA VideoFDB 分数
本次发布中最强的外部证据是 VideoFDB,由 NVIDIA(与 David AI)构建并评分,作为首个全双工视听对话基准。它由一个大语言模型评委,对来自真实视频通话的 237 段人工标注片段按 0–5 分打分,分为两条各有评分标准和榜单的独立赛道。Tavus 称 NVIDIA 于 2026 年 9 月使用自己的评委独立进行了评估——正是这种独立性,使得这些数字比 Tavus 自己的图灵研究更值得先拿来说。
| 生成赛道(行为是否正确) | 分数(0–5) |
|---|---|
| 人类基准真值 | 3.92 |
| Griffin-Lite | 3.83 |
| Gemini 2.5 + Anam(次高) | 2.80 |
| 感知赛道(是否理解当下情境) | 分数(0–5) |
|---|---|
| 人类基准真值 | 4.20 |
| Griffin-Lite | 3.73 |
| MiniCPM-o 4.5(最强基线,仅音频) | 3.44 |
| Gemini 2.5 Flash Native | 3.17 |
| OpenAI gpt-realtime | 2.97 |
Griffin-Lite 还取得了最高的接管率对齐——它的时机决策与参考对话的吻合程度——在生成赛道为 62.8%,在感知赛道为 73.8%。这些表格旁边应当放三条限定说明。
第一,与人类的差距是真实且具体的:生成赛道 0.09,感知赛道 0.47。Tavus 把生成差距表述为「比任何其他被测系统接近人类表现的程度高出 12 倍以上」,这是关于相对接近度的准确陈述——但比人类低 0.09 并不等于人类,而一个大语言模型评委也不是人。
第二,感知对比并非同类相比。最强的基线 MiniCPM-o 4.5 是按仅音频配置评分的,而 Griffin 还读取视频。NVIDIA 自己的论文发现,视听模型在这些自然对话片段上常常无法胜过其仅音频的对应版本,因此 Griffin 感知领先的一部分,衡量的是「有眼睛」的价值,而此时对手没有。
第三,一次基准运行不是一次部署。NVIDIA 的协议给每个系统相同的任务和相同的评委;它对通话的第九个小时,或两个人整整一分钟互相抢话时会发生什么,什么也没说。
延迟与视觉质量
对于视频生成器本身,Tavus 在音到视频的设置中把 Griffin-Lite 与四个已发布的流式扩散模型做了对比:每个模型拿到语音和一张参考图,必须生成会说话的面孔。
| 指标 | Griffin-Lite | 结果 |
|---|---|---|
| 音到视频延迟(H100) | 平均 0.43 秒 | 次快方法的一半 |
| 感知质量(DOVER) | 5 个中第 1 | 最佳 |
| 分布保真度(FID) | 5 个中第 1 | 最佳 |
| 说话头评测(THEval) | 5 个中第 1 | 明显最佳 |
| 唇形同步置信度(LSE-C) | 7.27 | 5 个中第 2 |
LSE-C 这一行需要仔细对待,因为 Tavus 自己指出了其中的注意事项:LSE-C「奖励明显的嘴部运动,包括运动到看起来已不自然、而 THEval 会考量的程度」。换句话说,Griffin 只排第二的那个指标,正是一个能被夸张嘴部动作刷高的指标——而这正是社区对这次发布最常见的视觉批评。与 VideoFDB 赛道不同,这些质量数字是 Tavus 自己的测量,且对比的基线由它自己挑选。
安全暂缓
Tavus 明确表示,让 HIM 成为优秀交互界面的那些特性,同样使它成为优秀的欺骗工具。官方页面的表述是:「让 Human Interaction Models 成为人机自然沟通强大界面的那些特性,也允许它们欺骗一个人,使其相信它不是 AI。」它补充说,「安全发布需要进一步的对齐与安全程序」,Tavus 正在开发「安全的披露功能」,并正在与致力于 AI 安全的组织合作。
发布决定由此而来。Griffin-Lite 仅作为研究预览版提供给少数受信任的测试者,现阶段不会向客户开放使用;访问需通过申请表。Tavus 称它预计「在这些安全顾虑得到解决后很快就会发布 Griffin」,并且 Griffin「尚未上架 Tavus 平台」——它会在「我们想清楚如何安全发布之后」到来。鉴于一场实时样本中近一半人无法分辨,而那些能分辨的人大多在二十秒内就看了出来,一个能在随意对话中存活的披露机制绝非可有可无。
Because it’s the first model that can be mistaken for a real person, Griffin requires safety considerations before it can be released publicly. The full research preview covers how it works, how we tested it and the safety measures that have to come first.
— @tavus 2026 年 10 月 1 日
社区怎么说
这次发布引发了巨大反响——仅首条帖子在约一天内就有约 29,500 个赞、3,200 次转发和 1,180 万次浏览(11.8M)——回复分成可以辨认的阵营。这些是社区反应,而非已核实的事实,之所以收录,是因为它们显示了压力点在哪里。用户名为其在 X 上的显示形式。
怀疑者大声质疑这项研究。点赞最高的批评回复直接否认 48%:@willjciolino 写道「48% 的人认为自己是在和真人说话,这个概率是 0」,并说这「在头半微秒就一眼看穿了」。另一条帖子认为结果实际上等于随机:@Acezhang01 写道「48% 基本就是抛硬币……披露不再是可选项」。
谨慎派把它读作一道阈值被跨过。@WorldianAI 写道「一步从 3% 以下跳到 48%,这才是让我在意的地方,哪怕这是公司自己的测试」,并且「实时视频通话是我们大多数人仍然信任、用来证明另一端有真人的最后一样东西」。在点赞最高的回复之一(超过 1,300 赞)中,@mayfer 更进一步:「我觉得我们大概应该通过一条法律让它非法。不过实时卡通角色我还是能接受的。」
赞叹派聚焦于这次跃升。@heyorvian 写道「我试用时真的不敢相信自己不是在和真人说话,这才是真正的 HIM :)」;@mihuq 写道「它让我起鸡皮疙瘩,看起来太真了。哇。」
跨越各阵营,有一条技术批评反复出现:嘴巴和唇形同步。@LLMJunky(约 730 赞)写道「嘴部动作挺怪的。不过很酷,这会是它最差的状态。我不同意它看起来像真人。接近,但还差一点」。一个更温和的版本来自 @kusailatalit:「唇形动作和整体延迟都还有点工作要做,但看起来已经很疯狂了!gg」。这正是基准显示 Griffin 在 LSE-C 唇形同步上只排第二而非第一的那个维度——群众和指标意见一致。
玩笑也是记录的一部分——@litcapital 问 Griffin 能否「去酒吧……下班后一起灌啤酒」——反乌托邦式框架同样如此,来自 @tedbjorling:「科幻正在我们眼前展开。或者反乌托邦。不确定。」Tavus 以同样的口吻回复了其中许多,那句「Griffin Lite :)……看看我们在怎么改进 Griffin Lite」的预告就出自这里。社区反应**没有**提供的是独立验证:本文找到的任何回复、引用或讨论都没有复现这项研究或运行该基准。
可用性与定价
可用性是今天最关键的约束:没有办法购买或调用 Griffin。没有模型标识、没有端点、没有速率限制、没有 SLA、没有地区清单、也没有公开价格。Tavus 把今天就想构建的人引向「150,000 名开发者和企业已经在用」的模型——Phoenix、Raven 和 Sparrow——它们是前代产品,而非 Griffin。
作为参照,Tavus 现有的 Conversational Video Interface 平台在 tavus.io/pricing 上有一份公开但混乱的价格表(2026 年 10 月 2 日核对)。展示的开发者档包括一个含 25 分钟对话视频的免费档,以及一个 $59/月、含 100 分钟、超出部分 $0.37/分钟的 Starter 档;同一页面还显示了另一组与前者重叠的套餐块(包括 $22 的 Starter、$397 的 Growth 和 $975 的 Business)。这些套餐都不包含 Griffin。任何针对 Griffin 本身给出的数字都是编造的——Tavus 一个都没有发布。
| 选项 | 你能得到什么 | 包含 Griffin? |
|---|---|---|
| Griffin-Lite(研究预览版) | 仅少数受信任测试者,通过申请表 | 这就是 Griffin |
| Tavus Free(开发者) | 25 分钟对话视频、5 分钟视频生成、25 个库存数字人 | 否 |
| Tavus Starter($59/月) | 100 分钟对话视频、每月 3 个自定义数字人 | 否 |
| Tavus Growth($397/月) | 1,250 分钟对话视频、100+ 库存数字人 | 否 |
| Tavus Enterprise | 定制、白标、SLA | 否 |
局限
有五处缺口横在发布与任何真实部署决策之间。
- 图灵研究样本小且由公司自run。n=54、一分钟通话、没有独立复现、没有真人对照臂。48% 是一个引人注目的信号,不是一个已确立的人群估计。
- 感知领先部分是比较方式的产物。Griffin 能看到视频;它最强的基线是按仅音频评分的。NVIDIA 自己的论文指出,能看见并不等于会利用所看见的。
- 长会话行为未经核实。Tavus 称生成器经过训练以使长滚动不漂移,但它没有发布任何超过一分钟的会话结果。真实对话会进行 10 到 60 分钟。
- 安全文件缺失。发布时没有公开的模型卡、能力阈值评估或滥用评估。
- 定价与访问未定义。没有任何东西可供评估成本、规模化延迟或可靠性,因为一个都没被提供。
对智能体开发者的意义
撇开访问问题,这次发布仍然改变了你应当如何思考实时智能体。
时机是区分点,而非保真度。发布中最有用的数字不是 48%——而是一个衡量智能体何时行动、而不只是它说什么的基准(VideoFDB)如今存在了。轮次管理、给予回应和处理打断都是可测量的,而整个领域——包括前沿实时模型——在这些方面都远低于人类。如果你在构建语音或视频智能体,这就是值得埋点测量的维度。
全双工是架构,而非一个功能开关。你无法把持续回应硬加到「转写 → LLM → 合成」的级联之上。Griffin 的招牌行为源自于在同一循环中从同一个控制信号生成语音和视频。如果你的产品依赖打断或非言语线索,级联会从结构上限制你。
为阶梯而设计,而非为这次发布而设计。Tavus 自己的回复预告了「Griffin Lite」和它背后一个更大的模型,而平台现有的技术栈才是今天任何可发布产品所在之处。继续基于有文档记录的模型构建,并追踪 Tavus 平台上出现 Griffin 那一行的时刻。
把披露当作产品需求。这个领域的每一个严肃参与者——包括 Tavus——如今都说披露工具必须先于发布。如果你的智能体可能被误认为真人,那么可研究的失败模式不是「它是否骗过了用户」,而是「用户是否能够可靠地查明真相」。
常见问题
什么是 Tavus Griffin?
Griffin 是 Tavus 的首个 Human Interaction Model(HIM):一个全双工、视频到视频的系统,它感知一个人的音频和视频,决定何时以及如何回应,并同时生成语音和视频。Tavus 称它是首个通过实时视频图灵测试的模型。
Griffin 真的通过了图灵测试吗?
在 Tavus 自己的实时研究中,54 名参与者中有 26 人(48%)在一分钟视频通话后认为 Griffin-Lite 数字人是真人,而在 Tavus 此前的技术栈上是 41 人中的 1 人(2.4%)。这是一个引人注目的结果,但它来自一项样本小、时长短、由公司自run、没有独立复现也没有真人对照臂的研究。
NVIDIA 的基准测量了什么?
NVIDIA 的 VideoFDB 是首个全双工视听对话基准,由一个大语言模型评委对来自真实通话的 237 段片段按 0–5 分打分,分两条赛道。Griffin-Lite 在生成赛道得 3.83(人类 3.92),在感知赛道得 3.73(人类 4.20),在已发布基线上两项均为第一。
我今天能用 Griffin 吗?
不能。Griffin-Lite 是面向少数受信任测试者的研究预览版,需通过申请表获取。它尚未上架 Tavus 平台,没有公开的模型标识、端点或定价,Tavus 称现阶段不会向客户开放使用。
Griffin 多少钱?
Tavus 没有发布 Griffin 的任何价格,你看到的任何针对它的报价都是编造的。Tavus 现有的 Conversational Video Interface 平台在 tavus.io/pricing 上单独定价,且不包含 Griffin。
什么是 Human Interaction Model?
Tavus 把 HIM 定义为「一类旨在理解并生成面对面的实时人类交互的新型模型」。在实践中,它意味着一个在说话时聆听、读取表情和停顿、并生成整个视频画面的系统——而不是串联起彼此独立的语音、语言和数字人模型。
Griffin 是全双工的吗?
是的。Griffin 以规律的亚秒级间隔评估对话,可以在对方仍在说话时给予回应、点头或接过话轮,同时使用音频和视频——而不是等用户停下来。
为什么 Griffin 还没发布?
因为让它成为优秀界面的那种真实感,同样使它具有欺骗性。Tavus 称在发布前需要进一步的对齐与安全程序,包括「安全的披露功能」,并称正在与 AI 安全组织合作。
对这次发布的批评是什么?
社区最常见的批评是嘴巴和唇形同步质量——这正是基准显示 Griffin 在 LSE-C 上只排第二而非第一的那个维度。评论者还质疑了研究的样本小和由 Tavus 进行的方法学,也有不少人主张一个如此逼真的模型需要强制性披露。
Griffin 与 Phoenix、Raven 和 Sparrow 有何不同?
Phoenix、Raven 和 Sparrow 是 Tavus 现有的分工模型——面部渲染、感知和轮次管理——以级联方式串联。Griffin 把感知、对话决策和生成合并进一个实时视频到视频的系统。现有的这三款是你今天可以基于其构建的产品。
来源
来源核对日期:2026 年 10 月 1–2 日。
- Griffin: The First Human Interaction Model — Tavus(官方产品与研究页面;所有能力、研究和基准主张)
- VideoFDB — NVIDIA 及论文(基准定义、基线、人类参考)
- Tavus 在 X — 发布线程(Simon Says、全双工、魔方辅导、安全;上文嵌入帖为部分引用)
- Plans and Pricing — Tavus(现有平台档位;核对以确认 Griffin 未被列出)
- 发布线程上的社区回复,已在上文内联链接;作为有署名的反应引用,而非已核实事实。
延伸阅读:Gemini 4 Argon 完整指南、OpenAI DevDay 2026 回顾、GPT-6.1 Sol 指南,以及Codex Security Cloud 指南。