简短回答
Kimi K3.1 Pro 是 Moonshot AI 于 2026 年 10 月 23 日发布的 Kimi K3 后训练升级版:2.8T 总参数、104B 激活参数的混合专家模型,上下文窗口 1M token,API 价格为每百万输入 token $2.00、每百万输出 token $10.00、每百万缓存命中输入 token $0.20。Highspeed 版号称快 2–3 倍,常规输入与输出价格恰好翻倍,缓存命中价格不变。Moonshot 表示完整权重将在 2026 年 11 月 4 日前发布。截至 2026 年 10 月 29 日,该模型的 Hugging Face 仓库无法公开访问。
在 Moonshot 自己的 14 面板图表上,该模型在六行领先、五行第二、两行第三、一行第四,对比对象是 Claude Opus 5.5、Claude Fable 5.1、GPT-6 Astra、DeepSeek V4.1 Flash 1017 与 GLM-5.3。独立评测机构 Artificial Analysis 在发布时将其排在智能指数第四,得分 55,并给出其有史以来最高的 Terminal-Bench 4.0 成绩 67%。几天后 Artificial Analysis 切换到指数 v5,该模型得分 46,在这套标尺上是排名第一的开放权重模型,权重尚未发布。
本指南基于一手来源:Moonshot 技术博客、Kimi 定价页、API 快速上手文档、速率限制页面以及 X 上的发布帖,另有两个独立来源:Artificial Analysis 与 OpenRouter 的模型页。所有数字均在 2026 年 10 月 28–29 日核对。凡来自 Moonshot 的数字均标注为 Moonshot 自报,本站没有复现任何结果。关于更早的 K3 发布及其开放权重背景,可参阅我们的 Kimi K3 开放前沿智能(英文)一文。
发布帖子
Moonshot 官方账号于 10 月 23 日 17:15(UTC)发布了公告。主帖称该模型为“我们迄今最强的 3T 级开放权重模型”,并在同一段落里列出规格:1M token 上下文、2.8T 总参数与 104B 激活参数、多模态输入、在 Unreal、Unity 和 Godot 中完成整项目编程、在 Blender 与 CAD 中做参数化 3D 建模,以及幻觉“降低 65%”的金融工作。帖子最后一句对开发者最关键:“Open weights by Nov 4, 2026.”我们抓取时该帖浏览量约 406 万。
Introducing Kimi K3.1 Pro: our most capable 3T-class open-weight model. 1M-token context, 2.8T total / 104B active params (MoE), Multimodal. Open weights by Nov 4, 2026.
— @Kimi_Moonshot 2026 年 10 月 23 日
帖子中的 65% 是对博客里一项主张的取整:在 Moonshot 内部的 Kimi Hallu Bench Hard 上,声明级幻觉率从 K3 的 23.4% 降到 K3.1 Pro 的 8.3%(相对下降 64.5%)。博客补充说明,该基准是为诱发错误而设计的压力测试,这些比率“并不代表日常使用中的整体错误率”。这条限定应当紧跟在这个醒目数字旁边。
四秒之后,该账号发布了带定价卡片的 API 公告,卡片在下方定价一节中转载。
K3.1 Pro API and K3.1 Pro Highspeed (2-3× faster), both available now at platform.kimi.ai.
— @Kimi_Moonshot 2026 年 10 月 23 日
发布了什么、在哪里用
博客把 K3.1 Pro 描述为“Kimi K3 的后训练版本,后训练算力大幅增加”,并称其为新 K3.1 系列的第一个模型。Moonshot 把提升归因于数百个下游领域上的联合强化学习,以及在 RL 框架、长上下文推理、沙箱与 rollout 调度上的基础设施工作。因此基础架构仍是 K3 的架构,变化的是预训练之后的训练。这一定位决定了合理预期:这是同等规模下的能力升级,而不是新的模型级别。
博客列出了五条使用路径。每一条都是不同的产品、不同的计费方式,比较价格之前最好先把它们分开。
| 路径 | 是什么 | 如何使用 K3.1 Pro | 计费 |
|---|---|---|---|
| Kimi.ai 与移动应用 | 网页、iOS、Android 与 HarmonyOS 上的聊天与 Kimi Agents | 更新应用或打开 kimi.ai | 会员(免费版用量有限) |
| Kimi Work | 面向 Windows 与 Apple 芯片 Mac 的桌面智能体应用 | 3.1.0 或更高版本 | 会员 |
| Kimi Code | 编码智能体 CLI、VS Code 与桌面端 | 用 /model 命令选择模型 | 会员额度(Plus 及以上) |
| Kimi API | platform.kimi.ai 上的按量付费 API | 模型 ID kimi-k3.1-pro 与 kimi-k3.1-pro-highspeed | 按 token 单独计费 |
| Kimi Business / Enterprise | 带成员管理的团队方案 | 企业管理员必须启用;发布时默认关闭 | 组织套餐 |
博客里有两处细节容易漏掉。API 客户可使用零数据留存(Zero Data Retention);Kimi 企业版管理员必须为组织手动开启该模型,因为默认是关闭的。若想了解同一家族的桌面智能体,可参阅我们的 Kimi Work 桌面智能体(英文)一文,它介绍的是更早的产品。
定价与成本测算
API 定价在整个上下文窗口内是统一的,没有长上下文加价档。下表取自 Moonshot 定价页,Moonshot 在 10 月 24 日核对了价格,页面更新于 10 月 26 日。两个模型都标注了 1,048,576 token 的上下文窗口。
| 模型 ID | 输入 | 输出 | 缓存命中输入 | 缓存写入(5 分钟) | 缓存写入(1 小时) |
|---|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 / MTok | $10.00 / MTok | $0.20 / MTok | $2.00 / MTok | $4.00 / MTok |
| kimi-k3.1-pro-highspeed | $4.00 / MTok | $20.00 / MTok | $0.20 / MTok | $4.00 / MTok | $8.00 / MTok |
| kimi-k3(对照) | $3.00 / MTok | $15.00 / MTok | $0.30 / MTok | 未列出 | 未列出 |
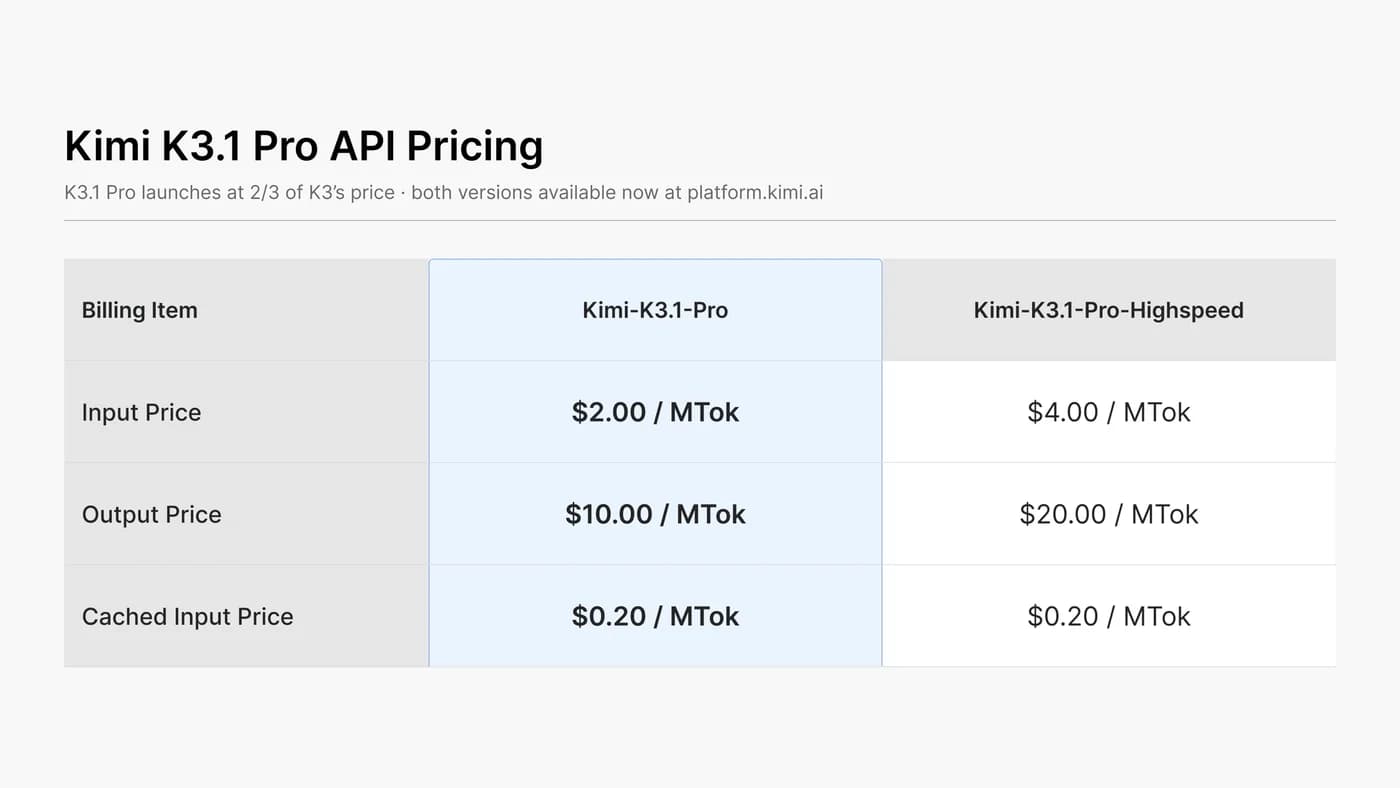
Highspeed 把常规输入、输出与缓存写入价格翻倍,缓存命中价格保持不变。这种不对称决定了智能体循环的经济性:长编码会话里大多数输入 token 是命中缓存的重复上下文,所以 Highspeed 的溢价主要落在输出上。下面的示例只使用已公布的价格;token 数是示意性假设,不是实测。示例把未命中缓存的部分按 5 分钟缓存写入计,其价格在两个模型上与常规输入相同。
| 场景(假设的 token 数) | kimi-k3.1-pro | Highspeed | kimi-k3 对照 |
|---|---|---|---|
| 小型智能体步骤:8K 输入,其中 2K 缓存命中,1.5K 输出 | $0.0314 | $0.0624 | 未计算 |
| 长编码任务:30K 输入、270K 缓存命中、20K 输出 | $0.314 | $0.574 | $0.471 |
| 同一任务无缓存命中:300K 输入、20K 输出 | $0.800 | $1.600 | 未计算 |
| 重度会话:100K 输入、900K 缓存命中、60K 输出 | $0.980 | $1.780 | 未计算 |
| 仅输出下限:55K 输出 token(Artificial Analysis 每任务平均值) | $0.55 | $1.10 | 未计算 |
由此得到两点结论。第一,缓存比选哪个模型更值钱:同一个长任务命中缓存时花 $0.314,不命中时花 $0.80,相差 2.5 倍,而缓存命中任务上的 Highspeed 溢价只有 $0.26。第二,在缓存命中的长任务上,Highspeed 的成本是标准版的 1.83 倍而不是 2 倍,因为 $0.20 的缓存命中价没有翻倍。Moonshot 自己的页面也建议对缓存占比高的请求单独核算,而不是把标准账单直接翻倍。输出长度是另一个杠杆:输出是最贵的 token 类别,而快速上手文档写明 K3.1 Pro 始终开启思考,reasoning_effort 可取 low、high 或 max,默认为 max。对简单任务降低思考强度是削减输出 token 最直接的办法,但 Moonshot 没有公布这会损失多少质量。
在消费端,Moonshot 列出个人套餐:按年付费折算为每月 $15(Plus)、$31(Pro)、$79(Max)和 $159(Ultra)。Kimi Code 从 Plus 起可用,Highspeed 从 Pro 起包含。会员不能替代 API 计费,API 的 token 另外收费。更广泛的编码模型价格对比,参见我们的最便宜的 AI 编码模型(英文)汇总。
基准成绩(按来源标注)
下图是 Moonshot 的发布成绩单,随发布帖串一起发布。图上的一切都是 Moonshot 自报。博客脚注交代了做法:Kimi K3.1 Pro 的结果使用推理强度 max、温度 1.0、top-p 0.95,编码行使用 Claude Code 工具链。对于若干行,竞品分数按博客的说法取自“其博客文章或官方排行榜中报告的最大值”,或取自各厂商的系统卡或技术报告。图上自带的脚注写明:所有模型都开到最大思考强度,Claude 模型可能包含回退,GPT 模型可能包含网络安全防护(cyberguards)。
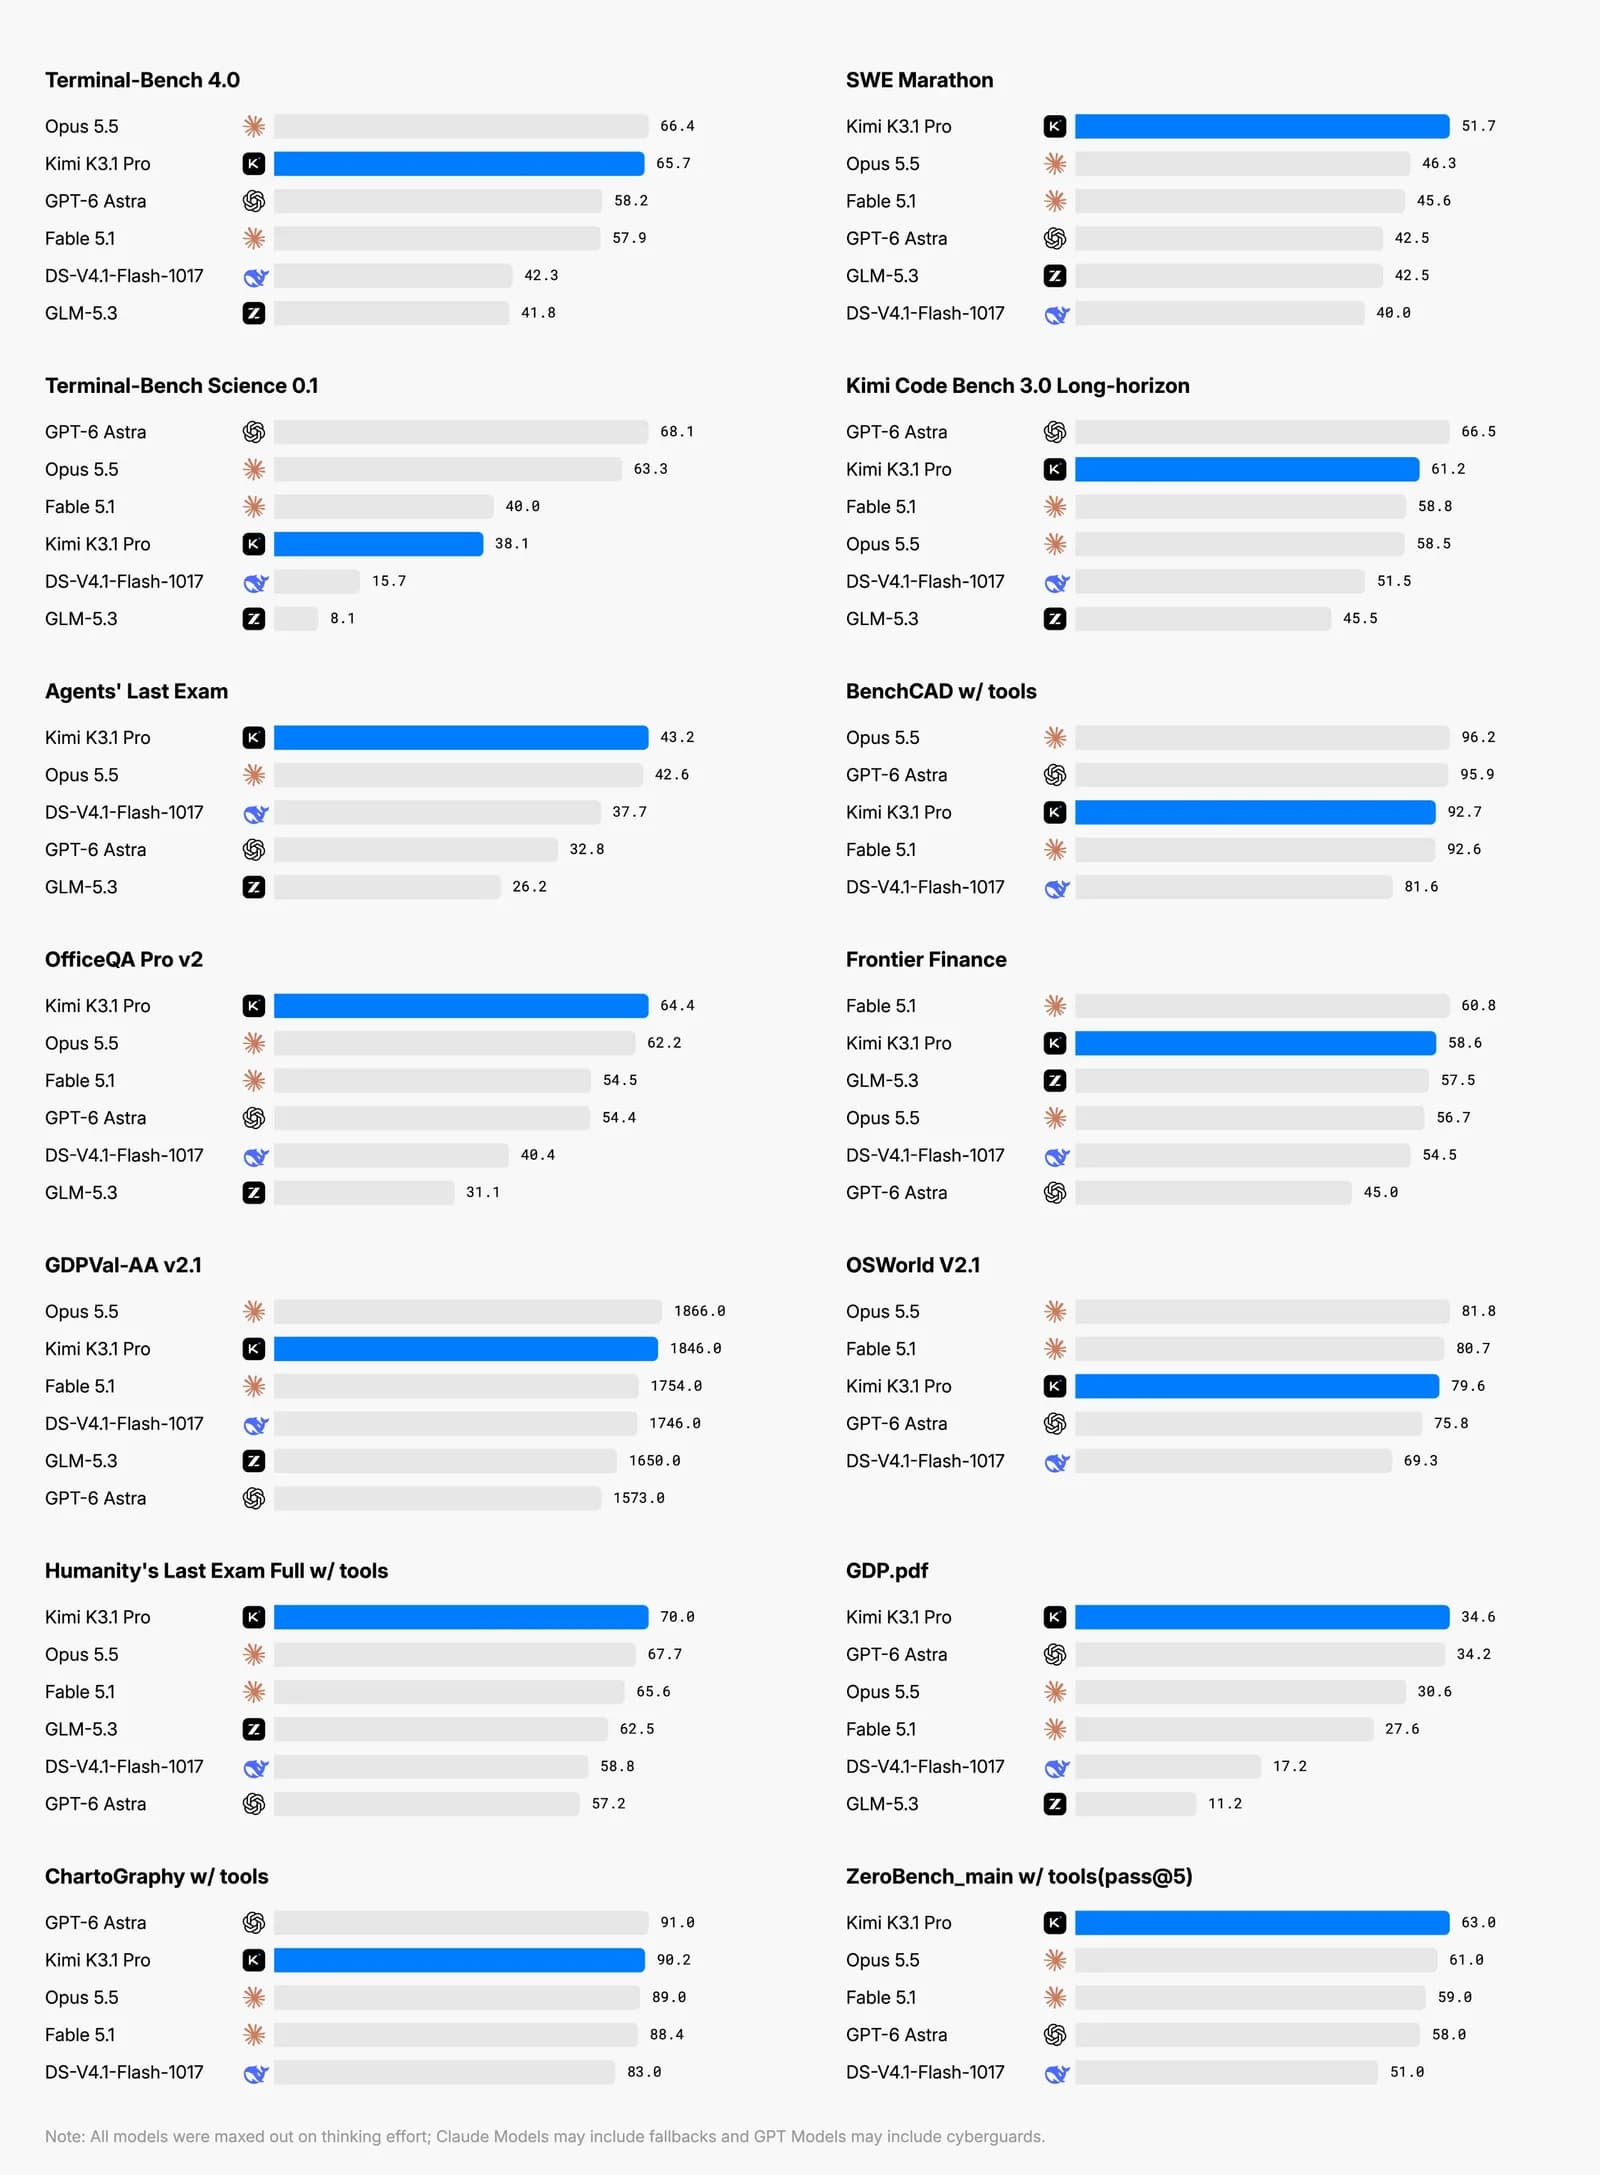
下表把每个面板转写成文字,便于检索与比较。数值读自图片;同时出现在博客正文中的 Terminal-Bench 4.0、Kimi Code Bench、BenchCAD、OfficeQA 以及 Opus/Astra 数字与图上一致。“排名”指 Kimi 在该面板所示模型中的位置。
| 面板 | Kimi K3.1 Pro | 所示其他模型最高 | Kimi 排名 | 备注 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | Opus 5.5 66.4 | 6 个中第 2 | GPT-6 Astra 58.2;Claude Code 工具链 |
| Terminal-Bench Science 0.1 | 38.1 | GPT-6 Astra 68.1 | 6 个中第 4 | 按脚注,DeepSeek 分数为较旧版本 |
| SWE Marathon | 51.7 | Opus 5.5 46.3 | 6 个中第 1 | Opus 紧随其后 |
| Kimi Code Bench 3.0 Long-horizon | 61.2 | GPT-6 Astra 66.5 | 6 个中第 2 | Moonshot 内部基准;K3 为 55.95 |
| Agents’ Last Exam | 43.2 | Opus 5.5 42.6 | 5 个中第 1 | 122 个任务;在线获取答案的运行记零分 |
| BenchCAD w/ tools | 92.7 | Opus 5.5 96.2 | 5 个中第 3 | GPT-6 Astra 95.9 |
| OfficeQA Pro v2 | 64.4 | Opus 5.5 62.2 | 6 个中第 1 | Moonshot 称其为当前最优 |
| Frontier Finance | 58.6 | Fable 5.1 60.8 | 6 个中第 2 | Moonshot 称较 K3 有提升 |
| GDPVal-AA v2.1 | 1846 | Opus 5.5 1866 | 6 个中第 2 | Elo,引自 Artificial Analysis |
| Humanity’s Last Exam,完整版,带工具 | 70.0 | Opus 5.5 67.7 | 6 个中第 1 | 与 Artificial Analysis 的 HLE 协议不同 |
| OSWorld V2.1 | 79.6 | Opus 5.5 81.8 | 5 个中第 3 | 未显示 GLM-5.3 |
| ChartoGraphy w/ tools | 90.2 | GPT-6 Astra 91.0 | 5 个中第 2 | 五次运行平均 |
| GDP.pdf | 34.6 | GPT-6 Astra 34.2 | 6 个中第 1 | 严格通过率 |
| ZeroBench w/ tools (pass@5) | 63.0 | Opus 5.5 61.0 | 5 个中第 1 | 五次运行平均 |
数一数行数,图景很直接:Kimi 在十四个面板中领先六个、第二五个、第三两个、第四一个。领先的行集中在长周期软件工作(SWE Marathon)、文档与金融任务(OfficeQA Pro v2、GDP.pdf)、智能体考试以及带工具的多模态推理;落后的行集中在以终端驱动的科学工作、CAD 生成和计算机操作。Moonshot 自己的行文比图表更谨慎:博客说 K3.1 Pro“匹敌或接近最强的专有模型”,这与表格相符,并把 Terminal-Bench 4.0 描述为“略落后于 Claude Opus 5.5”。
复用这张表之前有三点提醒。其一,多个面板混用了不同的评测来源:Moonshot 自己跑 Kimi,部分竞品数字取自排行榜或系统卡,所以一两分的差距落在不同工具链造成的噪声之内。其二,Kimi Code Bench 是 Moonshot 自己的基准,它对了解 Kimi Code 产品有参考价值,但作为独立比较的说服力较弱。其三,有一行(GPT-6 Astra 在 OfficeQA Pro v2 上)是在 Codex 里跑的,而其他行用的是 Claude Code,博客对此有说明。只有同时比对脚注时,才能比较各行。
独立证据
Artificial Analysis 在 10 月 23 日发布了发布日文章,并在 10 月 27 日宣布了智能指数 v5。两者使用不同的指数,因此标题数字不可互换。
| 指标 | 结果 | 指数版本 | 来源 |
|---|---|---|---|
| 智能指数,发布日文章 | 55,第 4 名;Claude Opus 5.5 为 58,Sonnet 5.5 为 56,Muse Wonder Full 为 56;K3 为 44 | v5 之前 | Artificial Analysis 发布日文章 |
| GDPval-AA | 1,846 Elo,第 3 名,较 K3 提高 312 Elo;Opus 5.5 为 1,866,Muse Wonder Full 为 1,857 | v5 之前 | Artificial Analysis 发布日文章 |
| Terminal-Bench 4.0 | 67%,Artificial Analysis 所列所有模型中最高;K3 为 13%;Sonnet 5.5 为 64% | v5 之前 | Artificial Analysis 发布日文章 |
| AutomationBench-AA | 73%,此前为 58% | v5 之前 | Artificial Analysis 发布日文章 |
| Humanity’s Last Exam | 52%,此前为 47% | v5 之前 | Artificial Analysis 发布日文章 |
| AA-Omniscience 指数 | 30,此前为 20;幻觉率 44%(此前 53%),准确率 51%(此前 48%) | v5 之前 | Artificial Analysis 发布日文章 |
| 每个指数任务的成本 | $1.98,每任务 55K 输出 token;K3 为 48K,即 token 多 14%、价格低 33% | v5 之前 | Artificial Analysis 发布日文章 |
| 智能指数 v5 | 46,权重尚未发布的排名第一开放权重模型;Opus 5.5 以 58 领先 | v5(10 月 27 日) | Artificial Analysis v5 公告 |
| Terminal-Bench-Science(v5) | 34%;Astra 为 63%,Opus 5.5 为 59% | v5 | Artificial Analysis v5 公告 |
| HLE-Diamond(v5) | 37%;Opus 5.5 为 68% | v5 | Artificial Analysis v5 公告 |
| CritPt v2(v5) | 45%;排名第一的开放权重模型;Astra 以 72% 领先 | v5 | Artificial Analysis v5 公告 |
有三点值得注意。第一是在核心强项上的一致:Moonshot 的图表在 Claude Code 工具链下给出 Terminal-Bench 4.0 为 65.7,Artificial Analysis 用自己的配置测得 67%,并称其为所跟踪模型中的最高分。两种不同工具链的结果相差 1.3 分,是目前最有说服力的交叉验证。第二是成本这一行:输出 token 多 14%、价格降 33%,得到的每任务成本与 K3 大致相同,这才是这里“更便宜”的实际含义。Artificial Analysis 明确说 K3.1 Pro 每任务成本与前代差不多,而不是更低。
第三是两个指数之间的落差。在发布时的指数下,该模型以 55 排第四,比 Opus 5.5 低三分。在 v5 下(Artificial Analysis 说其中 60% 使用私有数据集),得分为 46,与领先者相差 12 分。Artificial Analysis 把 v5 描述为方法论变更,所以分数下降是重新标定,并不意味着模型变差。但它确实说明,“接近前沿”这一判断取决于使用哪组基准,而 v5 中最大的差距出现在 Terminal-Bench-Science 与 HLE-Diamond 上。这与 Moonshot 图表一致:Terminal-Bench Science 正是 Kimi 排第四的那一行。
网络安全管控
博客用很长的篇幅谈网络安全,这是此次发布里最不寻常的部分。Moonshot 说它在通用的中期训练语料和强化学习环境组合中发现了网络安全相关内容,为开放权重版本在这两个阶段都将其移除,并在内部 xdev-bench-hard 基准上测量了影响。该基准使用专家整理、基于源代码的漏洞发现与利用任务,大多是复现近期披露的漏洞,涉及 Linux 内核、Node.js、JavaScriptCore、Exim 与 VirGL 等软件,并开启了缓解措施。结果为 pass@3。
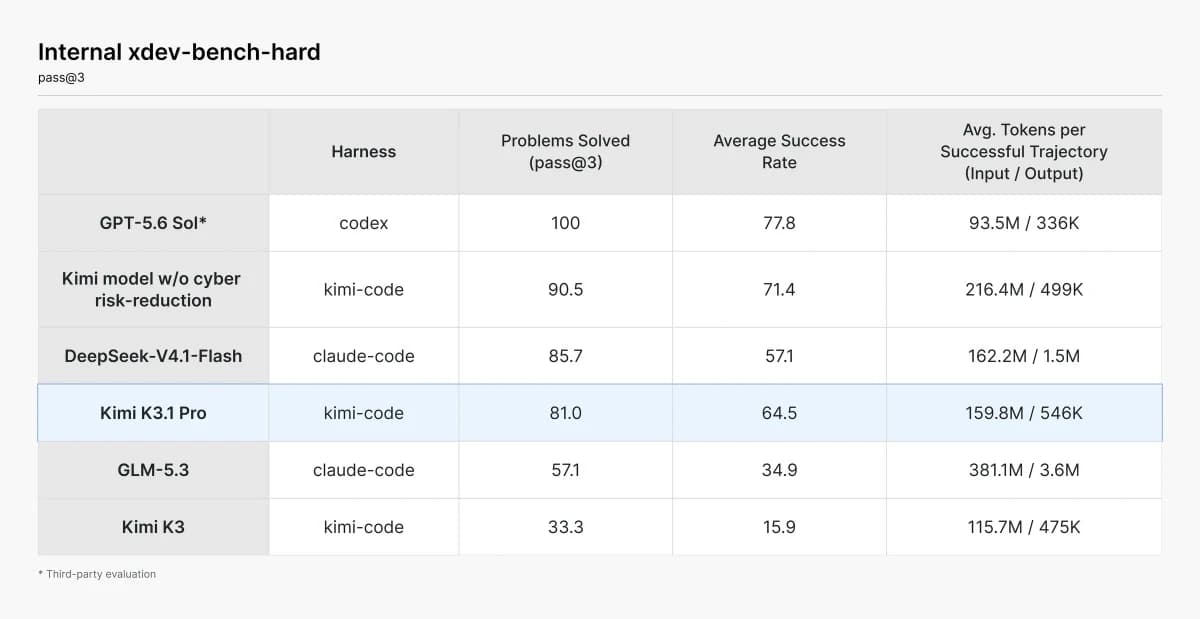
Moonshot 在正文里给出的数字很明确:没有风险缓解措施的检查点在 pass@3 上解出 90.5% 的问题;最终的 K3.1 Pro 解出 81.0%。最终模型远高于 K3(图中为 33.3%),Moonshot 据此认为,更强的通用编码与长周期调试能力即便在数据移除之后也会迁移到网络安全任务上。Moonshot 还说,该模型的网络安全能力“仍落后于已公开可用至少三个月的前沿专有模型”,并陈述了其开放权重原则:不发布会推高网络安全能力绝对前沿的权重,同时逐步提高开放权重所能提供的水平。
对构建者而言,实际意义有限。这是单一内部基准,各行的工具链不同,评估方就是开发方,而且权重尚不可得,没人能验证这一说法。它作为意图的声明、以及 Moonshot 自家检查点之间的比较是有用的,其中 90.5 对 81.0 的受控差异是最干净的证据。作为“已发布权重在任何具体部署中都安全”的证据则较弱。
API 快速上手
Kimi 快速上手文档用 OpenAI Python SDK 调用 Moonshot 兼容 OpenAI 的端点。你需要一个 Kimi API 平台的密钥,并且按速率限制页面的说明,账户至少充值 $1 才能调用 API。下面的代码段遵循 Moonshot 的示例,并显式设置了 reasoning_effort。
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)

completion = client.chat.completions.create(
    model="kimi-k3.1-pro",          # or "kimi-k3.1-pro-highspeed"
    reasoning_effort="high",        # low | high | max (default: max)
    messages=[{"role": "user", "content": "Introduce Kimi K3.1 Pro in one sentence."}],
)
print(completion.choices[0].message.content)
用 cURL 发出同样的请求:
curl https://api.moonshot.ai/v1/chat/completions \
  --header "Authorization: Bearer $MOONSHOT_API_KEY" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "kimi-k3.1-pro",
    "messages": [{"role": "user", "content": "Introduce Kimi K3.1 Pro in one sentence."}]
  }'
快速上手文档里有几项行为在实践中很重要。K3.1 Pro 始终开启思考,流式响应会分别返回 reasoning_content 与最终答案 content 增量。多轮对话和工具调用时,文档说要把 API 返回的完整 assistant 消息加入下一次请求,而不是只保留 content;在自己手写的循环里,丢掉推理部分是工具调用行为变差最可能的原因。输入计量遵循定价页:缓存命中、缓存写入与未缓存 token 互斥,加起来等于总输入,所以用量字段可以让你逐行核对账单。
在编码智能体中使用
Moonshot 为 K3.1 Pro 记录了两种工具链集成。两者都是一手说明;本站均未实际运行过。
| 工具链 | 端点与模型 ID | 关键设置 | 来源 |
|---|---|---|---|
| Claude Code(Kimi Code 路径) | ANTHROPIC_BASE_URL https://api.kimi.ai/coding/ ;模型 k3.1-pro(256K 上限)或 k3.1-pro[1m] | CLAUDE_CODE_SUBAGENT_MODEL 与自动压缩窗口设为 262144 或 1048576 | Kimi Code 文档 |
| Claude Code(平台路径) | ANTHROPIC_BASE_URL https://api.moonshot.ai/anthropic ;示例模型 kimi-k3[1m] | ANTHROPIC_AUTH_TOKEN 携带 Kimi API 密钥;该指南的示例针对 K3,不是 K3.1 Pro | Kimi API 平台文档 |
| Codex | base_url https://api.moonshot.ai/v1 ;模型 kimi-k3.1-pro | wire_api = responses;model_context_window = 1048576 | Kimi API 平台文档 |
Kimi Code 页面为 1M 上下文配置给出了下面这份 settings.json。请把占位符换成你自己的密钥,修改后重启 Claude Code;Moonshot 说明配置方式只选一种,不要把设置文件和导出的环境变量混用。
{
  "env": {
    "ANTHROPIC_BASE_URL": "https://api.kimi.ai/coding/",
    "ANTHROPIC_API_KEY": "Your API Key",
    "ANTHROPIC_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_FABLE_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "k3.1-pro[1m]",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "k3.1-pro[1m]",
    "CLAUDE_CODE_SUBAGENT_MODEL": "k3.1-pro[1m]",
    "CLAUDE_CODE_EFFORT_LEVEL": "high",
    "CLAUDE_CODE_AUTO_COMPACT_WINDOW": "1048576",
    "CLAUDE_CODE_MAX_CONTEXT_TOKENS": "1048576"
  }
}
Kimi Code 页面把可用上下文与套餐挂钩:Plus 会员使用上限为 262,144 token 的 k3.1-pro,Pro 及以上为 1,048,576 token 上限,并可使用 k3.1-pro-highspeed。平台的 Claude Code 指南是面向按量付费密钥的另一份文档,我们读到的版本在示例里仍使用 kimi-k3[1m]。如果你走那个端点,请在依赖它之前用一次测试调用确认 K3.1 Pro 的模型 ID。对于 Codex,Moonshot 的指南给出了下面的提供方配置块,并说明 model_context_window 必须与 1M 窗口一致,否则 Codex 会回退到默认的模型元数据。
model = "kimi-k3.1-pro"
model_provider = "kimi"
model_context_window = 1048576

[model_providers.kimi]
name = "Kimi"
base_url = "https://api.moonshot.ai/v1"
env_key = "KIMI_API_KEY"
wire_api = "responses"
如果你已经在用别的模型运行 Claude Code,我们的 Claude Code 最佳实践指南讲解了工具链本身,2026 年最佳 AI 编码智能体(英文)则对比了可以和 K3.1 Pro 搭配的智能体。
OpenRouter
K3.1 Pro 在 OpenRouter 上的标识为 moonshotai/kimi-k3.1-pro,发布日期为 2026 年 10 月 23 日,上下文 1.0M。10 月 28 日抓取时,标准模型只有一条提供方路径,即 Moonshot AI,每百万 token 输入 $2.00、输出 $10.00、缓存读取 $0.20,延迟 4.56 秒、26 token/秒、可用率 100%。Moonshot AI Highspeed 标价 $4.00、$20.00 和 $0.20,延迟 4.36 秒、66 token/秒、可用率 99.97%。这些是市场平台的时点运营统计,不是基准测试,并且会变化。
页面上有两个数字值得当作真实使用的信号。OpenRouter 显示加权平均输入价格为每百万 token $0.3546,而标价是 $2.00,Moonshot 路径的缓存命中率为 91.4%。这与上面的成本测算一致:智能体流量以缓存上下文为主,所以人们实际支付的每输入 token 价格远低于标价。这也意味着,在只按标价比较 K3.1 Pro 与其他模型之前,应当先对你自己的缓存行为建模。Highspeed 路径的 66 token/秒对标准版的 26,在这份快照上约为 2.5 倍,落在 Moonshot 宣称的 2–3 倍范围内。
开放权重:发布了吗?
这个承诺具体且被反复提及。博客说完整权重“将在 2026 年 11 月 4 日前发布”,发布帖说“Open weights by Nov 4, 2026”,OpenRouter 与 Artificial Analysis 的页面都把该模型描述为开放权重,同时注明权重尚未发布。Artificial Analysis 预计权重一旦发布,它将成为领先的开放权重模型。
2026 年 10 月 29 日约 05:06(UTC),我们请求了 Hugging Face 页面以及 moonshotai/Kimi-K3.1-Pro 和可能存在的 Kimi-K3.1-Pro-Base 的 Hugging Face API。两者的页面和 API 都返回 HTTP 401。相比之下,更早的 moonshotai/Kimi-K3 页面返回 200,该组织最新仓库列表中有 K3、K2.7-Code 与 K2.6,没有 K3.1 条目。401 也可能表示私有或受限仓库,所以稳妥的结论只是:权重在当时尚不能公开下载,而 11 月 4 日的期限也还没到。我们没有找到权重的许可证文本、参数格式说明或硬件指南,因此这里不作陈述。在规划自托管部署之前,请在 11 月 4 日之后重新检查该仓库;无论许可证如何,2.8T 参数的模型都需要多节点基础设施。
再对“开放权重”一词补充一句提醒。Moonshot 说它“为开放权重版本”从两个训练阶段移除了网络安全相关数据。托管的 API 模型与发布的检查点都被描述为同一个 K3.1 Pro,但博客没有说明托管服务是否还附加了其他管控。API 与自托管副本之间的行为差异应当通过测试来确认,而不要想当然。
速率限制与订阅额度
API 速率限制取决于累计充值。下表来自平台限制页面;页面按账户应用限制,并说明当集群负载达到容量时,限制可能被临时调整。
| 档位 | 累计充值 | 并发 | RPM | TPM | TPD |
|---|---|---|---|---|---|
| Tier0 | $1 | 1 | 3 | 500,000 | 1,500,000 |
| Tier1 | $10 | 15 | 100 | 2,000,000 | 不限 |
| Tier2 | $20 | 40 | 100 | 3,000,000 | 不限 |
| Tier3 | $100 | 50 | 200 | 3,000,000 | 不限 |
| Tier4 | $1,000 | 60 | 200 | 4,000,000 | 不限 |
| Tier5 | $3,000 | 100 | 300 | 5,000,000 | 不限 |
代金券不计入累计充值,充值 $5 可获得 $5 代金券,页面还警告异常活动会触发无法解除的风控限制。超出限制会返回 HTTP 429,搜索端点会附带 X-RateLimit-* 响应头。限制页面没有按模型拆分限额,所以我们无法判断 K3.1 Pro 的上限是否低于平台上的其他模型。
订阅额度是另一套体系。Kimi Code 会员文档说,对新会员取消了每周额度限制,只保留滚动 5 小时速率窗口和每月总量,而旧套餐每七天刷新一次;同一账户下所有设备与 API 密钥共享一份额度,可以购买 Extra Usage 余额以便超出后继续使用。发布两天后,Moonshot 还发了一条道歉帖,如果你依赖订阅,这条帖子与你直接相关。
We’re sorry for the rate limits and unnecessary quota consumption on the K3.1 Pro subscription plan. These were our issues, and we should have fixed them sooner. Today, every subscriber on every plan gets a one-time usage reset, restoring 25% of their monthly quota.
— @Kimi_Moonshot 2026 年 10 月 25 日
帖子说这次重置恢复了 25% 的月度额度,“相当于一周的用量”,并说 Moonshot 调整了套餐参数,正在“减少不必要的子智能体调用和输出长度”。这是一手的承认:发布时的额度消耗高于预期,并且子智能体扇出是原因之一。如果你在订阅上运行智能体,请在 Kimi Code 控制台里跟踪消耗,并把第一周的数字视为尚不稳定。Codex 一侧的对应情况见我们的 Codex 用量耗尽与重置指南。
主张与证据对照表
每条核心主张、提出者,以及证据强度。
| 主张 | 提出者 | 证据 | 状态 |
|---|---|---|---|
| API 价格为每 MTok $2 / $10 / $0.20 | Moonshot 定价页与卡片 | 页面、卡片、OpenRouter 页面与 Artificial Analysis 一致 | 四个来源确认 |
| Highspeed 快 2–3 倍 | Moonshot | OpenRouter 快照:66 对 26 token/秒 | 相符,未经独立基准测试 |
| Terminal-Bench 4.0:65.7 对 Opus 5.5 的 66.4 | Moonshot 图表与博客 | Artificial Analysis 测得 67% | 已交叉验证 |
| 在发布图表十四个面板中领先六个 | Moonshot 图表 | Moonshot 自跑与厂商自报混合 | 厂商自报 |
| Artificial Analysis 智能指数 55,排第四 | Artificial Analysis | 独立;v5 之前的指数 | 独立,已被 v5(46)取代 |
| 幻觉降低 65% | Moonshot | 内部 Hallu Bench Hard,压力测试提示词 | 厂商自报,Moonshot 自己加了限定 |
| 移除网络安全数据使 xdev-bench-hard 从 90.5% 降到 81.0% | Moonshot | 内部基准,自家检查点 | 厂商自报 |
| 2026 年 11 月 4 日前开放权重 | Moonshot | 博客与发布帖;10 月 29 日仓库返回 401 | 承诺,暂无法验证 |
| 1M token 上下文 | Moonshot、定价页、OpenRouter、Artificial Analysis | 定价页为 1,048,576 token | 已确认;在 Kimi Code 中与套餐相关 |
| 2.8T 总参数、104B 激活参数 | Moonshot 发布帖、Artificial Analysis | 两个来源,无权重可检查 | 一致 |
选哪个版本、走哪条路径
决定主要取决于谁在等输出,以及你的提示词是否以缓存为主。
| 你的情况 | 选择 | 原因 |
|---|---|---|
| 批处理或后台智能体,没人在等 | API 上的 kimi-k3.1-pro | 常规输入与输出价格只有 Highspeed 的一半 |
| 对延迟敏感的交互式编码 | kimi-k3.1-pro-highspeed,或 Kimi Code 的 Pro 套餐 | 宣称快 2–3 倍;缓存命中价格与标准版相同 |
| 前缀长而稳定、以缓存为主的智能体循环 | 两者皆可;先算模型成本 | 两者缓存输入都是 $0.20,所以溢价主要在输出 |
| 已经标准化使用 Claude Code 或 Codex | 按上面的设置让工具链指向 Kimi | Moonshot 两者都有文档;先在自己的任务上测试 |
| 一把密钥通多个厂商 | OpenRouter 路径 | 标价相同;多一层路由,并有自己的延迟数字 |
| 需要自托管 | 等待权重发布 | 截至 10 月 29 日尚不可下载;先核实许可证与体量 |
| 使用托管套餐的团队 | Kimi Business | 企业管理员必须开启该模型;默认关闭 |
一份简短的评估计划能让决策立足于你自己的工作。第一步,挑二十个你已在运行的任务,组合上既要像 Kimi 领先的那些行(多文件的长周期软件修改、文档密集的金融或办公任务),也要像它落后的那些行(终端驱动的科学工作、CAD、GUI 自动化)。第二步,保持工具链不变;如果你在 Claude Code 里测 Kimi,就也在 Claude Code 里测对照模型。第三步,记录每个完成任务的成本,包括缓存命中,因为标价掩盖了最大的变量。第四步,对每个任务分别在 high 和 max 强度下运行,看多出来的思考是否划算。第五步,任何持有凭据或接触生产环境的智能体,都要为不可逆操作加上人工确认;发布材料里没有任何内容改变这条规则。
局限
- Moonshot 图表与博客上的每一个基准都是厂商自报。本指南读取了图片并把数值与博客正文交叉核对,没有重跑任何一项基准,也没有对该模型做过上手测试。
- 基准转写来自对渲染图片的阅读。同时出现在博客正文中的八个数值与图一致;其余数值无法与文字核对,xdev 表中除 81.0 与 90.5 之外的数值仅来自图片。
- 独立证据只有 Artificial Analysis,外加 OpenRouter 的运营统计。两篇 Artificial Analysis 文章使用不同的指数版本,不能直接比较。
- 开放权重状态基于 2026 年 10 月 29 日的一组请求。401 并不能证明仓库不存在,权重也可能在截止日期当天或之前随时出现。
- 没有找到权重的许可证、硬件要求、权重格式和模型卡。这里不作猜测。
- Claude Code 与 Codex 的配置抄自 Moonshot 文档,没有执行过。两份 Claude Code 指南使用不同的端点,平台指南的示例并不针对 K3.1 Pro。
- 订阅额度只能定性描述;我们读到的材料里没有公布每个套餐的绝对 token 额度,并且 Moonshot 在 10 月 25 日调整过套餐参数。
- 成本示例使用假设的 token 数与已公布的标价。你的账单取决于缓存命中率、思考强度,以及是否使用 1 小时缓存写入的加价。
结论
Kimi K3.1 Pro 是一款可信的近前沿编码与智能体模型,价格明确且低于前沿。最强的证据是 Moonshot 的 Terminal-Bench 4.0 数字与 Artificial Analysis 独立数字相互吻合,以及一项独立测量显示:价格下降三分之一的同时,每任务成本与 K3 大致相同。最弱的证据是 Moonshot 在自家基准上测得的一切,包括 Kimi Code Bench、幻觉数字与网络安全管控结果。开放权重承诺是最大的悬而未决之处:它具体且有日期,但在仓库公开之前无法判断。
如果你构建智能体,现在合理的做法是通过 API 或 OpenRouter 做一次有界的试用,使用考虑缓存的成本跟踪和你自己的任务,并在 11 月 4 日之后重新检查 Hugging Face 仓库。如果你需要自托管,请等权重发布并先读许可证。如果你依赖订阅,鉴于 10 月 25 日的道歉,头几周要留意自己的额度。
常见问题
Kimi K3.1 Pro 是什么?
Kimi K3.1 Pro 是 Moonshot AI 于 2026 年 10 月 23 日发布的模型,是 K3.1 系列的第一个。它是 Kimi K3 的后训练版本,拥有 2.8T 总参数、104B 激活参数、多模态输入与 1M token 上下文窗口。
Kimi K3.1 Pro 的 API 要花多少钱?
kimi-k3.1-pro 每百万输入 token $2.00,每百万输出 token $10.00,每百万缓存命中输入 token $0.20。缓存写入为 $2.00(5 分钟 TTL)或 $4.00(1 小时 TTL)。定价在 1,048,576 token 的上下文窗口内统一。
Kimi K3.1 Pro Highspeed 是什么,值得多花钱吗?
据 Moonshot 说,Highspeed 是同一个模型,速度快 2–3 倍。它每百万 token 输入 $4.00、输出 $20.00,是标准价格的两倍,缓存命中输入价格仍为 $0.20。当有人在等输出时它才有意义;批处理工作用标准版更便宜。
Kimi K3.1 Pro 的开放权重发布了吗?
截至 2026 年 10 月 29 日尚未发布。Moonshot 表示完整权重将在 2026 年 11 月 4 日前发布。我们检查时 Hugging Face 仓库返回 HTTP 401。截止日期之后请再查看仓库,确认实际发布、许可证与文件。
Kimi K3.1 Pro 比 Claude Opus 5.5 更好吗?
取决于任务。在 Moonshot 自己的图表上,它在十四行中领先六行,在另一些行上落后于 Opus 5.5,其中 Terminal-Bench 4.0 为 65.7 对 66.4。Artificial Analysis 在发布时的指数上把它排第四,55 对 Opus 5.5 的 58;在指数 v5 上它得 46,Opus 5.5 为 58。
哪些基准数字是独立的?
只有 Artificial Analysis 的结果是独立的:智能指数、GDPval-AA、67% 的 Terminal-Bench 4.0 以及 v5 的数字。Moonshot 发布的图表、Kimi Code Bench、Hallu Bench Hard 与 xdev-bench-hard 都是厂商自报。
如何用 Python 调用 Kimi K3.1 Pro?
使用 OpenAI SDK,base_url 设为 https://api.moonshot.ai/v1,填入你的 Kimi API 密钥,模型为 kimi-k3.1-pro。reasoning_effort 可设为 low、high 或 max,默认是 max。多轮对话和工具调用时,要把完整的 assistant 消息发回去,而不只是它的 content。
可以在 Claude Code 或 Codex 里使用 Kimi K3.1 Pro 吗?
Moonshot 两者都有文档。对于 Claude Code,Kimi Code 文档给出了一份 settings.json,把 ANTHROPIC_BASE_URL 设为 https://api.kimi.ai/coding/,模型为 k3.1-pro[1m]。对于 Codex,config.toml 使用 base_url https://api.moonshot.ai/v1、模型 kimi-k3.1-pro 和 wire_api responses。
Kimi K3.1 Pro 在 OpenRouter 上有吗?
有,标识为 moonshotai/kimi-k3.1-pro,每百万 token 输入 $2.00、输出 $10.00、缓存读取 $0.20,另有 $4.00 和 $20.00 的 Highspeed 路径。页面上的延迟与吞吐是时点统计。
Kimi K3.1 Pro 订阅限额出了什么问题?
2026 年 10 月 25 日,Moonshot 为 K3.1 Pro 订阅套餐上的速率限制和不必要的额度消耗道歉,给每位订阅者一次性重置 25% 的月度额度,并表示正在减少不必要的子智能体调用和输出长度。
来源
来源核对于 2026 年 10 月 28–29 日。
- X 上的 Kimi — 发布帖、API 与定价帖、10 月 25 日额度道歉帖以及发布视频帖
- Introducing Kimi K3.1 Pro — Moonshot 技术博客(规格、基准、脚注、网络安全章节、可用性)
- Kimi K3.1 Pro 定价 — 会员套餐与 API 费用
- Kimi K3.1 Pro API 快速上手与充值与速率限制
- Kimi Code:Claude Code 配置、Kimi API 平台:Claude Code 指南、Kimi API 平台:Codex 指南与 Kimi Code 会员
- Artificial Analysis — Kimi K3.1 Pro 发布日基准与智能指数 v5 公告(2026 年 10 月 27 日)
- OpenRouter — moonshotai/kimi-k3.1-pro
- Hugging Face — moonshotai/Kimi-K3.1-Pro(状态检查,2026 年 10 月 29 日返回 HTTP 401)
相关阅读:Kimi K3 开放前沿智能(英文)、Muse Wonder 指南、Claude Opus 5.5 对比 Sonnet 5.5 编码与 GPT-6 Astra、Sol、Luna 定价与用量。